研究者: 12項目の患者報告アウトカム(PRO)質問票を作っています。「身体機能」と「心理的負担」の2つを測るつもりなので、多次元項目反応理論(MIRT)で分析しようと思いました。ネットで見つけたコードを動かしたら
itemtype = "2PL"でエラーが出るし、プロマックス回転をかけても何も変わらないし……。因子負荷量0.3とかQ3が0.2とか、基準の根拠もよく分かりません。
統計ER: よくある「つまずき」が一度に出ていますね。5件法なら
2PLではなく段階反応モデル(graded)を使います。回転が効かないのは、確認的モデルには回転という操作がそもそも存在しないからです。基準値も「お守り」として使うのではなく、意味を知ったうえで使いましょう!
多次元項目反応理論(Multidimensional Item Response Theory: MIRT)は、1つの質問票が複数の潜在特性を測っているときに、項目ごとの「測る力」と「難しさ(反応しにくさ)」を同時に推定できる手法である。臨床研究では、PRO尺度やQOL尺度の開発・短縮版作成・妥当性検証の場面で出会うことが多い。
本記事では、MIRTの基本的な考え方を整理したうえで、探索的モデルと確認的モデルの違い(回転が必要なのはどちらか)、因子負荷量0.3という目安の扱い方、局所独立性とQ3統計量の読み方を解説する。そして、Rの mirt パッケージ(Chalmers, 2012)で、次元数の確認からモデル適合・局所依存の検出と対処・因子スコアの算出までを一通り実行する。
MIRTとは:1本の物差しから「地図の座標」へ
通常の(1次元の)項目反応理論(IRT)は、回答者の特性を1本の物差し $\theta$ の上に並べる。これに対してMIRTは、特性を複数の軸 $(\theta_1, \theta_2, \dots)$ で表す。1本の物差しで「身長」だけを測るのではなく、地図上の「緯度と経度」で位置を表すようなものである。
5件法などの順序カテゴリ項目でよく使われる段階反応モデル(graded response model; Samejima, 1969)を2次元に拡張すると、項目 $j$ でカテゴリ $k$ 以上を選ぶ確率は次のように書ける。
$$P(X_j \ge k \mid \theta_1, \theta_2) = \frac{1}{1 + \exp\{-(a_{j1}\theta_1 + a_{j2}\theta_2 + d_{jk})\}}$$
$a_{j1}, a_{j2}$ は各次元に対する識別力(傾き)、$d_{jk}$ はカテゴリの境目ごとの切片である。1つの項目が1つの次元だけに負荷する構造(項目間多次元性、between-item multidimensionality)では、各項目の $a$ のうち1つだけが0でない値をとる。複数の次元に同時に負荷する構造は項目内多次元性(within-item multidimensionality)と呼ばれる。
実は、この式は順序カテゴリデータの因子分析(項目因子分析)と数学的にほぼ同じものである(Wirth & Edwards, 2007)。そのため、MIRTの出力には「因子負荷量」「因子回転」「因子間相関」といった因子分析の用語がそのまま登場する。IRTの言葉(識別力・切片)と因子分析の言葉(負荷量)の両方で結果を読めるのが、MIRTの便利なところである。
臨床領域では、米国NIHのPROMIS(Patient-Reported Outcomes Measurement Information System)がIRTを用いた項目バンクの構築・評価の方針を示しており、その中で多次元モデルや局所依存の評価にも触れている(Reeve et al., 2007)。ただし、「MIRTが標準」というより、1次元IRTで足りるかを確かめ、足りなければ多次元モデルを検討するという位置づけで理解しておくとよい。
※コラム:2PLと段階反応モデル(graded)の違い
2PL(2パラメータ・ロジスティック)モデルは「正解/不正解」のような2値項目のためのモデルである。5件法のような多値項目にitemtype = "2PL"を指定すると、mirtは「Item 1 requires exactly 2 unique categories」というエラーで止まる。多値項目には"graded"(段階反応モデル)を使い、2値項目なら"2PL"を使う。段階反応モデルは2PLを「カテゴリの境目ごとに積み重ねた」ものと考えればよい。
探索的MIRTと確認的MIRT:回転が必要なのはどちらか
MIRTには、因子構造をデータから探す探索的モデルと、研究者が「どの項目がどの因子に属するか」を事前に指定する確認的モデルがある。
| 探索的MIRT | 確認的MIRT | |
|---|---|---|
mirt() の指定 | model = 2(因子数だけ指定) | model = "PF = Q1-Q6 …"(構造を指定) |
| 因子回転 | 必要(解釈のため) | 不要・不可能(構造が固定済み) |
| 因子間相関 | 斜交回転をすれば推定される | COV = PF*MH と書かない限り0に固定 |
| 主な用途 | 尺度開発の初期、構造が未確定のとき | 想定した構造の検証、本番の解析 |
探索的モデルの解は、軸をどの向きに回しても尤度(データへの当てはまり)は変わらない。地図をどの向きに回しても地形そのものは変わらないのと同じである。ただし、北が上になるように回した方が読みやすい。因子回転は、この「読みやすい向き」を探す操作である。
プロマックス回転(Hendrickson & White, 1964)は、因子間の相関を許す斜交回転の代表格である。心理・健康関連の特性同士は相関することが多いため、直交回転(バリマックスなど)より斜交回転が選ばれることが多い。なお、mirt の summary() の既定の回転は同じく斜交回転の "oblimin" であり、rotate = "promax" と指定すればプロマックス回転も使える。
一方、確認的モデルでは「Q1〜Q6は身体機能にだけ負荷する」と研究者が決めているので、回す余地がない。確認的モデルの結果に summary(mod, rotate = "promax") と書いても、エラーにはならないまま回転は行われず、指定した構造の推定値がそのまま表示されるだけである。そして見落とされやすいのが、確認的モデルでは COV = PF*MH を書かない限り因子間相関が0に固定される点である。「プロマックス回転をかけたのに因子間相関が0のまま」という現象の正体はこれである。
因子負荷量「0.3以上」はどう扱うか
因子負荷量(標準化された負荷量)は、項目と因子の結びつきの強さを相関係数のような尺度で表したものである。「0.3以上(あるいは0.32以上、0.4以上)なら、その因子に負荷していると見なす」という目安は広く使われている。ただしこれは統計的検定ではなく、解釈のための慣習である。
MIRTでこの目安を使うときにまず押さえたいのは、mirt が推定する識別力 $a$ そのものは因子負荷量ではないことである。識別力 $a$ はロジスティック関数の目盛りの値で、上限がない。summary() はこれを正規オージブ尺度の因子負荷量 $\lambda$ に換算して表示している。正規オージブとは、ロジスティック関数の代わりに正規分布を使ってS字カーブを描く流儀のことで、その目盛りでの負荷量は通常の因子分析の負荷量と同じ物差しになる(詳しくは下のコラム)。つまり、0.3の目安を当てはめる相手は、識別力 $a$ ではなく summary() に表示される負荷量 $\lambda$ である。
1項目が1因子だけに負荷する場合、換算式は $\lambda = a / \sqrt{1.702^2 + a^2}$ である。例えば $a = 1.53$ なら $\lambda = 1.53 / \sqrt{1.702^2 + 1.53^2} \approx 0.67$ となる(後半のRの例のQ1がちょうどこの値である)。負荷量 $\lambda$ は−1〜1に収まるので、項目間の比較にも負荷量の方が直感的である。
- 負荷量0.3は、その因子で項目の分散の約9%($0.3^2$)しか説明できないことを意味する。尺度開発の最終段階では、より高い値(例えば0.4〜0.5以上)を求めることも多い
- 同じ負荷量でも、サンプルサイズが小さいほど推定のぶれは大きい。境界付近の項目は「0.29だから削除」と機械的に判断せず、内容的妥当性と合わせて判断する
- 探索的モデルでは、主たる因子への負荷が十分かだけでなく、他の因子への交差負荷が小さいかも確認する
summary(..., suppress = 0.3)は、絶対値0.3未満の負荷量を表示上隠すだけで、推定やモデルからその負荷を取り除くわけではない
※コラム:「正規オージブ尺度の因子負荷量」とは
項目反応の確率を表すS字カーブには、2つの流儀がある。1つは本記事の式で使ったロジスティック関数、もう1つは標準正規分布の累積分布関数を使う正規オージブ(normal ogive)である。オージブ(ogive)は「累積分布のS字曲線」を指す言葉である。2つのカーブは形がよく似ていて、ロジスティック側の横軸を1.702で割ると、ほぼぴったり重なる。センチとインチのように、同じものを違う目盛りで測っているだけと考えればよい。正規オージブの世界では、各項目の背後に「連続的な正規分布の反応の強さ」があり、それがいくつかの閾値で区切られて0〜4点のカテゴリになる、と考える。このときの因子負荷量は、その背後の連続的な反応の強さと因子との相関に当たる。順序カテゴリデータの因子分析(ポリコリック相関に基づく因子分析)と同じ物差しなので、「負荷量0.3」などの目安をそのまま当てはめられる。
局所独立性:IRTの土台となる仮定
局所独立性(local independence)とは、「潜在特性の値が同じ人だけを集めれば、項目同士の回答は互いに無関係になる」という仮定である。言い換えると、項目間の相関はすべて潜在特性で説明できる、ということである。
クラスの成績で例えると、「数学の学力」が同じ生徒だけを集めたら、計算問題の正誤と図形問題の正誤はもう関係しないはずだ、という考え方である。この仮定が破れている状態を局所依存(local dependence: LD)と呼ぶ。
局所依存が起こりやすい場面
- 文言や内容がよく似た項目:「階段を上るのがつらい」と「坂道を上るのがつらい」のように、ほぼ同じことを尋ねている項目のペア
- 同じ場面・同じ素材を共有する項目:同じ文章やグラフを読んで答える設問群(テストレット)、同じ生活場面についての一連の質問
- 前の設問への回答が後の設問に影響する項目:設問1が解けないと設問2も解けない、といった連鎖構造
局所依存を放置すると、似た項目のペアが「見かけの因子」を作ったり、その項目の識別力・負荷量が過大に推定されたり、信頼性が過大評価されたりする。後半のRの例で、実際にこの現象を確認する。
Q3統計量と、その「0.2」という基準の注意点
局所依存の代表的な指標が、Yen(1984)のQ3統計量である。各回答者の観測値からモデルの期待値を引いた残差を項目ごとに求め、項目ペアごとにその相関を計算する。mirt では residuals(mod, type = "Q3") で求められる。もう1つの代表的な指標が、項目ペアのクロス表で観測度数と期待度数のずれを見るLD $\chi^2$(Chen & Thissen, 1997)で、residuals(mod, type = "LD") で求められる。
Q3については「絶対値0.2以上なら局所依存を疑う」という基準がよく使われる。しかし、Christensen, Makransky & Horton(2017)は、次の点に注意を促している。
- 局所独立性が成り立っていても、Q3の平均は0ではなく負の値になる。特に1因子あたりの項目数が少ないと、この負の偏りは大きい
- そのため、一律の0.2という基準はデータの特徴(項目数など)を反映しない
- 代わりに、Q3の平均からのずれ(Q3の最大値−Q3の平均。Q3*)で判断し、「平均より0.2以上大きい」残差相関を局所依存のサインとする考え方を提案している(厳密にはパラメトリック・ブートストラップでデータごとの臨界値を求めることを推奨)
つまり、0.2は「絶対的な合格ライン」ではなく、周りの残差相関と比べて飛び抜けて大きいペアを探すための目安と考えるのがよい。
局所依存が見つかったら
- 原因を内容面から考える:文言の重複、共通の場面など、なぜ依存しているかを説明できるかを確認する
- 項目の削除・統合:ほぼ同じ内容を尋ねている項目なら、片方を削除する、あるいは合計点を1項目として扱う
- モデルで依存を表現する:依存している項目群だけが負荷する「特殊因子」を追加し、依存の分を主たる因子から切り離す(下のコラム参照)
※コラム:特殊因子・テストレットモデル・バイファクターモデル
「階段を上るのがつらい」と「坂道を上るのがつらい」の回答がよく似ているのは、身体機能が低いからだけではない。どちらも「上り坂」という同じ場面を尋ねているからでもある。この「2項目だけが共有する余計な共通要因」を、モデルの中に専用の因子として置いたものが特殊因子(specific factor)である。特殊因子は主たる因子(身体機能・心理的負担)とは無相関とする。こうすると、似た文言による結びつきは特殊因子が引き受け、主たる因子には「本当に身体機能を反映する部分」だけが残る。洗濯物で例えると、デリケート素材の2枚を別のネットに分けて洗うようなものである。同じ洗濯槽(モデル)には入れたまま、他の洗濯物(主たる因子)と絡まないようにする。
テストレットモデルは、もともと学力テストで「同じ長文を読んで答える設問群(テストレット)」を扱うために考えられたモデルである。テストレットごとに特殊因子を1つ置き、そのテストレット内の項目は特殊因子への負荷を等しく(または比例するように)制約するのが典型的な形である。バイファクターモデルは、すべての項目が1つの一般因子に負荷し、さらに各項目がいずれか1つの特殊因子にも負荷する構造である(Reise, 2012)。テストレットモデルは、バイファクターモデルに制約を加えた特殊な場合とみなせる。後半のStep 7では、主たる2因子に加えてQ5・Q6だけの特殊因子を1つ置き、2項目の負荷を等しく制約した。これはテストレットモデルと同じ発想である。
MIRTを使う前に確認したいこと
- 次元数の見当:理論的に想定する次元数を、ポリコリック相関(順序データ用の相関)に基づく平行分析(乱数データと比べて因子数を決める方法)などで確認する(詳しくはStep 2のコラム)。ただし平行分析も1つの手がかりにすぎず、解釈可能性や理論と合わせて決める
- 1因子あたりの項目数:1つの因子を安定して推定・解釈するには、少なくとも3項目程度は欲しい。2項目しかない因子は推定が不安定になりやすい
- サンプルサイズ:次元数・項目数・カテゴリ数が増えるほど、安定した推定に必要な人数は増える。数百人規模が一つの目安になるが、低頻度のカテゴリが多い場合はさらに必要になる
- モデル適合度:モデル全体の適合は限定情報適合度統計量($M_2$ 系; Maydeu-Olivares & Joe, 2006)とRMSEA・SRMSR・CFI・TLIで、項目ごとの適合は $S\text{-}X^2$ で確認する。モデル同士の比較には尤度比検定やAIC・BICを使う
- 局所独立性:上で述べたQ3やLD $\chi^2$ で確認する
RでMIRTを実践する:mirtパッケージによる9ステップ
ここからは、架空の慢性疾患患者500人が回答した12項目・5件法(0〜4点、点数が高いほど困りごとが大きい)の質問票を想定して解析する。Q1〜Q6は「身体機能の低下(PF)」、Q7〜Q12は「心理的負担(MH)」を測る項目で、2つの特性には相関がある。さらに、Q5「階段を上るのがつらい」とQ6「坂道を上るのがつらい」は文言がよく似ているため、2項目だけが共有する局所依存をあえて仕込んである。
以下の出力は、R 4.5.3、mirt 1.47、psych 2.6.9で実行した結果である。
準備:パッケージの読み込み
# install.packages(c("mirt", "psych", "GPArotation"))
library(mirt)
library(psych)
GPArotation は、mirt が斜交回転(oblimin・promaxなど)の計算に内部で使うパッケージである。読み込みは不要だが、インストールはしておく。
Step 1:疑似データの作成
# 12項目・5件法(0〜4点)の患者報告アウトカム質問票を想定
#   Q1〜Q6 :身体機能(PF)
#   Q7〜Q12:心理的負担(MH)
#   PFとMHの相関は0.4
#   Q5「階段を上るのがつらい」とQ6「坂道を上るのがつらい」は文言が似ており、
#   共通の「余計な要因」(局所依存)を持たせている
set.seed(2026)
n <- 500
J <- 12
a <- matrix(0, J, 3)
a[1:6, 1]  <- c(1.8, 1.6, 1.4, 1.5, 1.7, 1.6)  # 身体機能への識別力
a[7:12, 2] <- c(2.0, 1.5, 1.7, 1.3, 1.6, 1.8)  # 心理的負担への識別力
a[5:6, 3]  <- 1.6                              # Q5とQ6だけが共有する局所依存
d <- cbind(seq( 2.5,  1.5, length = J),
           seq( 1.0,  0.0, length = J),
           seq(-0.5, -1.0, length = J),
           seq(-2.0, -2.8, length = J))         # 段階反応モデルの切片
sigma <- diag(3)
sigma[1, 2] <- sigma[2, 1] <- 0.4
dat <- as.data.frame(simdata(a, d, n, itemtype = "graded", sigma = sigma))
names(dat) <- paste0("Q", 1:J)
head(dat)
simdata() は mirt に付属するデータ生成関数で、識別力行列 a・切片行列 d・因子間の相関行列 sigma を与えると、そのモデルに従う回答データを作る。3列目の因子はQ5とQ6だけに負荷する「余計な共通要因」で、これが局所依存の正体である。
Step 2:次元数の見当をつける(平行分析)
fa.parallel(dat, cor = "poly", fa = "fa")Parallel analysis suggests that the number of factors = 2 and the number of components = NA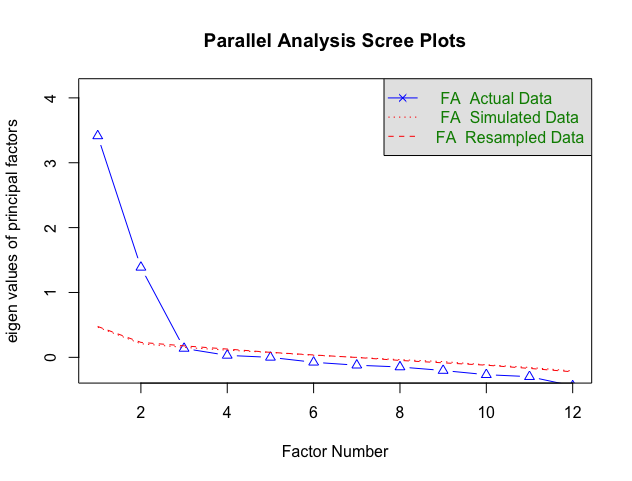
順序カテゴリデータなので、cor = "poly" でポリコリック相関に基づく平行分析を行う。想定どおり2因子が示唆された。
※コラム:ポリコリック相関に基づく平行分析
ポリコリック相関は、順序カテゴリ変数同士の相関の測り方である。0〜4点の回答の背後に、正規分布に従う連続的な「反応の強さ」があり、それがいくつかの閾値で区切られて5段階になったと考える。そして、観測された点数そのものではなく、背後にある連続的な変数同士の相関を推定する。5件法の点数にそのままピアソン相関を使うと、段階に丸められた分だけ相関が小さめに出やすい。ポリコリック相関はこの「丸めによる目減り」を補正する。平行分析(Horn, 1965)は、因子数を決めるための手法である。実データの相関行列から固有値(各因子が説明する分散の大きさ)を求める。同時に、同じ人数・同じ項目数で項目間に何の関係もない乱数データを何度も作り、その固有値も求める。そして、乱数データの固有値を上回る因子だけを「意味のある因子」として数える。
騒がしい会場で人の声を聞き分けるとき、まず「会場のざわめき(乱数データ)」の大きさを測っておき、それより大きく聞こえる声だけを「誰かが話している」と判断するイメージである。固有値が1以上の因子を残すというカイザー基準は、ざわめきの大きさを考えずに一律の音量で区切るようなもので、因子を多く見積もりすぎやすい。
psych::fa.parallel()にcor = "poly"を指定すると、実データの固有値をポリコリック相関から計算した平行分析になる。
Step 3:探索的MIRT(項目因子分析)
mod1 <- mirt(dat, 1, itemtype = "graded", verbose = FALSE)
mod2 <- mirt(dat, 2, itemtype = "graded", verbose = FALSE)
anova(mod1, mod2)

summary(mod2, rotate = "oblimin", suppress = 0.3)  # mirtの既定の回転
summary(mod2, rotate = "promax",  suppress = 0.3)  # プロマックス回転
AIC SABIC HQ BIC logLik X2 df p
mod1 18208.39 18270.82 18307.62 18461.26 -9044.194
mod2 17767.93 17841.81 17885.35 18067.17 -8812.965 462.458 11 01因子モデルより2因子モデルの方が、AIC・BICとも小さく、尤度比検定でも当てはまりが改善している。次に、2因子モデルを回転して負荷量を見る。
Rotation:  oblimin

Rotated factor loadings:

       F1    F2    h2
Q1        0.603 0.408
Q2        0.628 0.428
Q3        0.532 0.357
Q4        0.562 0.436
Q5        0.746 0.524
Q6        0.799 0.596
Q7  0.630       0.436
Q8  0.532       0.289
Q9  0.711       0.500
Q10 0.585       0.351
Q11 0.671       0.449
Q12 0.723       0.505

Factor correlations:

      F1 F2
F1 1.000
F2 0.325  1
Rotation: promax
Rotated factor loadings:
F1 F2 h2
Q1 0.612 0.408
Q2 0.639 0.428
Q3 0.536 0.357
Q4 0.563 0.436
Q5 0.769 0.524
Q6 0.825 0.596
Q7 0.641 0.436
Q8 0.545 0.289
Q9 0.730 0.500
Q10 0.599 0.351
Q11 0.688 0.449
Q12 0.744 0.505
Factor correlations:
F1 F2
F1 1.00
F2 0.43 1どちらの回転でも、Q7〜Q12が第1因子(F1=心理的負担)、Q1〜Q6が第2因子(F2=身体機能の低下)に0.5以上で負荷し、0.3以上の交差負荷はない。探索的モデルでは因子の番号(F1・F2)は推定のたびに入れ替わりうるので、名前は負荷のパターンを見てから付ける。
注目したいのは2点である。1つは、負荷のパターンは同じでも、因子間相関は回転法によって0.33(oblimin)と0.43(promax)のように変わること。斜交回転の因子間相関は回転法に依存するので、論文には使った回転法を必ず明記する。もう1つは、Q5・Q6の負荷量(0.75〜0.83)が他の身体機能項目(0.53〜0.64)より目立って大きいことである。これは「良い項目」のサインに見えるが、実は仕込んだ局所依存の影響である(Step 6で確認する)。
Step 4:確認的MIRT(因子構造を指定)
model_cfa <- "
  PF = Q1-Q6
  MH = Q7-Q12
  COV = PF*MH
"
mod_cfa <- mirt(dat, model_cfa, itemtype = "graded", verbose = FALSE)
summary(mod_cfa)

# 参考:COV行を書かないと因子間相関は0に固定される
mod_cfa0 <- mirt(dat, "PF = Q1-Q6\nMH = Q7-Q12", itemtype = "graded", verbose = FALSE)
anova(mod_cfa0, mod_cfa)
PF MH h2
Q1 0.670 0.448
Q2 0.683 0.466
Q3 0.612 0.374
Q4 0.672 0.451
Q5 0.659 0.434
Q6 0.698 0.487
Q7 0.665 0.443
Q8 0.545 0.297
Q9 0.707 0.500
Q10 0.593 0.351
Q11 0.665 0.442
Q12 0.705 0.497
Factor correlations:
PF MH
PF 1.000
MH 0.398 1 AIC SABIC HQ BIC logLik X2 df p
mod_cfa0 17833.01 17895.45 17932.24 18085.89 -8856.507
mod_cfa 17783.70 17847.17 17884.58 18040.79 -8830.849 51.316 1 0モデル式では、Q1-Q6 のように項目名で範囲を指定でき、1-6 のように列番号で書くこともできる。COV = PF*MH が因子間相関を推定するための指定で、これを省いたモデル(mod_cfa0)は因子間相関が0に固定される。両者を比べると、相関を推定したモデルの方が明らかに当てはまりがよい(推定された因子間相関は0.40)。確認的モデルでは構造が固定されているので、summary() に回転の指定は不要である。
Step 5:モデル適合度
M2(mod_cfa, type = "C2")
itemfit(mod_cfa)
M2 df p RMSEA RMSEA_5 RMSEA_95 SRMSR TLI CFI
stats 168.091 53 0 0.066 0.055 0.077 0.053 0.945 0.956 item S_X2 df.S_X2 RMSEA.S_X2 p.S_X2
1 Q1 91.479 97 0.000 0.639
2 Q2 103.688 94 0.014 0.232
...
5 Q5 106.805 99 0.013 0.278
6 Q6 101.349 95 0.012 0.309
...
12 Q12 93.421 91 0.007 0.410mirt では、カテゴリを併合しない本来の $M_2$(type = "M2")は2値項目にしか使えない。そのため、多値項目に M2() を引数なしで使うと、既定でカテゴリを併合した $M_2^*$(type = "M2*")が計算される。ここでは、2変量の部分だけを併合する $C_2$ 統計量(type = "C2"; Cai & Monroe, 2014)を使った。なお、出力の列名は統計量の種類にかかわらず M2 と表示されるので、どの type を指定したかはコード側で確認する。RMSEAは0.066(90%信頼区間 0.055〜0.077)で、「許容範囲だが良好とまでは言えない」水準である。項目ごとの $S\text{-}X^2$ には目立った不適合はない。
なお、同じモデルに既定の M2(mod_cfa)(つまり $M_2^*$)を使うと、$M_2^* = 18.8$(df = 17)、p = 0.34、RMSEA 0.015となり、不適合はほとんど検出されなかった。1つの適合度指標だけで「適合良好」と判断しないことが大切で、次のステップの局所依存の確認がまさにその補完になる。
Step 6:局所独立性の確認(Q3)
q3 <- residuals(mod_cfa, type = "Q3", verbose = FALSE)
round(q3, 2)
q3_pairs <- q3[lower.tri(q3)]
mean(q3_pairs)                  # Q3の平均(0ではなく負になる)
q3_star <- q3 - mean(q3_pairs)  # 平均からのずれ(Christensen et al., 2017)
diag(q3_star) <- NA
which(q3_star > 0.2, arr.ind = TRUE)
Q1 Q2 Q3 Q4 Q5 Q6 Q7 Q8 Q9 Q10 Q11 Q12
Q1 1.00 -0.11 -0.11 -0.04 -0.27 -0.23 -0.14 -0.01 -0.04 0.02 0.02 0.09
Q2 -0.11 1.00 -0.03 -0.11 -0.24 -0.28 0.08 -0.01 0.01 -0.09 -0.04 -0.04
Q3 -0.11 -0.03 1.00 -0.17 -0.21 -0.23 -0.01 -0.07 0.01 -0.01 0.09 0.01
Q4 -0.04 -0.11 -0.17 1.00 -0.28 -0.27 0.05 0.00 0.00 0.06 0.01 -0.04
Q5 -0.27 -0.24 -0.21 -0.28 1.00 0.25 0.02 -0.05 -0.03 -0.02 -0.05 -0.05
Q6 -0.23 -0.28 -0.23 -0.27 0.25 1.00 0.00 0.06 -0.08 -0.02 -0.08 -0.07
Q7 -0.14 0.08 -0.01 0.05 0.02 0.00 1.00 -0.11 -0.14 -0.17 -0.27 -0.15
Q8 -0.01 -0.01 -0.07 0.00 -0.05 0.06 -0.11 1.00 -0.20 -0.04 -0.03 -0.19
Q9 -0.04 0.01 0.01 0.00 -0.03 -0.08 -0.14 -0.20 1.00 -0.14 -0.17 -0.20
Q10 0.02 -0.09 -0.01 0.06 -0.02 -0.02 -0.17 -0.04 -0.14 1.00 -0.15 -0.14
Q11 0.02 -0.04 0.09 0.01 -0.05 -0.08 -0.27 -0.03 -0.17 -0.15 1.00 -0.15
Q12 0.09 -0.04 0.01 -0.04 -0.05 -0.07 -0.15 -0.19 -0.20 -0.14 -0.15 1.00
> mean(q3_pairs)
[1] -0.07616101
> which(q3_star > 0.2, arr.ind = TRUE)
row col
Q6 6 5
Q5 5 6Q5とQ6の残差相関は0.25で、全ペアの平均(−0.076)より約0.33大きい。平均からのずれが0.2を超えたのはこの1ペアだけで、仕込んだ局所依存を正しく検出できている。
この表には、もう1つ大事な情報がある。同じ因子に属する項目同士の残差相関の多く(例えばQ7〜Q12の間)が、−0.1〜−0.3という負の値になっていることである。1因子あたり6項目と少ないため、局所独立でもQ3が負に偏るのである。もしこのデータで「Q3の絶対値0.2以上」を機械的に当てはめると、多くの負の残差相関まで「局所依存の疑い」として拾ってしまう。平均からのずれで見る方法の方が、目的にかなった判断ができる。
Step 7:局所依存への対処(特殊因子の追加)
model_ld <- "
  PF = Q1-Q6
  MH = Q7-Q12
  S56 = Q5, Q6
  COV = PF*MH
  CONSTRAIN = (Q5, Q6, a3)
"
mod_ld <- mirt(dat, model_ld, itemtype = "graded", verbose = FALSE)
anova(mod_cfa, mod_ld)
summary(mod_ld)
M2(mod_ld, type = "C2")
AIC SABIC HQ BIC logLik X2 df p
mod_cfa 17783.70 17847.17 17884.58 18040.79 -8830.849
mod_ld 17692.75 17757.27 17795.29 17954.06 -8784.376 92.947 1 0 PF MH S56 h2
Q1 0.691 0.478
Q2 0.712 0.507
Q3 0.628 0.395
Q4 0.701 0.491
Q5 0.552 0.612 0.679
Q6 0.594 0.591 0.701
Q7 0.665 0.442
...
Factor correlations:
PF MH S56
PF 1.000
MH 0.429 1
S56 0.000 0 1 M2 df p RMSEA RMSEA_5 RMSEA_95 SRMSR TLI CFI
stats 67.517 52 0.073 0.024 0 0.04 0.036 0.992 0.994Q5とQ6だけが負荷する特殊因子 S56 を加えたモデルである。特殊因子は他の因子と無相関とし、2項目しかないので識別のために2項目の傾きを等しく制約している(CONSTRAIN)。これはテストレットモデルと同じ考え方である。
結果は明快である。AIC・BICとも大きく改善し、RMSEAは0.066から0.024に下がった。さらに、Q5・Q6の身体機能(PF)への負荷量は0.66・0.70から0.55・0.59に下がった。局所依存を無視したモデルは、「2項目だけが共有する似た文言の効果」まで身体機能の強さと取り違え、Q5・Q6を実際以上に「よく測れる項目」と評価していたことになる。
実際の尺度開発では、モデルで依存を表現するか、Q5とQ6のどちらかを削除するかを、内容的妥当性と合わせて検討する。2項目がほぼ同じことを尋ねているなら、どちらかを削除した方がシンプルで回答者の負担も減る。以降のステップは、元の確認的モデル(mod_cfa)で説明を続ける。
Step 8:パラメータの解釈
coef(mod_cfa, simplify = TRUE)$items
data.frame(MDISC = MDISC(mod_cfa), round(MDIFF(mod_cfa), 2))
a1 a2 d1 d2 d3 d4
Q1 1.534419 0.000000 2.365458 1.17165952 -0.2419350 -1.686931
Q2 1.590042 0.000000 2.534790 0.70819580 -0.5550758 -2.377784
...
Q12 0.000000 1.691522 1.528351 0.09995998 -1.0835771 -2.905915 MDISC MDIFF_1 MDIFF_2 MDIFF_3 MDIFF_4
Q1 1.534419 -1.54 -0.76 0.16 1.10
Q2 1.590042 -1.59 -0.45 0.35 1.50
...
Q12 1.691522 -0.90 -0.06 0.64 1.72a1・a2 は各因子に対する識別力、d1〜d4 は5つのカテゴリの間にある4つの境目(0|1、1|2、2|3、3|4)の切片である。段階反応モデルでは、項目1つにつき「困難度」が1つではなく、カテゴリの境目の数だけある点に注意したい。
- 識別力 $a$:大きいほど、特性のわずかな違いで回答が大きく変わる、つまり人を鋭敏に区別できる項目である。項目特性曲線の傾きに対応する
- 切片 $d$:
mirtは $a\theta + d$ という切片型で推定する。値が大きいほど、そのカテゴリ以上を選びやすい(=反応しやすい) - 1次元の困難度 $b$:1次元モデルなら $b = -d/a$ で、その境目を50%の確率で越える特性値になる。
coef(mod, IRTpars = TRUE)で表示できるのは1次元モデルの場合である - 多次元の場合(MDISC・MDIFF):多次元では、識別力を1つにまとめた $\text{MDISC} = \sqrt{\sum_k a_k^2}$ と、多次元困難度 $\text{MDIFF}_k = -d_k/\text{MDISC}$ を使う(Reckase, 2009)。本データのように1項目1因子の構造では、MDISCはその因子の $a$ と一致し、MDIFFは1次元の $b$ と同じ意味になる
識別力と因子負荷量の対応:Q1の識別力 $a = 1.53$ を前半の換算式 $\lambda = a / \sqrt{1.702^2 + a^2}$ に入れると $\lambda \approx 0.67$ となり、Step 4の summary(mod_cfa) に表示されたQ1の負荷量0.670と一致する。coef() の識別力と summary() の負荷量は、同じ情報を違う目盛りで表したものである。
例えばQ1のMDIFFは −1.54、−0.76、0.16、1.10である。身体機能の低下の程度が平均より1.54SD低い人でも、50%の確率で「1点以上」を選ぶ。一方、「4点(最も困っている)」を選ぶ確率が50%に達するのは、平均より1.10SD高い人である。
Step 9:因子スコア(潜在特性値)と信頼性
fs <- fscores(mod_cfa, method = "EAP", full.scores.SE = TRUE)
head(fs)
empirical_rxx(fs)
PF MH SE_PF SE_MH
[1,] 0.7691873 1.6640378 0.4233182 0.4532055
[2,] -0.5362304 -0.6184299 0.4637105 0.4186779
[3,] 0.7361811 -0.1311913 0.4340923 0.3937074
...
PF MH
0.8027752 0.7945553fscores() は回答者ごとの潜在特性値を推定する。ここではEAP(事後分布の平均)推定を用い、full.scores.SE = TRUE で標準誤差も出力した。empirical_rxx() は、因子スコアの分散と標準誤差から求める経験的信頼性で、PFが0.80、MHが0.79であった。
IRTでは、測定の精度は特性値の水準によって異なる(項目が集中している範囲では精度が高い)。1つの信頼性係数だけでなく、標準誤差(SE_PF など)が回答者ごとに異なることも意識しておきたい。
論文でそのまま使える英文テンプレート
以下の数値は本記事の疑似データでの結果である。実際の論文では、ご自身の解析結果に置き換えてほしい。
Methods
Item responses were analyzed using multidimensional item response theory (MIRT) with the graded response model, implemented in the mirt package (version 1.47; Chalmers, 2012) in R (version 4.5.3). The number of dimensions was first examined by parallel analysis based on polychoric correlations. An exploratory two-dimensional model was estimated, and the loadings were obliquely rotated (oblimin and promax rotations) to aid interpretation; loadings of 0.30 or greater were considered salient. A confirmatory two-dimensional model, in which items 1–6 loaded on physical function and items 7–12 on psychological burden and the two factors were allowed to correlate, was then fitted. Overall model fit was assessed with the C2 statistic, RMSEA, SRMSR, CFI, and TLI, and item fit with the S-X2 statistic. Local dependence was evaluated with Yen’s Q3 statistic; item pairs whose Q3 exceeded the average Q3 by more than 0.20 were flagged (Christensen et al., 2017).
Results
Parallel analysis suggested two dimensions. In the confirmatory two-dimensional model, all standardized loadings ranged from 0.55 to 0.71, and the correlation between the two factors was 0.40. Model fit was acceptable (C2 = 168.1, df = 53; RMSEA = 0.066, 90% CI 0.055–0.077; SRMSR = 0.053; CFI = 0.956; TLI = 0.945). One item pair (items 5 and 6, which had similar wording) showed local dependence (Q3 = 0.25, compared with an average Q3 of −0.08). Adding a specific factor for this item pair improved model fit (RMSEA = 0.024; CFI = 0.994) and reduced the loadings of items 5 and 6 on physical function from 0.66 and 0.70 to 0.55 and 0.59, respectively.
和訳(Methods):項目反応は、段階反応モデルを用いた多次元項目反応理論(MIRT)で解析した(R 4.5.3、mirtパッケージ1.47)。まず、ポリコリック相関に基づく平行分析で次元数を検討した。探索的2次元モデルを推定し、解釈のために斜交回転(オブリミン回転・プロマックス回転)を行い、負荷量0.30以上を顕著な負荷とみなした。次に、項目1〜6が身体機能に、項目7〜12が心理的負担に負荷し、2因子間の相関を認める確認的2次元モデルを当てはめた。モデル全体の適合は C2統計量・RMSEA・SRMSR・CFI・TLIで、項目適合は S-X2統計量で評価した。局所依存はYenのQ3統計量で評価し、Q3がQ3の平均より0.20以上大きい項目ペアを局所依存の疑いとした。
和訳(Results):平行分析は2次元を示唆した。確認的2次元モデルの標準化負荷量は0.55〜0.71、因子間相関は0.40であった。モデル適合は許容範囲であった(C2 = 168.1、df = 53、RMSEA = 0.066 [90%CI 0.055〜0.077]、SRMSR = 0.053、CFI = 0.956、TLI = 0.945)。文言の似た1組の項目ペア(項目5と6)に局所依存を認めた(Q3 = 0.25、Q3の平均は−0.08)。この項目ペアに特殊因子を加えると適合が改善し(RMSEA = 0.024、CFI = 0.994)、項目5・6の身体機能への負荷量はそれぞれ0.66・0.70から0.55・0.59に低下した。
まとめ
- MIRTは、複数の潜在特性を同時に扱えるIRTであり、順序カテゴリデータの項目因子分析とほぼ同じモデルである
- 5件法などの多値項目には
itemtype = "graded"、2値項目には"2PL"を使う - 因子回転(oblimin・promaxなど)は探索的モデルのための操作である。確認的モデルには回転がなく、因子間相関は
COVで指定しないと0に固定される - 因子負荷量0.3は慣習的な目安であり、交差負荷や内容的妥当性と合わせて判断する
- Q3の絶対値「0.2」の慣例は、Q3が負に偏ることを踏まえ、平均からのずれで見るとよい
- 局所依存を放置すると、該当項目の負荷量や適合度の評価がゆがむ。原因を考え、項目の削除や特殊因子の追加で対処する
一括コピペ用Rスクリプト
# 多次元項目反応理論(MIRT)の基礎と実践:mirtパッケージによる一連の流れ
# 動作確認:R 4.5.3 / mirt 1.47 / psych 2.6.9

# install.packages(c("mirt", "psych", "GPArotation"))
library(mirt)
library(psych)

# ---- Step 1:疑似データの作成 ----
# 12項目・5件法(0〜4点)の患者報告アウトカム質問票を想定
#   Q1〜Q6 :身体機能(PF)
#   Q7〜Q12:心理的負担(MH)
#   PFとMHの相関は0.4
#   Q5「階段を上るのがつらい」とQ6「坂道を上るのがつらい」は文言が似ており、
#   共通の「余計な要因」(局所依存)を持たせている
set.seed(2026)
n <- 500
J <- 12
a <- matrix(0, J, 3)
a[1:6, 1]  <- c(1.8, 1.6, 1.4, 1.5, 1.7, 1.6)  # 身体機能への識別力
a[7:12, 2] <- c(2.0, 1.5, 1.7, 1.3, 1.6, 1.8)  # 心理的負担への識別力
a[5:6, 3]  <- 1.6                              # Q5とQ6だけが共有する局所依存
d <- cbind(seq( 2.5,  1.5, length = J),
           seq( 1.0,  0.0, length = J),
           seq(-0.5, -1.0, length = J),
           seq(-2.0, -2.8, length = J))         # 段階反応モデルの切片
sigma <- diag(3)
sigma[1, 2] <- sigma[2, 1] <- 0.4
dat <- as.data.frame(simdata(a, d, n, itemtype = "graded", sigma = sigma))
names(dat) <- paste0("Q", 1:J)
head(dat)

# ---- Step 2:次元数の見当をつける(平行分析) ----
fa.parallel(dat, cor = "poly", fa = "fa")

# ---- Step 3:探索的MIRT(項目因子分析) ----
mod1 <- mirt(dat, 1, itemtype = "graded", verbose = FALSE)
mod2 <- mirt(dat, 2, itemtype = "graded", verbose = FALSE)
anova(mod1, mod2)

summary(mod2, rotate = "oblimin", suppress = 0.3)  # mirtの既定の回転
summary(mod2, rotate = "promax",  suppress = 0.3)  # プロマックス回転

# ---- Step 4:確認的MIRT(因子構造を指定) ----
model_cfa <- "
  PF = Q1-Q6
  MH = Q7-Q12
  COV = PF*MH
"
mod_cfa <- mirt(dat, model_cfa, itemtype = "graded", verbose = FALSE)
summary(mod_cfa)

# 参考:COV行を書かないと因子間相関は0に固定される
mod_cfa0 <- mirt(dat, "PF = Q1-Q6\nMH = Q7-Q12", itemtype = "graded", verbose = FALSE)
anova(mod_cfa0, mod_cfa)

# ---- Step 5:モデル適合度 ----
M2(mod_cfa, type = "C2")
itemfit(mod_cfa)

# ---- Step 6:局所独立性の確認(Q3) ----
q3 <- residuals(mod_cfa, type = "Q3", verbose = FALSE)
round(q3, 2)
q3_pairs <- q3[lower.tri(q3)]
mean(q3_pairs)                  # Q3の平均(0ではなく負になる)
q3_star <- q3 - mean(q3_pairs)  # 平均からのずれ(Christensen et al., 2017)
diag(q3_star) <- NA
which(q3_star > 0.2, arr.ind = TRUE)

# ---- Step 7:局所依存への対処(Q5・Q6に特殊因子を追加) ----
model_ld <- "
  PF = Q1-Q6
  MH = Q7-Q12
  S56 = Q5, Q6
  COV = PF*MH
  CONSTRAIN = (Q5, Q6, a3)
"
mod_ld <- mirt(dat, model_ld, itemtype = "graded", verbose = FALSE)
anova(mod_cfa, mod_ld)
summary(mod_ld)
M2(mod_ld, type = "C2")

# ---- Step 8:パラメータの解釈 ----
coef(mod_cfa, simplify = TRUE)$items
data.frame(MDISC = MDISC(mod_cfa), round(MDIFF(mod_cfa), 2))

# ---- Step 9:因子スコア(潜在特性値)と信頼性 ----
fs <- fscores(mod_cfa, method = "EAP", full.scores.SE = TRUE)
head(fs)
empirical_rxx(fs)
おすすめ書籍
- 加藤健太郎・山田剛史・川端一光『Rによる項目反応理論』オーム社, 2014. 1次元IRTの基礎から多次元IRTまで、Rのコードとともに学べる日本語の定番書。 Amazonで見る
- 豊田秀樹『項目反応理論[入門編](第2版)』朝倉書店, 2012. 項目特性曲線や識別力・困難度の意味を丁寧に解説した入門書。 Amazonで見る
- Reckase MD. Multidimensional Item Response Theory. Springer; 2009. MDISC・MDIFFをはじめ、多次元IRTの理論を体系的にまとめた専門書。 Amazonで見る
参考文献
- Chalmers RP. mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software. 2012;48(6):1–29. doi:10.18637/jss.v048.i06
- Samejima F. Estimation of latent ability using a response pattern of graded scores. Psychometrika Monograph Supplement. 1969;34(4, Pt. 2):1–97. https://www.cambridge.org/core/journals/psychometrika/article/abs/estimation-of-latent-ability-using-a-response-pattern-of-graded-scores/87C005F61264FD8360992A8D0FC3FDE0
- Wirth RJ, Edwards MC. Item factor analysis: Current approaches and future directions. Psychological Methods. 2007;12(1):58–79. doi:10.1037/1082-989X.12.1.58
- Reckase MD. Multidimensional Item Response Theory. New York: Springer; 2009. doi:10.1007/978-0-387-89976-3
- Horn JL. A rationale and test for the number of factors in factor analysis. Psychometrika. 1965;30(2):179–185. doi:10.1007/BF02289447
- Hendrickson AE, White PO. Promax: A quick method for rotation to oblique simple structure. British Journal of Statistical Psychology. 1964;17(1):65–70. https://bpspsychub.onlinelibrary.wiley.com/doi/abs/10.1111/j.2044-8317.1964.tb00244.x
- Reise SP. The rediscovery of bifactor measurement models. Multivariate Behavioral Research. 2012;47(5):667–696. https://www.tandfonline.com/doi/full/10.1080/00273171.2012.715555
- Yen WM. Effects of local item dependence on the fit and equating performance of the three-parameter logistic model. Applied Psychological Measurement. 1984;8(2):125–145. https://journals.sagepub.com/doi/abs/10.1177/014662168400800201
- Chen WH, Thissen D. Local dependence indexes for item pairs using item response theory. Journal of Educational and Behavioral Statistics. 1997;22(3):265–289. https://journals.sagepub.com/doi/abs/10.3102/10769986022003265
- Christensen KB, Makransky G, Horton M. Critical values for Yen’s Q3: Identification of local dependence in the Rasch model using residual correlations. Applied Psychological Measurement. 2017;41(3):178–194. doi:10.1177/0146621616677520
- Maydeu-Olivares A, Joe H. Limited information goodness-of-fit testing in multidimensional contingency tables. Psychometrika. 2006;71(4):713–732. https://www.cambridge.org/core/journals/psychometrika/article/abs/limited-information-goodnessoffit-testing-in-multidimensional-contingency-tables/0F1F1D804120FD8E7B15E0812E7C3BB3
- Cai L, Monroe S. A new statistic for evaluating item response theory models for ordinal data. CRESST Report 839. Los Angeles: University of California, National Center for Research on Evaluation, Standards, and Student Testing (CRESST); 2014. CRESST
- Reeve BB, Hays RD, Bjorner JB, et al. Psychometric evaluation and calibration of health-related quality of life item banks: Plans for the Patient-Reported Outcomes Measurement Information System (PROMIS). Medical Care. 2007;45(5 Suppl 1):S22–S31. PubMed

コメント
コメント一覧 (1件)
[…] 本記事では、すべての項目が「1つの特性」を測っている一次元IRTを扱った。しかし実際の質問票では、「抑うつ」と「不安」のように、複数の特性が混ざっていることも多い。一次元性の前提が成り立たない場合に使うのが、多次元項目反応理論(MIRT)である。続きは多次元項目反応理論の記事で解説している。 […]