-

重回帰分析の結果の書き方 ― 論文にはどの数値を書いたらよいか
教科書的には何を計算するかは決まっているが、論文にどの数値を掲載するかは決まっていない。 そういうときは、実例をもとに、まねするのが良いが、最低限の目安を示す。 回帰分析の結果の書き方の基本 一番大事な要素は、点推定値と95%信頼区間である。... -
介入の前後比較は危ない|時系列データの効果検証は分割時系列解析(ITS)で
後輩:「先輩、市の消防局から月ごとの救急搬送件数のデータをもらいました。2018年1月から2025年12月までの96か月分です」 先輩:「いいデータだね。何を調べたいんだい?」 後輩:「この市では2022年1月に 救急安心センター事業(#7119) が始まりました... -
時系列データの定常性をRで判定する方法|ADF検定とKPSS検定の組み合わせ方
後輩:「先輩、この前教わったMann-Kendall検定を、ある地点の年平均気温100年分に使ってみたんです。P < 0.05で、しっかり『増えている』と出ました!」 先輩:「グラフは見たかい?」 後輩:「はい、右肩上がりです。温暖化の影響ですよね」 先輩:「... -
時系列データの「増えている」をRで判定する方法|Mann-Kendall検定とSen’s slope
後輩:「先輩、知り合いの喫茶店のマスターに相談されたんです。アイスコーヒーの売上が10年でじわじわ伸びている気がするから、それを数字で確かめたいって」 先輩:「月ごとの売上データがあるのかい?」 後輩:「はい、10年分で120か月あります。横軸に... -
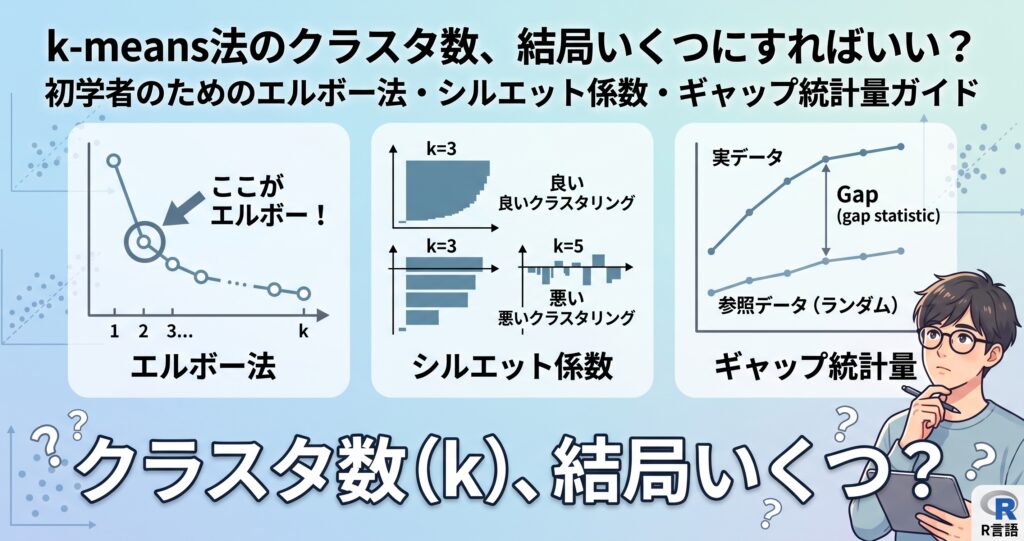
k-means法のクラスタ数、結局いくつにすればいい?初学者のためのエルボー法・シルエット係数・ギャップ統計量ガイド
「k-means法の使い方は分かったのですが、クラスタ数(k)をいくつに設定すればいいのか分からず、とりあえず3にしています……」 k-means法を学び始めたばかりの人から、こういう相談をよく受ける。関数の使い方自体は簡単なのに、肝心の「kをいくつにする... -
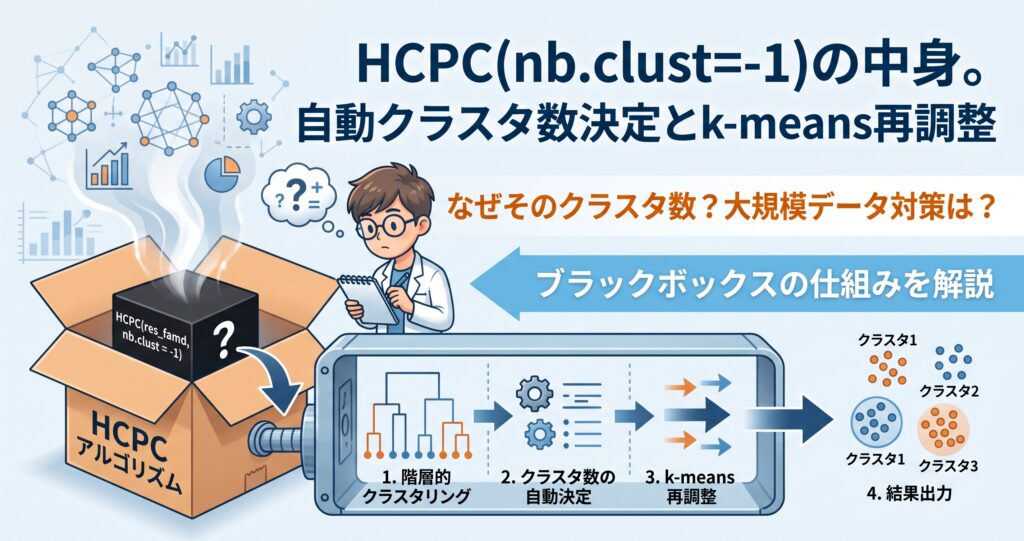
nb.clust = -1は何をしている?HCPC(階層的クラスタリング)のブラックボックスとk-means再調整の仕組み
前回の記事では、量的変数と質的変数が混在する患者データに対してFAMDで次元を縮約し、その主成分に対してHCPC(Hierarchical Clustering on Principal Components)で臨床表現型を同定するところまでを解説した。 「先生!HCPC(res_famd, nb.clust = -1)... -
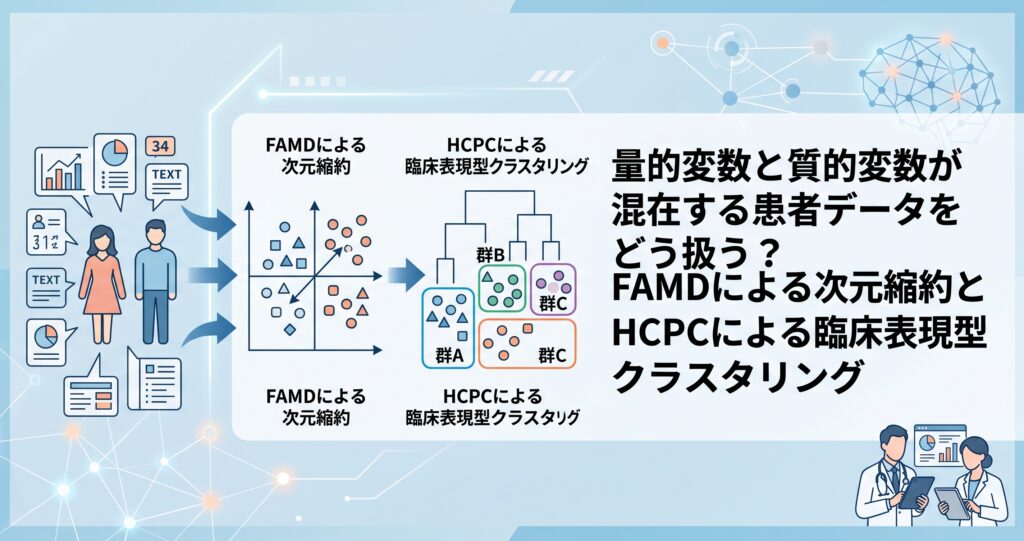
量的変数と質的変数が混在する患者データをどう扱う?FAMDによる次元縮約とHCPCによる臨床表現型クラスタリング
「先生!心不全患者のフェノタイプ(表現型)を見つけたくて、年齢・BMI・BNP値(量的変数)と性別・NYHA心機能分類(質的変数)を全部ダミー変数に変換してからPCAにかけ、その主成分でk-means法クラスタリングをやってみたのですが、クラスタリングの結... -
官能評価・嗜好テストで迷わない!シェッフェの一対比較法(原法・芳賀・中屋・浦)の選び方と芳賀の変法による心理尺度化ガイド
製品開発の現場で、飲料の味や化粧品の肌触りといった「人間の感覚や嗜好」を客観的な数値として評価したい場面は非常に多い。 その際、最も信頼性が高い手法の1つが「2つのサンプルを提示して $-2 \sim +2$ 点で評価させる」シェッフェの一対比較法である... -
低回答率に悩む研究者のための「無回答バイアス」評価・補正実践マニュアル
「苦労して実施したアンケートの回収率が15%にしかならなかった」 「上司や論文の査読者から『未回答者の意見が抜けていて、結果が偏っているのではないか』と指摘された」 マーケティングリサーチ、自治体の住民アンケート、あるいは公衆衛生・疫学研究の... -
P値依存症から脱却せよ!臨床試験のモロさを「人」の数で直感評価する Fragility Index (FI) 完全ガイド
「有名誌(NEJMやLancetなど)に掲載された最新のランダム化比較試験(RCT)で、$P = 0.042$ の有意差が出ている。新薬群は対照群に対して主要評価項目の発生率を統計学的に有意に抑制した!……よし、この新薬は間違いなく有効だから、明日からの日常診療に... -
「未測定交絡の定量的な感度分析を行え」と言われたら?E-value算出・95%信頼区間解釈と英文テンプレート
「各専門科の英文誌に論文を投稿したところ、査読者から『本研究は観察研究であり、喫煙歴や詳細な重症度などの未測定交絡(Unmeasured Confounding)の影響が否定できない。単にLimitationに可能性を書くだけでなく、定量的な感度分析(Sensitivity Analy... -
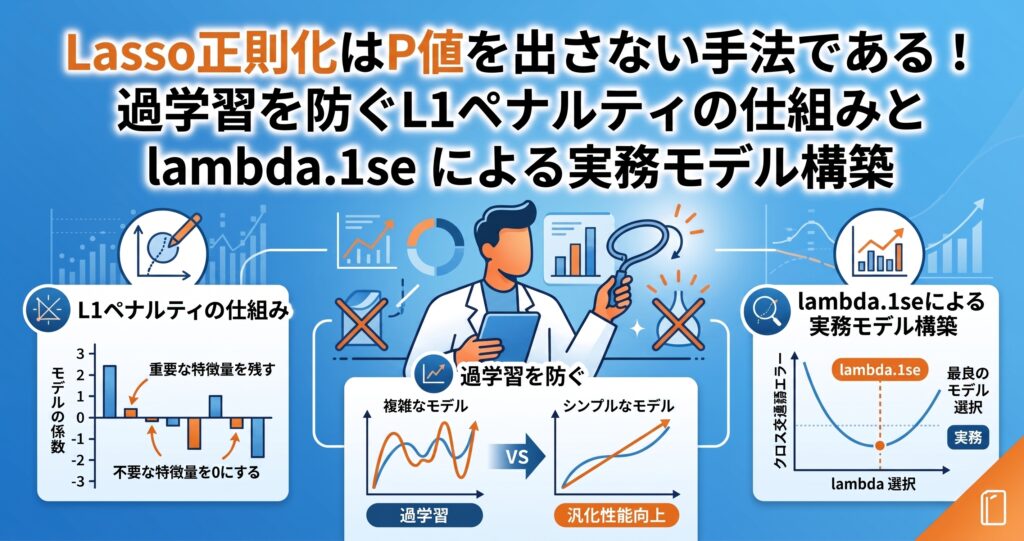
Lasso正則化はP値を出さない手法である!過学習を防ぐL1ペナルティの仕組みと lambda.1se による実務モデル構築
「査読者から『多変量モデルでのステップワイズ法による自動変数選択は過学習やP-hackingを招くため不可』と指摘されました。そこで機械学習で流行りのLasso(ラッソ)を試したのですが、Rの glmnet パッケージで解析したら……あれ? P値も標準誤差(SE)も... -
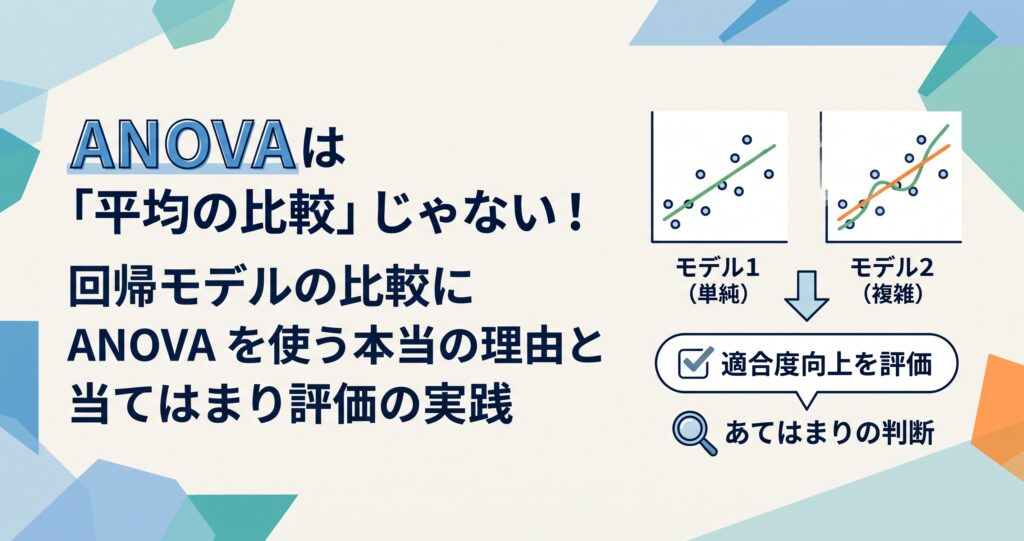
ANOVAは「平均の比較」じゃない!回帰モデルの比較に anova() を使う本当の理由とあてはまり評価の実践
「先生!モデルに新しいリスク因子($X_2$)を追加してみたのですが、この変数を追加したことでモデルのあてはまり(説明力)が本当に良くなったのか、客観的に評価する方法が分かりません」 「それなら、シンプルなモデル(model1)と変数を増やしたモデ... -
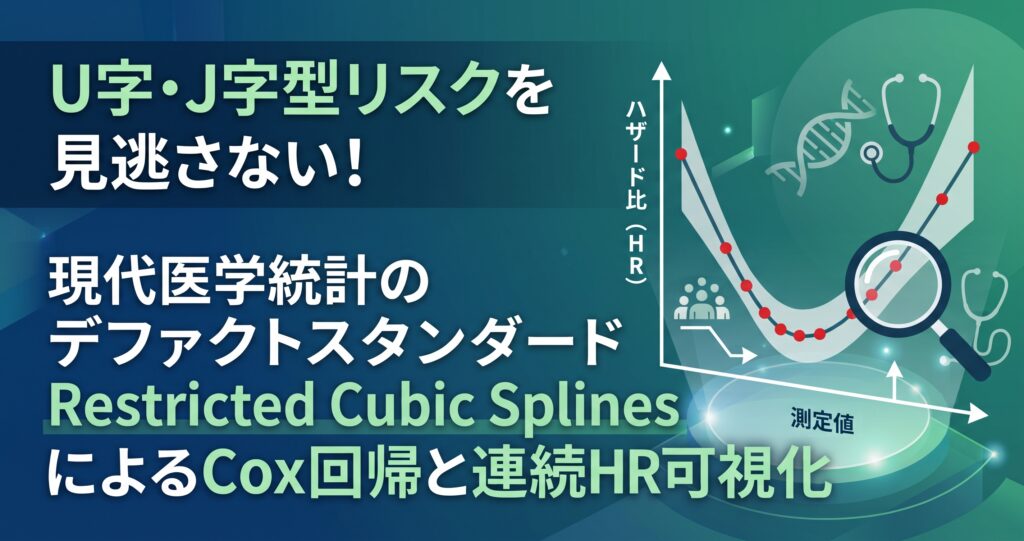
U字・J字型リスクを見逃さない!現代医学統計のデファクトスタンダード「Restricted Cubic Splines」によるCox回帰と連続HR可視化
「先生!BMIと死亡リスクの関係を見たくて多変量Cox比例ハザードモデルを組んだのですが、$P > 0.05$ で有意差が出ませんでした。でもデータをグラフで見ると、どう見てもU字型(低体重でも肥満でも死亡リスクが高い)なんです!直線モデルのまま論文に... -
順序ロジスティック回帰で比例オッズ性が崩れたらどうする?グラフ法による平行性確認と部分比例オッズモデルの実行
「先生!疾患の重症度(軽症/中等症/重症/最重症)を目的変数にして順序ロジスティック回帰モデルを組もうとし、Brant test(ブラント検定)をやったら $P < 0.05$ と判定されてしまいました!比例オッズ仮定が崩れているから順序ロジスティック回帰は... -
30項目以上の背景因子と非線形リスクをどう解析すべきか?Random Survival Forest(RSF)とrandomForestSRCパッケージによる解決法
「先生!多変量Cox比例ハザードモデルを組もうとしたら、比例ハザード性(PH仮定)が複数の変数で崩れてしまい、単一のハザード比(HR)が出せなくなりました!おまけに背景因子が30項目以上あって、ステップワイズ法を入れてもモデルが過学習で崩壊してし... -
同じ患者が何度も再入院したデータをどう解析すべきか?Cox比例ハザードモデルの拡張とAndersen-Gillモデルの実践手順
「先生!心不全の患者さんの再入院データを解析したくて、2回目や3回目の再入院データもたくさんあったのですが、解析方法がよく分からなかったので、とりあえず『初回再入院までの時間(Time-to-first event)』だけでCox比例ハザードモデルを実行しまし... -
なぜ他病死を打切りにするとイベント発生率が高く見積もられるのか?累積発生関数(CIF)とtidycmprskによる実践解決
「先生!がん患者さんの5年がん特異死亡率を調べたくて、追跡途中で他病死(老衰や心不全など)された患者さんを『中途打切り(Censoring)』として1-KM(1 - Kaplan-Meier)曲線を描きました!綺麗に死亡率が上昇していくグラフが描けました!」 ……ちょっ... -
P > 0.05だから非劣性」は査読で即却下!Cox比例ハザードモデルによる非劣性生存時間解析とICH-E9準拠の正攻法
「先生!低侵襲な新手術と標準手術の全生存期間(OS)を比較したところ、$P = 0.32$ で有意差なしでした!つまり、新手術の非劣性が証明されたということですよね?早速論文を書こうと思います!」 ……ちょっと待ってほしい。それは論文査読(Peer Review)... -
【R言語】カルテの「繰り返し測定データ」や「途中の治療変更」をそのままCox回帰に入れていませんか?時間依存共変量とtmerge関数の完全ガイド
研究者: 観察期間中に毎月測定した血圧の変化や、追跡途中で追加した抗がん剤の影響をそのままCox回帰モデルの共変量(1/0)として投入しても大丈夫でしょうか? 統計ER: ちょっと待ってください!何の気なしに扱おうとしているそのデータは、統計学で『時... -
【R言語】Cox回帰で比例ハザード性が怪しい時の対処法!RMST(制限付き平均生存時間)の使い方と層別化・期間分割の使い分け
研究者: カプランマイヤー曲線を描いたら、途中で2本の線が交差(Cross)してしまいました……。このままCox回帰を行ってハザード比(HR)を出しても大丈夫でしょうか? 統計ER: 曲線が交差している(=ハザード比が時間で変動している)場合、単一のハザー... -
【R言語】層別化Cox回帰の完全ガイド!strata()でハザード比が消える理由から論文の記述作法まで
研究者: 査読者から「施設間差を層別化Coxモデルで調整しなさい」と言われ、strata() を使って解析したのですが……指定した変数のハザード比(HR)が出力から消えてしまいました!エラーでしょうか? 統計ER: ご安心ください、それはエラーではなく層別化Co... -
3群以上のログランク検定で差が出たらどうする?pairwise_survdiff()とggsurvplot()で解く多群解析の作法
研究者: 治療法が3群(A薬・B薬・C薬)ある生存時間解析を行っています。全体のログランク検定で有意差が出たのですが、どの群同士に差があるのかの調べ方や、Cox回帰の基準群の設定方法、グラフの綺麗な描き方が分かりません……。 統計ER: 3群以上の比較で... -
傾向スコア重み付けでSMDが下がらない!RのIPTW解析でバランスを劇的に改善する実践テクニック
研究者: 傾向スコア逆確率重み付け(IPTW)を行ったのですが、一部の主要な共変量で標準化平均差(SMD)が 0.1 未満にならずバランスが取れません……。傾向スコアのモデルには変数を投入しているのですが、どう解決すればいいでしょうか? 統計ER: 単純な二... -
査読者(Reviewer)のツッコミを未然に防ぐ!IPTW解析における重み分布の確認と箱ひげ図(Boxplot)の描き方
研究者: 傾向スコア逆確率重み付け(IPTW)解析を行っているのですが、査読者や指導医から「重みの分布を箱ひげ図(Boxplot)で確認したか?」と聞かれました。なぜ箱ひげ図が必要で、どう描いて外れ値を処置すればいいのでしょうか……? 統計ER: IPTWはた... -
【R言語】3群以上の生存時間データをIPTW解析する方法!重み付きKM曲線描画からCox回帰(HR算出)まで完全攻略
研究者: 3群以上(例:「標準治療 vs 治療A vs 治療B」)ある治療群の生存時間データで交絡調整を行いたいのですが、傾向スコア重み付け(IPTW)のコードや重み付きカプランマイヤー曲線の描き方が分かりません……。 統計ER: 3群以上の多群(Multi-treatmen... -
【R言語】回帰分析の結果をExcelへきれいに貼り付ける方法!手入力卒業で転記ミスゼロへ
研究者: Rでロジスティック回帰を実行したのですが、コンソール画面の summary() の数値を1つずつExcelに手入力するのが大変です。直接コピペすると1つのセルに固まって崩れてしまうのですが、簡単に綺麗な表にする方法はありますか? 統計ER: summary() ... -
Rで臨床データ前処理!文字列操作(結合・抽出・置換・桁揃え)鉄板テクニック
【研究者からの質問】 > 電子カルテやアンケートから抽出したcsvデータをRに読み込ませたら、エラーが出て解析が止まってしまいました……。「120 mmHg」などの単位付きデータはどう処理すればいいですか? 【統計ERからの回答】 > 臨床データ解析に費や... -
【R言語】因子水準(Factor Levels)を逆順にする鉄板テクニック:回帰分析の基準群変更とggplot2の軸順反転
研究者: Rでロジスティック回帰分析を行ったら、対照群(Control)ではなく介入群が基準になってオッズ比が 0.2 と表示されてしまいました……。基準を入れ替えて見やすくする方法はありますか? 統計ER: それはRの「因子水準(Factor Levels)の順序ルール... -
もうエラーで泣かない!R・EZRでデータを一発取り込みする裏ワザ&7大トラブル解決法
「Rを使い始めたけれど、自分のデータを読み込むだけで1時間以上エラーと格闘している」 「ファイルが見つからないと言われるし、読めたと思ったら文字化けしている……」 しかし、不安に思う必要はない。これはRを使う者全員が最初に通る道である。 Rで挫折... -
質問の一貫性を数値化する「クロンバックのα(アルファ)係数」とは?
アンケート調査や心理テストを作るとき、「自分が作った質問で、本当に測りたいものが正しく測れているのだろうか」と不安になったことはないだろうか。 人間の心理や満足度といった目に見えないものを測る際、私たちは通常、複数の質問を用意する。その複... -
それ、本当に足して大丈夫?質問票やチェックリストの「合計点」に潜む罠
「アンケートの集計、とりあえず全部の点数を足して『合計スコア』にしよう」 「10項目のチェックリストで、7個『はい』がついたから、この対象は7点だ」 マーケティングのアンケート、社内の満足度調査、あるいは業務のチェックリストなど、日々の実務に... -
多変量多群多重比較の完全ガイド:エンドポイント別のアプローチとRパッケージ
研究や臨床試験において、「複数のグループ(多群)」を比較し、さらに「複数の結果(多変量・マルチプルエンドポイント)」を同時に評価したいケースは多々ある。 個別に検定を繰り返すと第1種過誤($\alpha$ エラー)が膨れ上がるため、多重比較の制御は... -
割合の多重比較検定:2群・2カテゴリの「安全地帯」から3つ以上の「危険地帯」へ進むためのロードマップ
データ分析の初期段階において、誰もが一度は次のように考える。 「AグループとBグループの比較ができたのだから、Cグループが増えても同じようにペアを組み合わせて比べればいいだけだろう」 しかし、ここに重大な落とし穴が存在する。統計学において「2... -
データの前後比較で迷わない!マクネマー・ボウカー検定の使い分けロードマップ
「アンケートの前後で結果が変わったか調べたいが、どの検定を使えばいいか分からない」 「カイ二乗検定、マクネマー検定、マクネマー・ボウカー検定の違いがわからない」 データ分析の実務や研究において、このような悩みに直面することは少なくない。統... -
【もう迷わない】カイ二乗検定からコクラン・マンテル・ヘンツェル(CMH)まで、全6種の検定の「つながり」を完全図解
データ分析を行ったり論文を読んだりしているとき、以下のような状況で混乱した経験はないだろうか。 「$2\times2$ のカイ二乗検定はわかるが、コクラン・アーミテージやマンテル・ヘンツェルなど、名前が長すぎて頭に入らない」 「手元のデータを分析した... -
小標本研究の救世主 ー 並べ替え検定(Permutation Test)が導き出す正確なP値
「サンプルサイズが小さく、正規性の確認が困難である」 「外れ値の影響を排除したいが、順位変換による情報の欠落も避けたい」 医学研究や臨床統計の現場において、このようなジレンマに直面することは少なくない。標準的な「t検定」はデータが特定の分布... -
ケンドールの順位相関係数をマスターする:スピアマン、ピアソンとの使い分け 3つの指針
「2つの変数の関連性を評価したいが、どの相関係数を選択すべきか」 医学研究において、変数間の相関を見る際に「ピアソンの相関係数」を第一選択とする者は多い。しかし、実際の臨床データは必ずしもきれいな正規分布に従うわけではなく、外れ値の存在も... -
臨床データの「クセ」に負けない。スピアマン順位相関係数を使うべき3つの場面
医療統計を学ぶ過程で必ず遭遇するのが「相関係数」だ。 しかし、多くの初心者が、最も著名な「ピアソンの積率相関係数」を安易に選択してしまう傾向にある。 実は、臨床研究で扱うデータには特有の「クセ」があり、ピアソンが苦手とする状況が頻発する。 ... -
「対応のあるt検定」と「ウィルコクソン」の使い分け:迷いをなくす3つの指針
前後比較などの「対応のあるデータ」を解析する際、多くの者が「対応のあるt検定」と「ウィルコクソン符号付き順位和検定」のどちらを選択すべきかという壁に直面する。教科書的には「正規性の有無」が基準とされるが、実務においてはより多角的な判断が必... -
平均値を統合する際の鉄則――なぜ「単純平均」ではなく「重み付け」が必要なのか
データ分析の現場において、異なる二つのグループから得られた平均値を一つにまとめ、全体像を把握したい場面は多い。しかし、ここで安易に「二つの平均値を足して2で割る」という計算を行ってはならない。 グループごとのサンプルサイズ(人数や試行回数... -
統計ソフトを困らせないために。「有意差」と「P値」の前に知っておきたいこと
統計を学び始めたばかりの頃、誰もが一度は「この平均値に有意差はありますか?」と問いかけたり、「とりあえず統計にかけてP値を出してほしい」と願ったりするものである。 しかし、統計の専門家やコンサルタントにこの質問を投げると、彼らは少し困った... -
統計学の羅針盤:標準正規分布表を「1分」で読み解く完全攻略ガイド
統計学の学習において、多くの者が最初に突き当たる壁が、無数の数字が並ぶ「標準正規分布表」である。しかし、この表の本質は極めて単純だ。これは、「あるスコアが全体の上位何%に位置するか」を指し示す、データの世界の精密な地図に他ならない。 本稿... -
その考察、間違っていませんか?「有意差なし=効果なし」という誤解の罠
統計学を学び始めたばかりの者が最も陥りやすい罠、それが「有意差なし($p > 0.05$)」を「差がない」と解釈することである。 医学研究において、この誤解は治療の選択を誤らせる致命的なリスクを孕んでいる。本記事では、なぜ「有意差がない」ことが... -
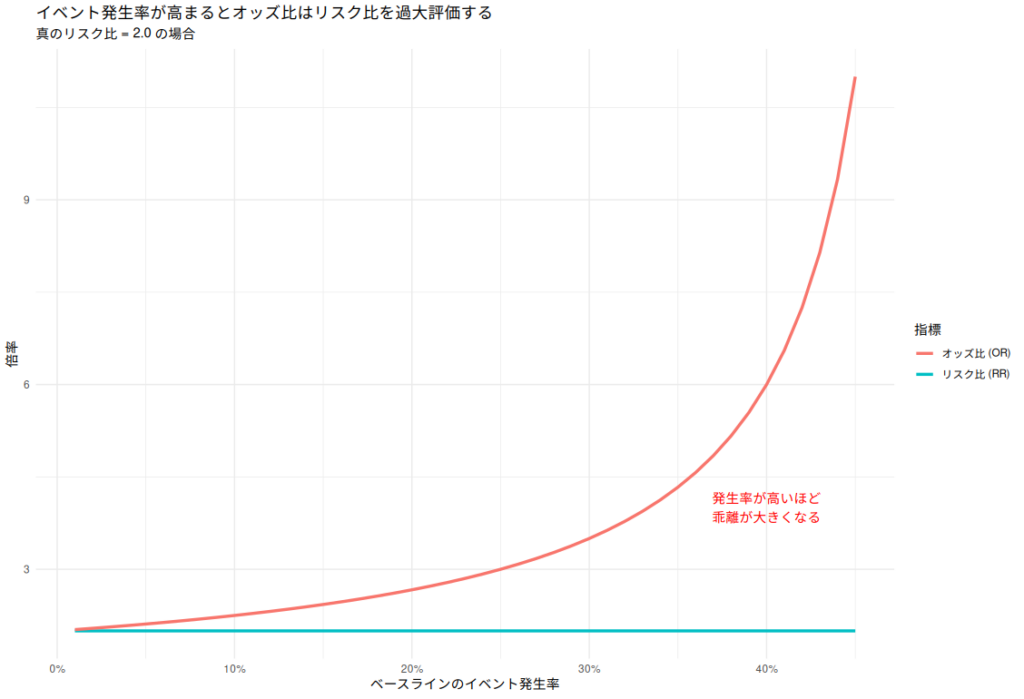
その「オッズ比」で大丈夫か?リスク比を正しく推定する「修正ポアソン回帰」のすゝめ
「分析の結果、リスクが3倍になった」 こうした報告を耳にした際、注意が必要なケースがある。もしロジスティック回帰を用いてその数字を導き出したのであれば、実はリスクを過大評価している可能性があるからだ。 本記事では、医学論文やマーケティング分... -
臨床予測モデルの真の力を解き放つ:NRIとIDIを理解する
医療現場において、疾患の発症リスクや治療効果を予測する「臨床予測モデル」は、より精度の高い意思決定を支援する強力なツールである。しかし、モデルの予測性能を評価する際、従来の指標だけでは見落とされがちな「臨床的有用性」という側面がある。本... -
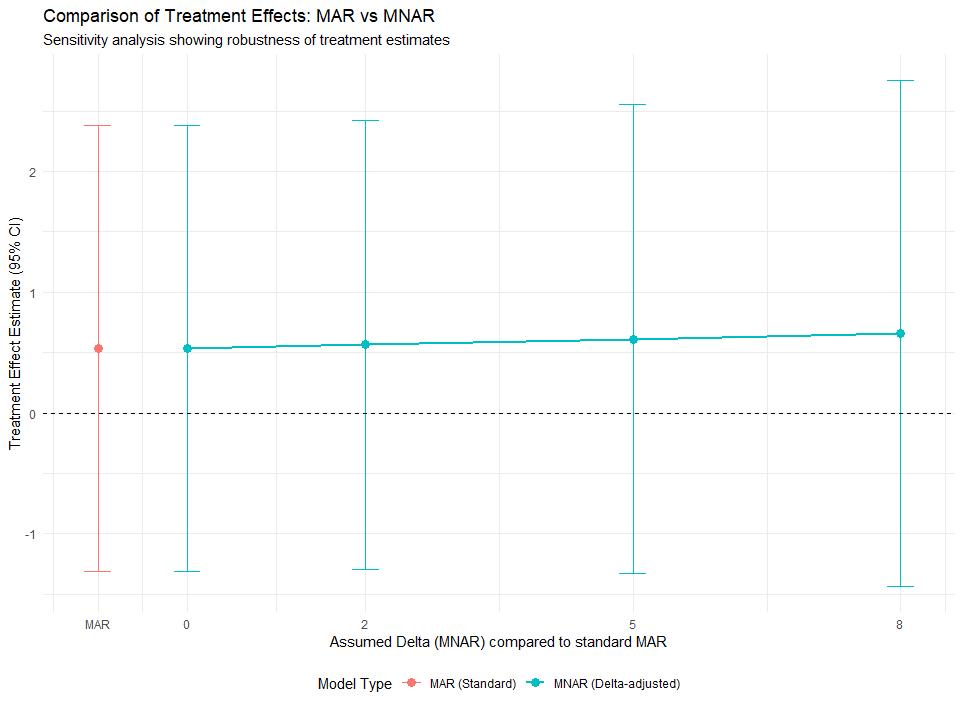
MICEを用いた多重代入におけるMNAR感度分析:見えない欠測への洞察
統計解析において、欠測データは常に悩ましい問題である。特に、欠測がランダムではない(Missing Not At Random; MNAR)場合、多重代入(Multiple Imputation; MI)のような標準的な対処法を用いても、推定値にバイアスが生じる可能性がある。 本記事では... -
競合リスクを考慮したサンプルサイズ計算:治療中止を織り込んだ研究設計
臨床研究において「ある薬剤の副作用が発生するまでの時間(Time to event)」を評価する際、避けて通れないのが競合リスク(Competing Risks)の問題である。副作用が出る前に、別の副作用で治療が中止されたり、他病死したりするケースがこれに該当する... -
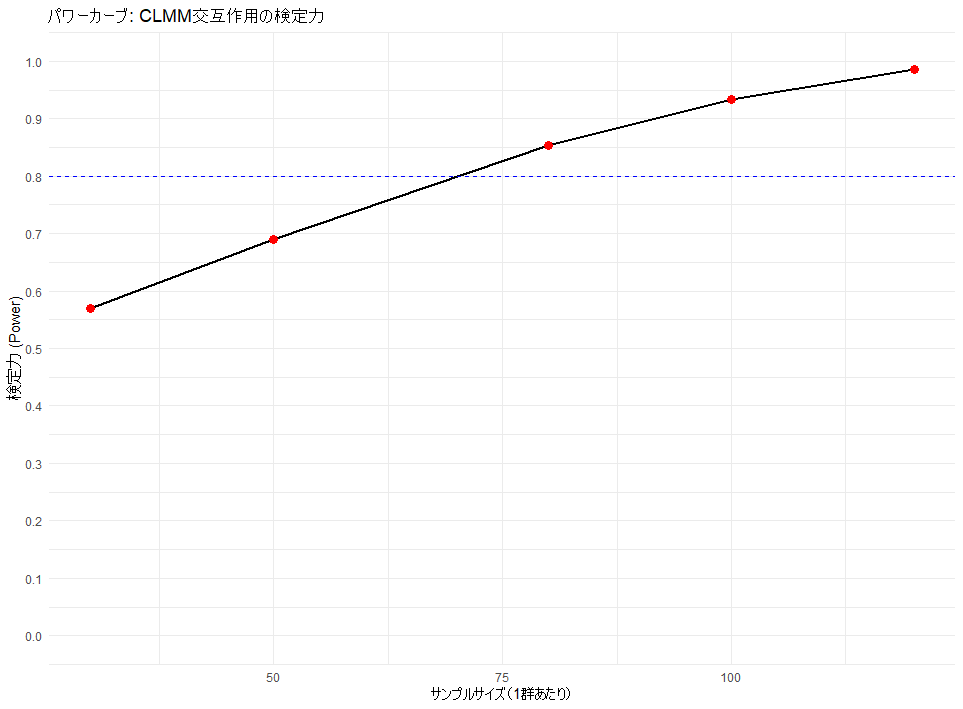
一般化線形混合モデル(順序ロジスティック)のサンプルサイズをシミュレーションで求める方法
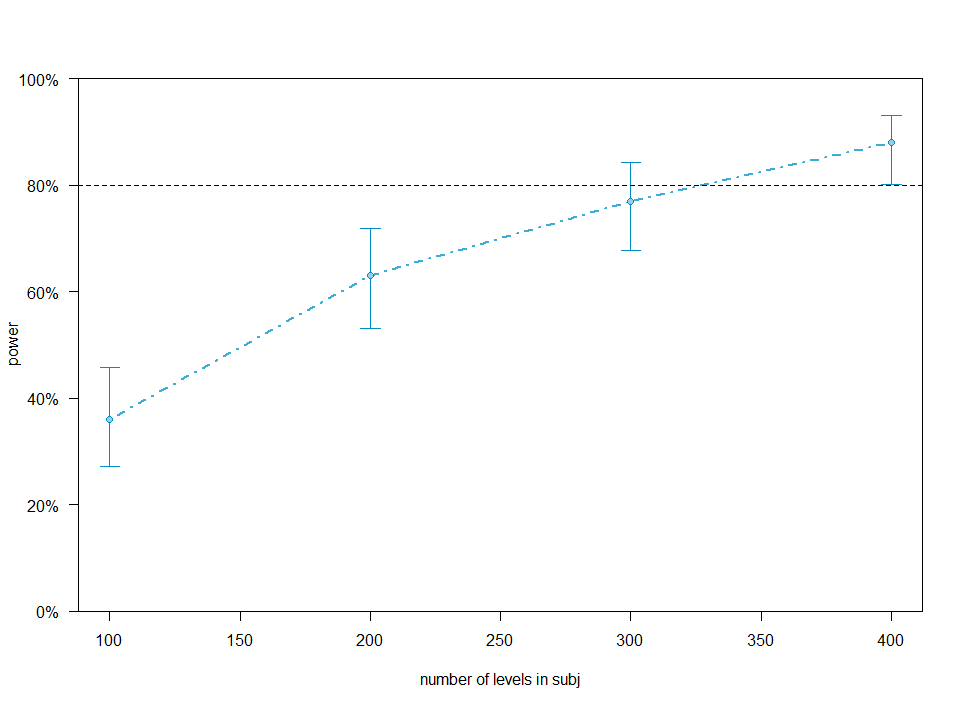
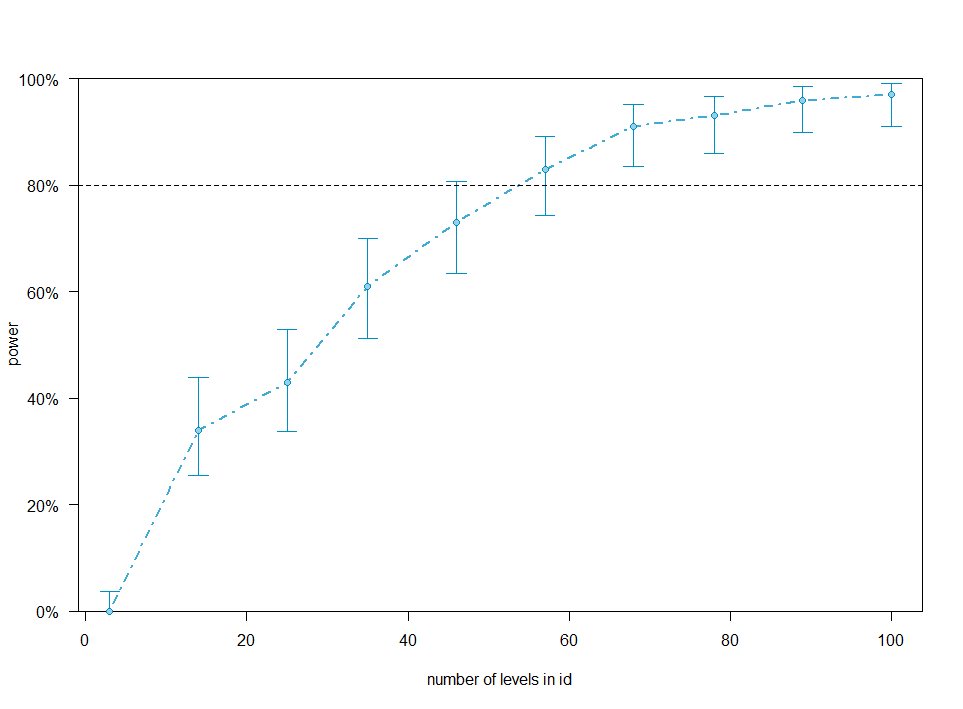
臨床研究や心理学、社会調査などで「非常に満足〜非常に不満」といった評価尺度の変化を調べたい場面は多い。このようなデータを正しく解析するには順序ロジスティック回帰が適しているが、同じ人に繰り返し測定を行う場合は、さらに一般化線形混合モデル... -
一般化線形混合モデル(二項ロジスティック)のサンプルサイズ計算をシミュレーションで行う方法
「適切なサンプルサイズはいくつか」 医学研究や行動科学において、研究デザイン段階で最も頭を悩ませる問題の一つである。特に、一般化線形混合モデル(GLMM)のような複雑なモデルでは、従来の簡易的な計算式では対応できないことが多々ある。 本記事で... -
線形混合モデルのサンプルサイズ計算をシミュレーションで行う方法
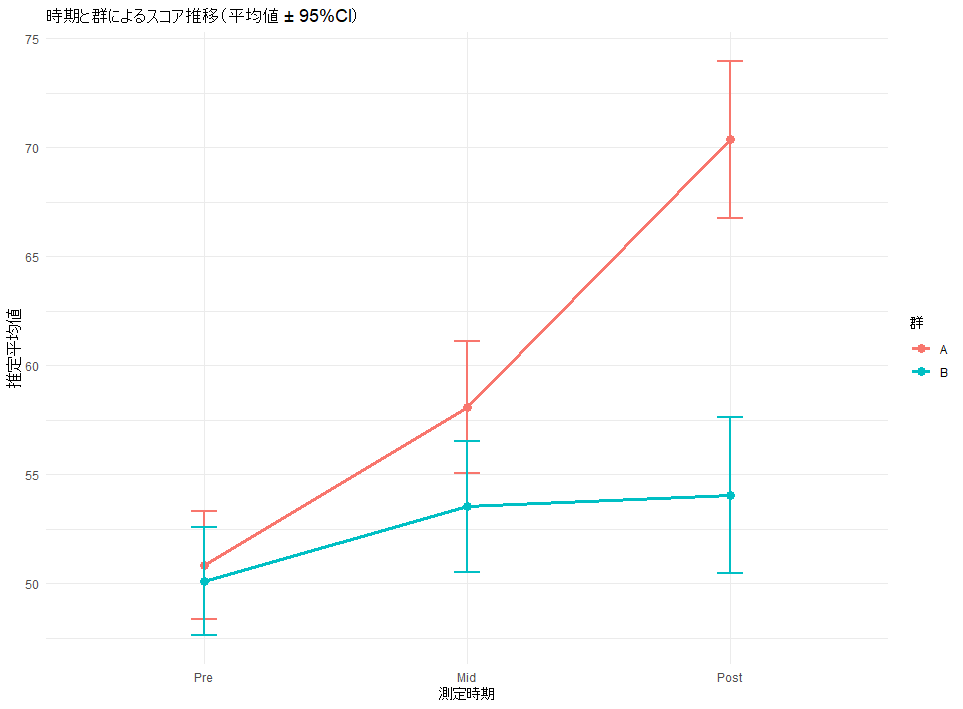
研究計画を立てる際、避けて通れないのが目標症例数(サンプルサイズ)の決定である。特に、同一被験者を複数回測定する「縦断データ」や「反復測定データ」の場合、データの相関を考慮する必要があり、計算は一気に複雑化する。 本記事では、従来の数式に... -
反復測定分散分析の効果量「偏イータ2乗($\eta_p^2$)」をマスターする
「実験で有意差が出たが、この差はどれくらい大きいと言えるのか?」 「論文で効果量を報告するように言われたが、計算方法がわからない」 統計解析において避けて通れないのが効果量(Effect Size)だ。特に、同一対象に繰り返し測定を行う「反復測定分散... -
2項検定の効果量とは?計算方法からRでのサンプルサイズ設計まで徹底解説
アンケートで「支持率が50%を超えた」、あるいは施策によって「クリック率が向上した」といったデータが得られた際、我々はよく2項検定を用いる。これは、得られた結果が「統計的に有意な差(たまたまではない差)か」を判定するためである。 しかし、p値... -
MCID入門:統計的な「差」を「臨床的な意味」に変換する方法
臨床研究や論文において「統計的に有意な差($p < 0.05$)」という言葉は頻繁に登場する。しかし、その差が「目の前の患者にとって本当に価値があるのか?」は、p値だけでは判断できない。 そこで重要となる指標が、MCID(Minimal Clinically Important... -
Rのigraphで始める!ネットワーク分析入門:データの準備から可視化のコツまで
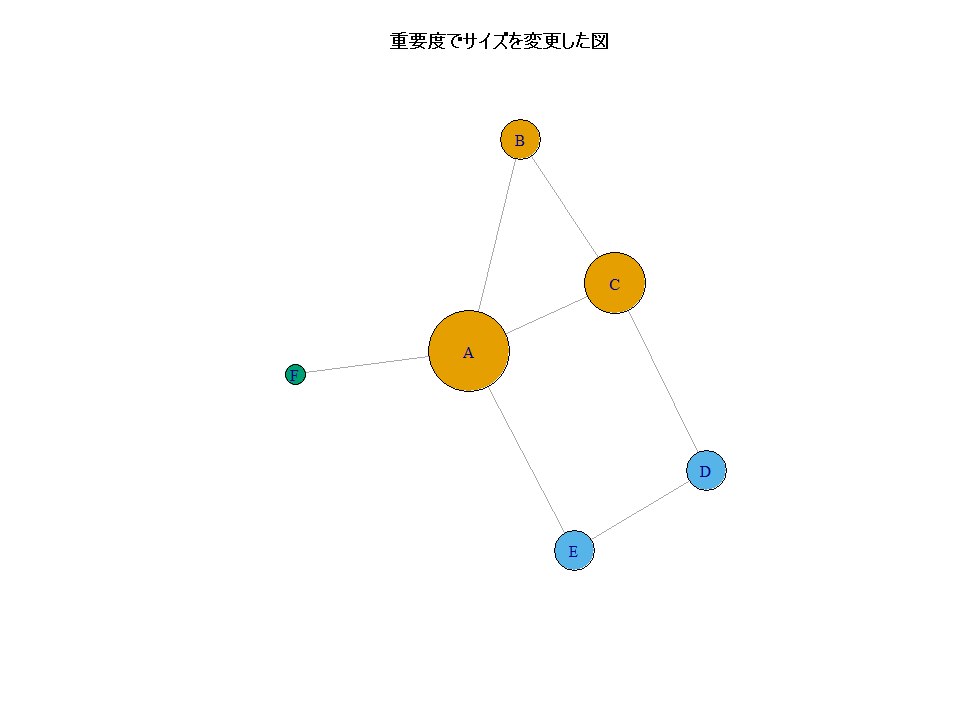
SNSのつながり、仕事の人間関係、単語の結びつきなど、複雑な関係性を目に見える形にしたいと考えたことはないだろうか。 そんな時、R言語で最も頼りになるのがigraphパッケージである。この記事では、Rを使い始めたばかりの読者に向けて、igraphの基本か... -
サンキーダイアグラムで治療の遷移を可視化する:Rによる作成ガイド
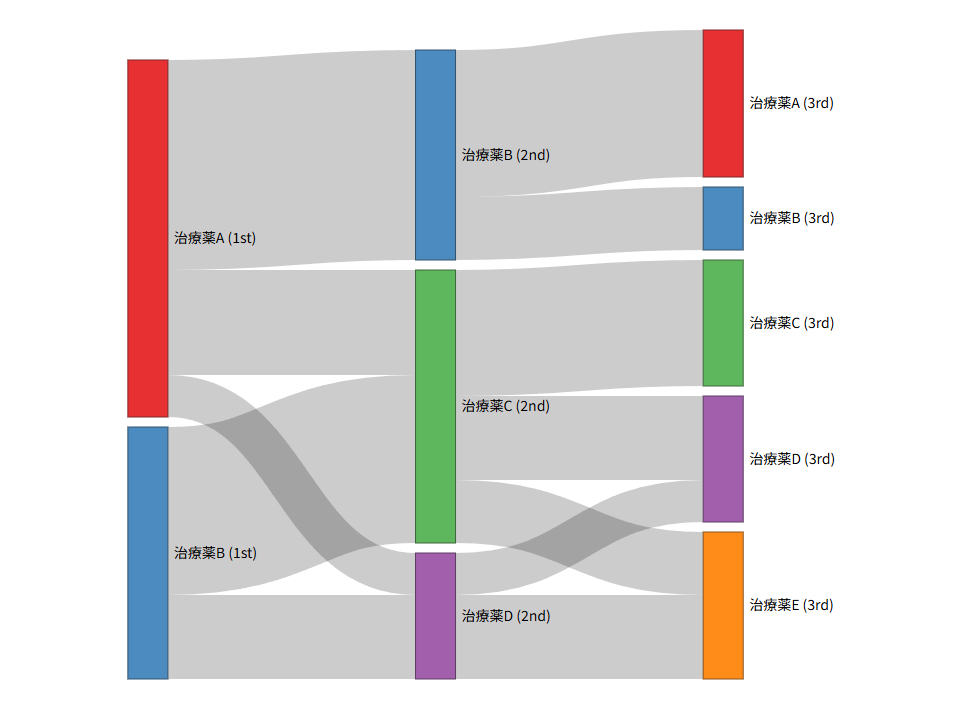
「1次治療から2次治療へ、患者はどのように遷移しているのか?」 「どのタイミングで治療の切り替え(スイッチ)が多く発生しているのか?」 医療データや臨床研究の結果を報告する際、こうした「流れ」の把握は極めて重要である。そこで威力を発揮するの... -
ggplot2の図にテキストを書き入れる方法:目的別の使い分けと実践コード
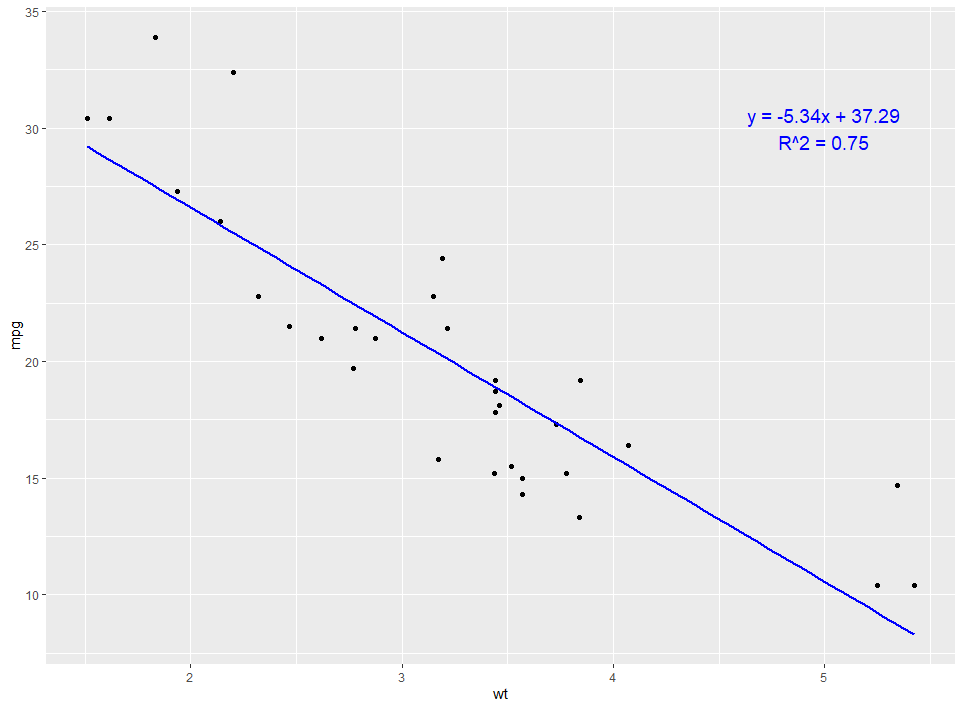
Rのggplot2を使ってグラフを作成している際、「特定のデータ点に名前を入れたい」「グラフの余白に補足説明を追加したい」と考えたことはないだろうか。 グラフは視覚的にトレンドを伝えるのが得意だが、「言葉(テキスト)」を添えることで、読み手の理解... -
ノモグラムの作成方法完全ガイド:RでのCox回帰モデル実装から活用法まで
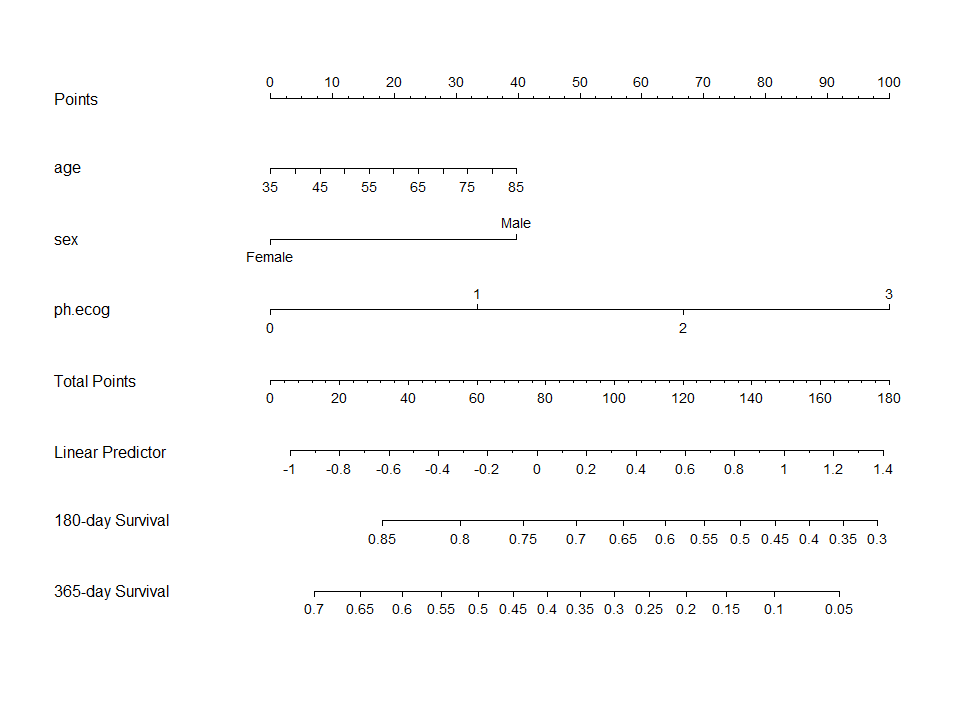
「統計解析の結果を、もっと直感的に伝えたい」と思ったことはないだろうか。 複雑な回帰分析の結果を、定規1本で計算できるグラフに変換してくれるのが「ノモグラム(Nomogram)」である。本記事では、ノモグラムの基礎から、Rを使った具体的な作成方法、... -
生存分析の予測精度を評価する「時間依存性ROC曲線」:Rでの実装まで解説
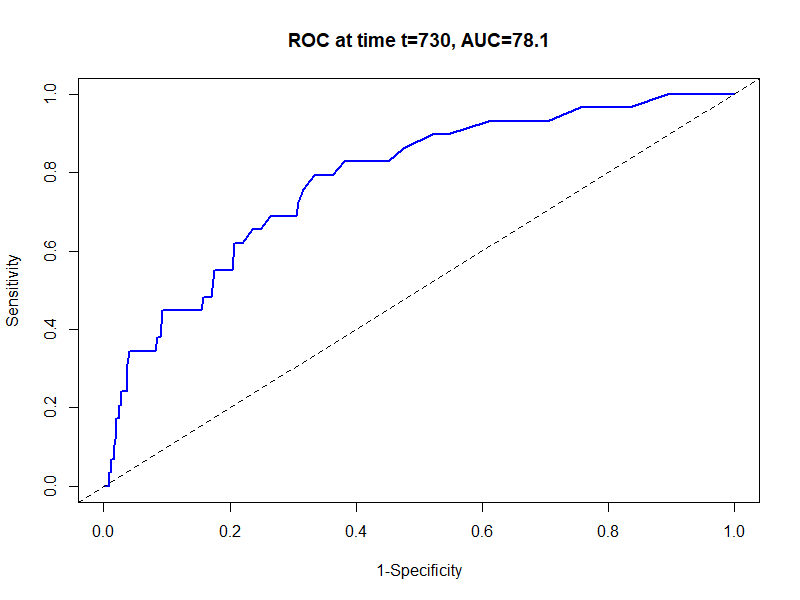
医療統計やデータ分析において、予測モデルの精度を評価する際に「ROC曲線」は欠かせない指標である。しかし、生存時間解析のように「時間の経過」が関わるデータでは、通常のROC曲線だけでは不十分な場合が多い。 そこで用いられるのが「時間依存性ROC曲... -
Rで実践:3つ以上のROC曲線を1つのグラフにまとめる手法
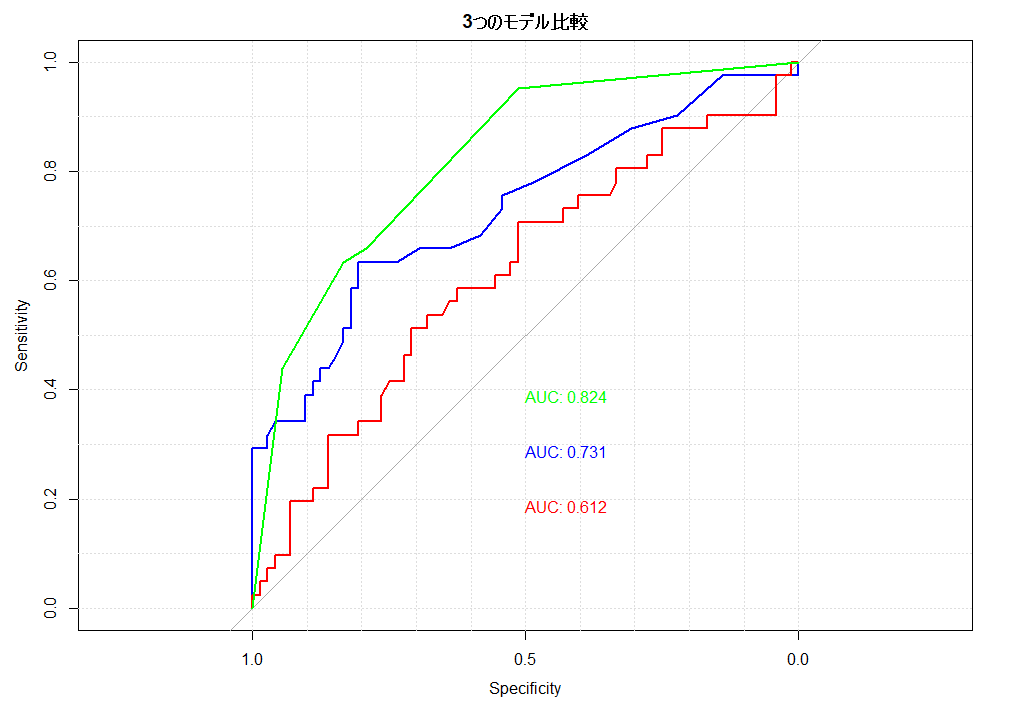
医療統計や機械学習において、複数の予測モデルの性能を比較する際、ROC曲線(受信者動作特性曲線)を1つのグラフに重ねて描画することは、視覚的な評価において極めて重要である。 本記事では、Rの標準的なパッケージであるpROCを用い、1本から3本、さら... -
ロジスティック回帰モデルの評価指標:混同行列からROC曲線、Youden Indexまで
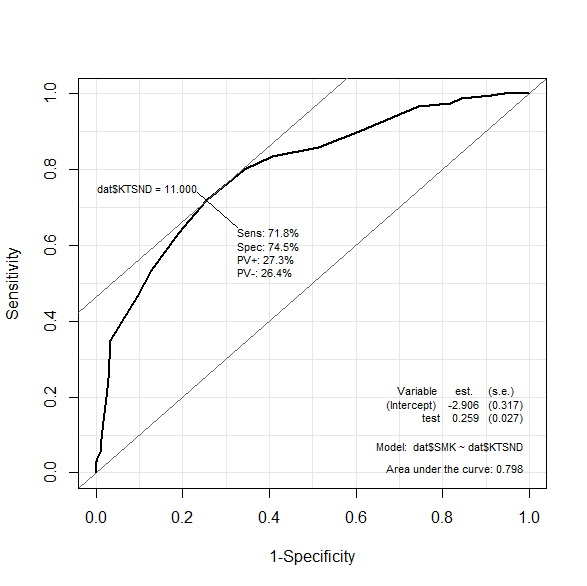
ロジスティック回帰モデルを構築した後、多くの初心者は「正解率(Accuracy)」のみを見てモデルの良し悪しを判断しがちである。しかし、分類タスクにおいて正解率のみを指標とすることは、時として重大な判断ミスを招く。 本記事では、モデルの性能を多角...