若手医師:うつ症状のチェックリスト(10項目、「はい/いいえ」で答える)を使って、治療前後で合計点を比べたいと思っています。Aさんは3点から1点に、Bさんは10点から8点になりました。どちらも「2点改善」でいいですよね?
統計担当:そこが落とし穴なんだ。合計点は「どの項目に『はい』と答えても1点」と数えている。でも、「最近疲れやすい」に『はい』と答えるのと、「死にたいと思うことがある」に『はい』と答えるのとでは、示している重さがまったく違うよね。
若手医師:確かに……。でもα係数は0.85あって、信頼性は十分だと思っていました。
統計担当:α係数は、項目同士の回答の一貫性にもとづく信頼性の指標で、尺度全体で1つの値しか出てこない。「重症の人同士をどれくらい細かく区別できるか」までは教えてくれないんだ。実際、Bさんのように満点近くの人がたくさんいると、重症の人たちの差がほとんど見えなくなる。いわゆる天井効果だね。
合計点は便利だが、すべての項目を「同じ重さの1点」として数えている。現実の項目には、「その症状が出るのはどのくらい重い人からか(難しさ)」と、「その項目が人をどれだけくっきり見分けられるか(見分ける力)」の違いがある。
この違いを正面から扱うのが、項目反応理論(Item Response Theory:IRT)である。本記事では、IRTの基礎として、1PL・2PL・3PLモデル、項目特性曲線、能力θ、識別力・困難度、テスト情報量までを、Rの mirt パッケージで手を動かしながら理解していく。
1. IRTとは何か:人と項目を「同じ物差し」に並べる
IRTの出発点は、目に見えない特性(ここでは「抑うつの重さ」)を、1本の数直線で表すことである。この数直線上での回答者の位置を θ(シータ) と呼ぶ。テストの世界では「能力」と呼ばれることが多いが、臨床の質問票では「抑うつの重さ」「身体機能の高さ」など、測りたい特性そのものを指す。
IRTの最大の特徴は、回答者(θ)と項目(難しさ)を、同じ数直線の上に並べる点にある。
走り高跳びをイメージしてほしい。選手の跳躍力も、バーの高さも、同じ「センチメートル」で測れる。だからこそ、「跳躍力180 cmの選手が、170 cmのバーを越える確率は何%か」という問いが成り立つ。IRTでは、θ が選手の跳躍力、項目の困難度がバーの高さにあたる。抑うつ尺度なら、「抑うつの重さ θ の人が、この項目に『はい』と答える確率は何%か」をモデル化するわけである。
※コラム:古典的テスト理論(CTT)とIRTの違い
合計点やα係数にもとづく従来の考え方を、古典的テスト理論(Classical Test Theory:CTT)と呼ぶ。両者の違いをざっくり比べると次のようになる。
CTT IRT 人の得点 合計点 θ(潜在特性の推定値) 項目の性質 通過率、項目-全体相関 困難度 b、識別力 a など 測定誤差 全員に共通の1つの値(信頼性から計算) θ の値ごとに異なる 項目の性質の、集団への依存 大きい(集団が変わると通過率が変わる) モデルが成り立つ範囲では小さい(ただし、θ の原点と単位の取り方は別途決める必要がある) 特に重要なのは3行目である。CTTでは「この尺度の測定誤差は○点」と1つの値で語るが、IRTでは「軽症域は精密に測れるが、重症域は誤差が大きい」というように、θ の位置によって測定精度が違うことを表現できる。冒頭の天井効果の悩みは、まさにこの点に関わっている。
2. 項目特性曲線と2PLモデル
2-1. 項目特性曲線(ICC)
横軸に θ、縦軸に「その項目に『はい』と答える確率」をとって描いた曲線を、項目特性曲線(Item Characteristic Curve:ICC)と呼ぶ。θ が高い(抑うつが重い)人ほど『はい』と答えやすいので、曲線は右上がりのS字になる。
このS字を表す代表的なモデルが、2パラメータ・ロジスティックモデル(2PL)である。本記事で覚えてほしい式は、ほぼこれ1つだ。
式①(2PLモデル)
$$P_j(\theta) = \frac{1}{1 + \exp{-a_j(\theta – b_j)}}$$
ここで $P_j(\theta)$ は、θ の人が項目 $j$ に『はい』と答える確率である。項目ごとに2つのパラメータを持つ。
(注)日本語の教科書では、式①の $a_j$ の前に1.7を掛けた形($1.7a_j(\theta – b_j)$)がよく登場する。この1.7は「尺度定数 D」と呼ばれ、ロジスティック曲線を正規分布の累積分布関数(正規オージブ)にほぼ重ねるための値である。本記事で使う mirt は1.7を掛けない式①の形で推定するので、教科書の識別力と比べるときは、mirt の値を1.7で割るとおおよそ対応する。困難度 b はどちらの形でも変わらない。
- 困難度 $b_j$:曲線の「位置」を決める。θ = $b_j$ のとき、確率がちょうど0.5になる。走り高跳びでいえばバーの高さで、抑うつ尺度なら「その症状に『はい』と答える確率が五分五分(0.5)になるのは、どのくらい重い人か」を表す。$b_j$ が大きい項目ほど、かなり重症の人でないと『はい』と答えにくい。なお、θ が $b_j$ より低い人でも、『はい』と答える確率は0ではない点に注意したい。
- 識別力 $a_j$:曲線の「傾き」を決める。$a_j$ が大きいほど、θ = $b_j$ の付近で曲線が急に立ち上がる。つまり、バーの高さ付近にいる人を「越えられる人」と「越えられない人」にくっきり分けられる。
図1は、困難度と識別力を変えたときにICCがどう変わるかを示したものである(図を描くRコードは「6. Rによる実装」のStep 0に載せている)。
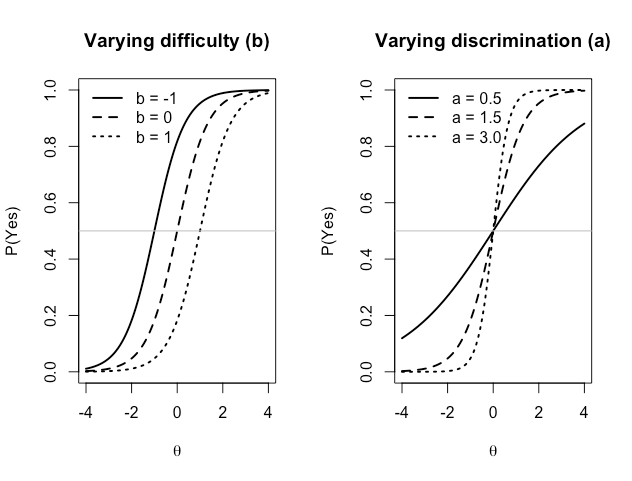
図1:困難度 b と識別力 a によるICCの変化(左:b だけを変えると曲線が左右に平行移動する/右:a だけを変えると傾きが変わる)
左図では、識別力を a = 1.5 にそろえたまま、困難度だけを b = −1, 0, 1 と変えている。3本の曲線は同じ形のまま左右にずれ、それぞれ θ = b の位置で、確率0.5の灰色の線を横切っている。困難度が1上がると、『はい』の確率が0.5になる θ がちょうど1だけ右(重症側)にずれる、ということである。
右図では、困難度を b = 0 にそろえたまま、識別力だけを a = 0.5, 1.5, 3.0 と変えている。3本とも θ = 0 で確率0.5を通る点は同じだが、傾きがまったく違う。a = 3.0(点線)は θ = 0 の前後で確率がほぼ0からほぼ1へ一気に跳ね上がり、θ が0より少し低い人と少し高い人を、はっきり分けられる。一方、a = 0.5(実線)はなだらかで、θ = 4 という極端に重い人でも『はい』の確率は0.9に届かない。
識別力の低い項目は、θ が上がっても『はい』の確率がゆっくりとしか上がらない。たとえば「食欲がない」という項目は、うつ以外の理由(胃腸の不調など)でも『はい』になり得るので、抑うつの重さをはっきりとは見分けにくい、ということが起こる。
※コラム:θ はなぜ「平均0、標準偏差1」なのか
多くのIRTソフトウェアは、θ を「平均0、標準偏差1」の尺度で表す。これは、θ にもともと決まった原点や単位があるからではない。θ は目に見えない量なので、どこを0点とし、何を1目盛りとするかは任意である。そこで推定のときに、「この集団の θ の分布は平均0、分散1」と決めて、物差しの原点と目盛りを固定しているのである。
温度にたとえると、摂氏と華氏のどちらで測っても、暑い日が寒い日より暑いという関係は変わらない。同じように、θ = 1.0 は「この集団の平均より1標準偏差ぶん重い」という意味で、絶対的な重症度の基準ではない点に注意したい。なお、PROMISのように、基準となる集団で平均50・標準偏差10に変換したスコア(Tスコア)を用いることもある。
3. 1PL・2PL・3PLの関係:パラメータを足し引きした「親戚」
2PLを基準にすると、1PLと3PLは次のように整理できる。
- 1PL(1パラメータ・ロジスティックモデル):識別力 $a$ を全項目で共通にしたモデル。項目ごとに違うのは困難度 $b$ だけになる。ICCはすべて同じ傾きで、左右の位置だけが違う。
- 2PL:識別力 $a$ を項目ごとに推定する。
- 3PL(3パラメータ・ロジスティックモデル):2PLに、曲線の下限 $c$(当て推量パラメータ)を加えたモデル。θ がどれほど低くても、確率が $c$ より下がらない。多肢選択式の学力テストで、「4択なら、まったくわからなくても4分の1くらいは当たる」状況を表すために考えられた。3PLでは、θ = $b$ のときの確率は0.5ではなく $(1+c)/2$ になる。
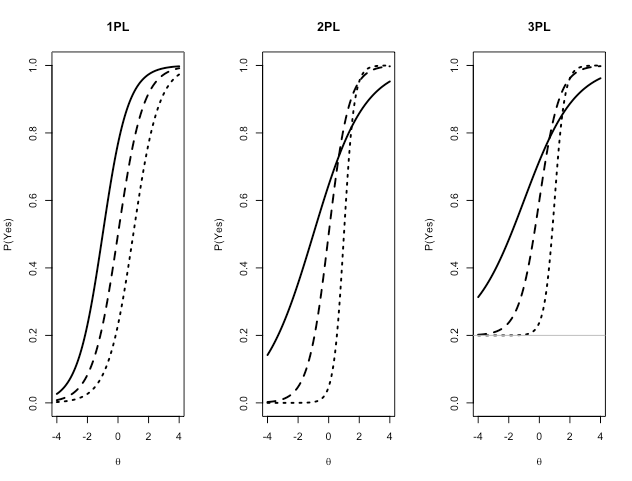
図2:1PL・2PL・3PLのICCの比較(1PL:傾きがすべて同じ/2PL:傾きが項目ごとに違う/3PL:左端が0まで下がらない)
図2では、困難度が b = −1(実線)、0(破線)、1(点線)の3項目を描いている。1PLでは識別力をすべて a = 1.2 にそろえ、2PLと3PLでは実線・破線・点線の順に a = 0.6, 1.5, 3.0 としている。3PLの下限は c = 0.2 である。
- 1PL(左):3本の曲線は同じ傾きで、左右の位置だけが違う。そのため曲線が交わることはなく、どの θ の人にとっても「実線の項目が一番『はい』と答えやすく、点線の項目が一番答えにくい」という順番が変わらない。
- 2PL(中央):傾きが項目ごとに違うので、曲線が交差する。困難度が最も低い実線の項目は、θ が低い人では一番『はい』と答えやすいが、θ が1.5を超えたあたりからは、困難度が高いはずの点線の項目のほうが『はい』の確率が高くなる。「どの項目が答えやすいか」の順番が、θ の位置によって入れ替わるのである。2PLの困難度を解釈するときは、「確率が0.5になる位置」という定義に立ち返ることが大切だ。
- 3PL(右):どの曲線も、左端が灰色の線(c = 0.2)より下に下がらない。θ が非常に低くても、2割の確率で『はい』と答えるということである。また、点線の項目は θ = b = 1 のときに確率が0.5ではなく、$(1 + 0.2)/2 = 0.6$ になっている。3PLでは「困難度 = 確率0.5の位置」という読み方が成り立たない点に注意したい。
臨床の質問票(患者報告アウトカム:PRO)では、「わからないから当てずっぽうで『はい』と答える」ことは想定しにくい。そのため、二値項目の質問票では1PLか2PLが使われるのが一般的で、3PLを使う場面はまれである。3PLはパラメータが多いぶん推定が不安定になりやすいので、「パラメータが多いほうが精密そうだから」という理由で機械的に選ぶのは避けたい。
※コラム:RaschモデルとIRTの1PLは同じもの?
1PLとよく似たモデルに、Raschモデルがある。数式の形はほぼ同じで、実際、Rの
mirtパッケージでもitemtype = "Rasch"と指定すれば、1PLと同等のモデルを推定できる(識別力を1に固定し、そのかわりに θ の分散を推定する。全項目の識別力を等しくした2PLと同じ当てはまりになる)。ただし、背景にある考え方は大きく違う。IRTの立場では、「データをうまく説明できるモデルを選ぶ」ので、当てはまりが悪ければ2PLや3PLに切り替える。一方、Raschモデルの立場では、「全項目の識別力が等しい」ことを、良い尺度が満たすべき条件と考える。そのため、モデルに合わない項目は、尺度から外す・作り直す対象になる。
洋服にたとえるなら、IRTは「体に合わせて服を仕立て直す」、Raschは「決められた型紙に体を合わせる(合わない項目は鍛え直す)」という発想である。どちらが正しいというより、尺度開発の目的によって使い分けられている。
※コラム:「はい/いいえ」以外の質問票はどうするか(段階反応モデル)
臨床の質問票は、「まったくない/ときどき/よくある/いつも」のような多段階(リッカート形式)の回答が多い。この場合によく使われるのが、段階反応モデル(Graded Response Model:GRM)である(Samejimaが提案した)。
GRMは、2PLを多段階に広げたモデルと考えるとわかりやすい。「『ときどき』以上か」「『よくある』以上か」「『いつも』か」という境目ごとに2PLのようなS字曲線を考え、境目ごとに困難度を持たせる(識別力は項目ごとに1つ)。本記事で学ぶICC・識別力・困難度・情報量の考え方は、GRMでもそのまま使える。
mirtではitemtype = "graded"と指定する。
4. 情報量:「どこを精密に測れる尺度か」が見える
4-1. 項目情報量とテスト情報量
IRTのもう1つの柱が、情報量(information)である。項目情報量は、「その項目が、θ のどのあたりの人を区別するのに役立つか」を表す曲線である。
2PLの項目情報量は、θ = $b_j$(困難度)の付近で最大になり、その高さは識別力 $a_j$ が大きいほど高くなる。つまり、困難度は「どこにピントが合うか」、識別力は「どれだけくっきり見えるか」を決めている。
各項目の情報量を足し合わせたものが、テスト情報量 $I(\theta)$ である。テスト情報量からは、θ の推定値の標準誤差(SE)が次のように求められる。
式②(テスト情報量と標準誤差)
$$SE(\theta) \approx \frac{1}{\sqrt{I(\theta)}}$$
情報量が多い θ の範囲ほど、標準誤差が小さく、測定が精密になる。これが、コラムで述べた「IRTでは θ の位置によって測定精度が違う」ことの正体である。(正確には、この関係は情報量が十分に大きいときの近似として成り立つ。)
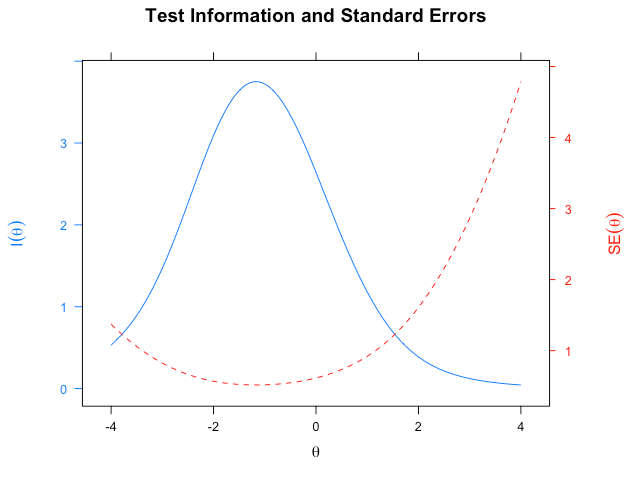
図3:テスト情報量曲線(青の実線、左の目盛り)と標準誤差曲線(赤の破線、右の目盛り)(「6. Rによる実装」のStep 5で、疑似データに2PLを当てはめた結果から描いたもの)
青の情報量曲線は、θ = −1.17 で山の頂上(情報量3.75)を迎え、そこから離れるほど低くなる。赤の標準誤差曲線は、ちょうどその逆の形で、山の頂上付近で最も小さく(約0.52)、山から離れるほど大きくなる。式②のとおり、情報量と標準誤差は表裏一体の関係にある。
注目してほしいのは、山が左右対称の位置ではなく、θ の低い側(軽症域)に寄っていることである。θ が2を超える重症域では情報量が0.5を下回り、標準誤差は急激に大きくなる。θ = 4 では、標準誤差が4.8にまで達している(数値は testinfo() で確認した)。θ の標準偏差が1であることを考えると、これは「重症域の人については、θ の推定値がほとんど当てにならない」ことを意味する。
4-2. カメラのピントで考える天井効果
テスト情報量の曲線は、カメラのピントに似ている。ピントが合っている距離の被写体はくっきり写るが、ピントから外れた手前や奥はぼやける。
冒頭のチェックリストで、軽い症状の項目(困難度が低い項目)ばかりだったとしよう。すると情報量の山は、θ の低い側(軽症域)にできる。軽症の人同士の違いはくっきり見えるが、重症域はピントの外になり、重症の人はみんな「ほぼ全項目に『はい』」と答えて合計点が満点付近に集まる。これが天井効果を、情報量の言葉で言い直したものである。
この見方は臨床的にとても役に立つ。
- 項目選び・短縮版の作成:情報量の少ない項目を外しても、測りたい範囲の精度がほとんど落ちないなら、項目数を減らして回答者の負担を軽くできる。
- 尺度の弱点の発見:重症域の情報量が足りなければ、「重症の人でないと『はい』と言わない項目」を追加すればよい、と改善の方向がわかる。
- 適応型テスト(CAT):回答に応じて、その人の θ 付近で情報量が最も大きい項目を次々に出題する方法である。米国NIHのPROMIS(Patient-Reported Outcomes Measurement Information System)では、IRTで較正した項目バンクとCATを使い、少ない項目数で症状やQOLを測定できるようにしている(Bevans et al., 2014)。
5. 正攻法:IRT分析の標準的な流れと前提
5-1. IRTの前提
本記事で扱う一次元IRTには、次の前提がある。
- 一次元性:すべての項目が、1つの潜在特性(θ)を測っていること。
- 局所独立性:θ が同じ人の中では、項目同士の回答が互いに独立であること。言い換えると、項目間の相関は θ だけで説明できる、ということである。たとえば「眠れない」と「夜中に目が覚める」のように、内容がほぼ重なる項目があると、θ 以外の理由で回答がそろい、この前提が崩れやすい。
- 単調性:θ が高いほど、『はい』の確率が上がる(下がらない)こと。
IRTを使えば一次元性の確認が不要になるわけではない。むしろ、IRTは一次元性を「前提として」組み立てられたモデルである。前提が崩れていれば、出てくるパラメータは解釈できない。
5-2. 分析の流れ
質問票の開発・評価にIRTを使う手順は、Edelen & Reeve(2007)やPROMISの解析計画(Reeve et al., 2007)に整理されている。基本形は次のとおりである。
- 記述統計と前提の確認:各項目の回答分布を確認し、一次元性を因子分析などで確かめる。局所独立性の違反がないかも確認する。
- モデルの当てはめと選択:1PLと2PLを当てはめ、尤度比検定やAIC・BICで比較する。
- 適合度の確認:モデル全体の適合度(M2統計量など)と、項目ごとの適合度(S-X² 統計量など)を確認する。
- 項目パラメータとICC・情報量の確認:識別力が極端に低い項目、困難度が偏っている項目がないかを見る。
- θ の推定:回答者ごとに θ を推定する(EAP推定など)。
※コラム:サンプルサイズはどれくらい必要か
IRT、特に2PL以上のモデルでは、項目パラメータを安定して推定するために、ある程度のサンプルサイズが必要である。「2PLなら数百例」がよく挙げられる目安だが、必要な人数は項目数、回答の分布の偏り、どれくらいの精度を求めるかによって変わり、一律の正解はない。
たとえば、ほとんど全員が『いいえ』と答える項目(困難度が極端に高い項目)は、『はい』と答えた少数の人の情報だけで曲線を推定することになり、推定が不安定になりやすい。少ないサンプルで2PLや3PLを当てはめ、もっともらしい数値が出ても、標準誤差が大きければ信頼できない、という点を覚えておきたい。
6. Rによる実装(mirt)
ここからは、Rの mirt パッケージ(Chalmers, 2012)を使って、IRT分析の流れを体験する。mirt は多次元IRTにも対応したパッケージで、本記事の一次元モデルはその基本形にあたる。
Step 0:パッケージの準備と、概念図(図1・図2)の描画
# install.packages(c("mirt", "latticeExtra"))  # 初回のみ
library(mirt)
# latticeExtra は、Step 5 の plot(type = "infoSE") で
# 情報量と標準誤差を2軸で重ねて描くときに使われる(library() での読み込みは不要)

# --- 図1:b と a によるICCの変化(概念図) ---
theta <- seq(-4, 4, length.out = 200)
p2pl  <- function(theta, a, b, c = 0) c + (1 - c) / (1 + exp(-a * (theta - b)))

par(mfrow = c(1, 2))
# 左:b だけを変える(a = 1.5 で固定)
plot(theta, p2pl(theta, a = 1.5, b = -1), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = expression(theta), ylab = "P(Yes)", main = "Varying difficulty (b)")
lines(theta, p2pl(theta, a = 1.5, b = 0), lwd = 2, lty = 2)
lines(theta, p2pl(theta, a = 1.5, b = 1), lwd = 2, lty = 3)
abline(h = 0.5, col = "gray")
legend("topleft", legend = c("b = -1", "b = 0", "b = 1"), lty = 1:3, lwd = 2, bty = "n")

# 右:a だけを変える(b = 0 で固定)
plot(theta, p2pl(theta, a = 0.5, b = 0), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = expression(theta), ylab = "P(Yes)", main = "Varying discrimination (a)")
lines(theta, p2pl(theta, a = 1.5, b = 0), lwd = 2, lty = 2)
lines(theta, p2pl(theta, a = 3.0, b = 0), lwd = 2, lty = 3)
abline(h = 0.5, col = "gray")
legend("topleft", legend = c("a = 0.5", "a = 1.5", "a = 3.0"), lty = 1:3, lwd = 2, bty = "n")
par(mfrow = c(1, 1))

# --- 図2:1PL・2PL・3PLの比較(概念図) ---
par(mfrow = c(1, 3))
bs <- c(-1, 0, 1)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "1PL")
for (k in 1:3) lines(theta, p2pl(theta, a = 1.2, b = bs[k]), lwd = 2, lty = k)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "2PL")
as <- c(0.6, 1.5, 3.0)
for (k in 1:3) lines(theta, p2pl(theta, a = as[k], b = bs[k]), lwd = 2, lty = k)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "3PL")
for (k in 1:3) lines(theta, p2pl(theta, a = as[k], b = bs[k], c = 0.2), lwd = 2, lty = k)
abline(h = 0.2, col = "gray")
par(mfrow = c(1, 1))
p2pl() は式①をそのままRの関数にしたもので、c を0にすれば2PL、0より大きくすれば3PLになる。
Step 1:疑似データの生成
うつ症状チェックリスト(10項目、二値)を想定した疑似データを作る。ポイントは、全員の θ(抑うつの重さ)をまず生成し、その θ から各項目の回答を作ることである。こうすることで、「共通の潜在特性が項目間の相関を生む」というIRTの構造を、データに組み込める。
また、冒頭の悩みを再現するため、困難度の低い(軽い症状の)項目を多めに、重い症状の項目を少なめに設定する。
set.seed(2026)
N <- 1000   # 回答者数
J <- 10     # 項目数

# 真の項目パラメータ(軽い症状の項目が多い設計)
true_a <- c(1.2, 1.5, 0.8, 1.8, 1.0, 2.0, 1.4, 0.7, 2.2, 1.6)
true_b <- c(-2.4, -2.0, -1.8, -1.5, -1.3, -1.1, -0.8, -0.6, -0.3, 0.4)

# 真の θ(抑うつの重さ):標準正規分布
true_theta <- rnorm(N, mean = 0, sd = 1)

# 式①に従って『はい』の確率を計算し、回答(1 = はい, 0 = いいえ)を生成
P <- 1 / (1 + exp(-sweep(outer(true_theta, true_b, "-"), 2, true_a, "*")))
dat <- matrix(rbinom(N * J, size = 1, prob = P), nrow = N, ncol = J)
colnames(dat) <- paste0("Q", 1:J)

# 項目ごとの『はい』の割合と、合計点の分布
round(colMeans(dat), 2)
table(rowSums(dat))
outer(true_theta, true_b, "-") で「θ − b」を全員×全項目ぶん計算し、sweep() で項目ごとの識別力 a を掛けている。最後の table(rowSums(dat)) で、合計点が満点(10点)付近に人が集まっていることを確認してほしい。これが天井効果である。
Step 2:1PLと2PLを当てはめて比較する
# 1PL(Raschモデル:識別力を共通にしたモデル)
fit_1pl <- mirt(dat, model = 1, itemtype = "Rasch", verbose = FALSE)

# 2PL(識別力を項目ごとに推定)
fit_2pl <- mirt(dat, model = 1, itemtype = "2PL", verbose = FALSE)

# 尤度比検定と情報量規準による比較
anova(fit_1pl, fit_2pl)
model = 1 は「因子(潜在特性)が1つ」、つまり一次元モデルであることを指定している。出力は次のとおりである。
             AIC    SABIC       HQ      BIC    logLik      X2 df p
fit_1pl 9567.833 9586.882 9588.351 9621.818 -4772.916
fit_2pl 9480.412 9515.046 9517.718 9578.567 -4720.206 105.421  9 0
AIC・BICはいずれも2PLのほうが小さく(AIC:9480.4 vs. 9567.8、BIC:9578.6 vs. 9621.8)、尤度比検定も χ² = 105.4、自由度9で、P値は表示上0(P < 0.001)となった。自由度9は、2PLが1PLより推定するパラメータの数の差である(2PLは識別力10個+困難度10個=20個、Raschモデルは困難度10個+θ の分散1個=11個)。識別力が項目ごとに違うように作ったデータなので、2PLが選ばれるのは期待どおりの結果である。
なお、尤度比検定のP値は「1PLで十分」という仮説を棄却できるかどうかを判断するためのものであり、P値が小さいほど「2PLとの差が大きい」という意味ではない点に注意したい。
Step 3:項目パラメータ(識別力・困難度)を確認する
# IRTの通常のパラメータ化(a, b)で表示
est <- coef(fit_2pl, IRTpars = TRUE, simplify = TRUE)
round(est$items[, c("a", "b")], 2)

# 真値との比較
round(cbind(true_a, est_a = est$items[, "a"],
            true_b, est_b = est$items[, "b"]), 2)
mirt は内部では「傾き a1 と切片 d」の形($a\theta + d$)で推定している。IRTpars = TRUE を指定すると、本記事の式①と同じ「a と b」の形に変換して表示してくれる。2つの関係は $b = -d/a$ である。
真値との比較の出力は次のとおりである。
    true_a est_a true_b est_b
Q1     1.2  1.28   -2.4 -2.37
Q2     1.5  1.74   -2.0 -1.98
Q3     0.8  0.68   -1.8 -2.10
Q4     1.8  1.64   -1.5 -1.63
Q5     1.0  0.81   -1.3 -1.61
Q6     2.0  1.87   -1.1 -1.11
Q7     1.4  1.46   -0.8 -0.81
Q8     0.7  0.72   -0.6 -0.70
Q9     2.2  1.82   -0.3 -0.36
Q10    1.6  1.53    0.4  0.39
推定値は、おおむね真値の近くに戻ってきている。識別力は0.68〜1.87、困難度は−2.37〜0.39の範囲で、「軽い症状の項目が多く、重い症状の項目(Q10)が少ない」という設計どおりの姿が再現された。
細かく見ると、困難度のずれが大きいのは Q3(真値 −1.8 → 推定 −2.10)と Q5(−1.3 → −1.61)で、どちらも識別力の低い項目である。識別力が低い項目はICCがなだらかなので、「確率が0.5になる位置」をピンポイントで決めにくく、困難度の推定が不安定になりやすい。また、識別力の推定値にも、Q9(2.2 → 1.82)のように真値から0.4ほどずれる項目がある。N = 1000 でもこの程度の誤差は出る、という感覚を持っておくとよい。
Step 4:適合度を確認する
# 項目ごとの適合度(S-X2統計量)
itemfit(fit_2pl)

# モデル全体の適合度(M2統計量、RMSEA、CFI など)
M2(fit_2pl)

# 局所独立性の確認(Yen の Q3:残差どうしの相関)
Q3 <- residuals(fit_2pl, type = "Q3")
itemfit() は、既定で項目ごとの S-X² 統計量とRMSEA、P値を出す。出力は次のとおりである。
   item   S_X2 df.S_X2 RMSEA.S_X2 p.S_X2
1    Q1  3.081       7      0.000  0.877
2    Q2  4.880       7      0.000  0.675
3    Q3  7.275       7      0.006  0.401
4    Q4 10.119       6      0.026  0.120
5    Q5  9.227       7      0.018  0.237
6    Q6  2.370       6      0.000  0.883
7    Q7  4.049       6      0.000  0.670
8    Q8  6.246       6      0.006  0.396
9    Q9  7.984       5      0.024  0.157
10  Q10  4.697       4      0.013  0.320
すべての項目でP値は0.05を上回り(最小は Q4 の0.120)、RMSEAも0.03未満であった。モデルに大きく合わない項目は見当たらない。なお、項目数が多いと多重比較の問題が生じるので、実データでは、P値だけで機械的に項目を削除せず、ICCの形や項目の内容とあわせて判断する。
M2() の出力は次のとおりである。
          M2 df     p RMSEA RMSEA_5 RMSEA_95 SRMSR   TLI CFI
stats 26.956 35 0.833     0       0    0.014 0.021 1.006   1
M2 = 26.96(自由度35、P = 0.83)、RMSEA = 0(90%信頼区間 0〜0.014)、SRMSR = 0.021、CFI = 1 と、モデル全体の当てはまりも良好である。
ただし、これは2PLモデルそのものから生成した疑似データなので、当てはまりが良いのは当然の結果である。実データでは、ここまできれいな値になることはまずない。一次元性や局所独立性が崩れていれば、適合度は悪化する。そのときに検討するのが、本記事の最後で紹介する多次元IRTである。
最後の residuals(fit_2pl, type = "Q3") は、5章で説明した局所独立性の確認である。Yen の Q3 は、「モデルで説明しきれなかった残り(残差)」どうしの相関を、項目のペアごとに計算したものである。θ で説明しきれない共通の理由(内容の重複など)でつながっている項目のペアがあると、そのペアの Q3 が高くなる。実行すると、要約統計量と10×10の行列が表示される(Q3 <- で受け取っているのは、表示が二重にならないようにするためである)。今回の要約統計量は次のとおりである。
Q3 summary statistics:
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
 -0.241  -0.099  -0.072  -0.077  -0.046   0.023
Q3 は、局所独立性が成り立っていても平均がややマイナスに偏る性質がある(項目数が少ないほど偏りが大きい)。そのため、Q3 の値そのものではなく、「平均よりどれだけ高いか」を見るのがよいとされる。Christensen ら(2017)は、一律の基準値はないとしたうえで、平均より0.2程度以上高いペアを局所依存の候補とする目安を示している。今回は最大値0.023が平均(−0.077)より0.10高いだけで、局所独立性を疑わせるペアは見当たらなかった。モデルから生成したデータなので、これも期待どおりの結果である。
Step 5:ICCとテスト情報量を描く
# 全項目のICC(項目特性曲線)
plot(fit_2pl, type = "trace")

# 特定の項目のICCと項目情報量(例:Q9)
itemplot(fit_2pl, item = 9, type = "trace")
itemplot(fit_2pl, item = 9, type = "info")

# テスト情報量と標準誤差(図3)
plot(fit_2pl, type = "infoSE", theta_lim = c(-4, 4))
type = "infoSE" は、テスト情報量と標準誤差を1枚に重ねて描く(このとき latticeExtra パッケージが必要になる)。theta_lim は横軸の範囲で、既定は −6〜6 である。両端では標準誤差が非常に大きくなって右の目盛りが引き伸ばされ、グラフが読みにくくなるので、ここでは −4〜4 に絞っている。
出力が4章の図3である。今回のデータでは困難度の低い項目が多いため、情報量の山は θ = −1.2 付近(軽症域)に寄り、θ の高い側(重症域)では標準誤差が急激に大きくなった。これが、カメラのピントの例えで説明した天井効果の姿である。
情報量の数値そのものを見たい場合は、testinfo() を使う。
theta_grid <- matrix(seq(-3, 3, by = 1))
info <- testinfo(fit_2pl, Theta = theta_grid)
round(data.frame(theta = theta_grid[, 1], info = info, SE = 1 / sqrt(info)), 2)
最後の列が、式②の $1/\sqrt{I(\theta)}$ である。
Step 6:θ を推定し、合計点と比べる
# θ の推定(EAP推定)
theta_hat <- fscores(fit_2pl, method = "EAP")

# 合計点と θ の関係
sum_score <- rowSums(dat)
plot(jitter(sum_score, amount = 0.2), theta_hat[, 1],
     xlab = "Sum score", ylab = expression(hat(theta)),
     main = expression(paste("Sum score vs. estimated ", theta)), pch = 16, col = rgb(0, 0, 0, 0.3))

# 合計点ごとの θ の範囲
round(t(sapply(split(theta_hat[, 1], sum_score),
               function(x) c(min = min(x), max = max(x)))), 2)

# 合計点ごとの θ の平均
round(tapply(theta_hat[, 1], sum_score, mean), 2)
split() を使った行では、θ の推定値を合計点ごとに分け、それぞれの最小値と最大値を表にしている。最後の行は、合計点ごとの θ の平均である(図4の3つ目の読み取りで使う)。
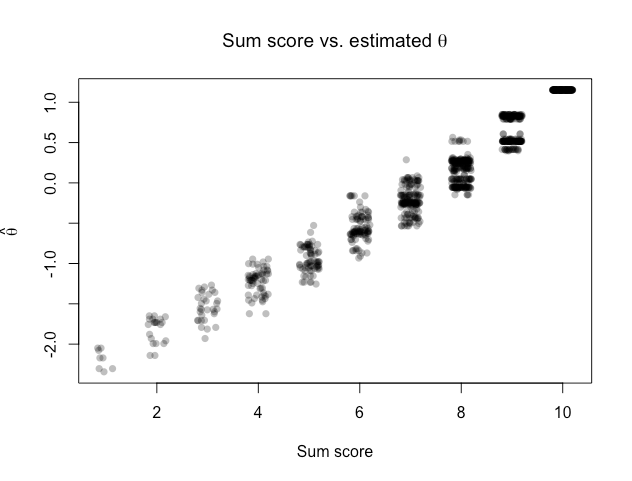
図4:合計点と θ の推定値の関係(横軸の点は、重なりを避けるために左右に少しずらしている)
図4から、3つのことが読み取れる。
1つ目は、同じ合計点でも、θ の推定値に幅があることである。たとえば合計点6点の人たちは、θ がおよそ −0.9〜−0.2 の範囲に散らばっている。2PLでは、識別力の高い項目に『はい』と答えるほうが θ の推定値に強く効くため、同じ6点でも、どの項目に『はい』と答えたかによって θ が変わるのである。合計点9点の列が数個のかたまりに分かれているのは、「どの1項目に『いいえ』と答えたか」の違いがそのまま表れているためだ。(1PLでは、合計点が同じなら θ の推定値も同じになる。これも1PLと2PLの違いの1つである。)
2つ目は、合計点10点(満点)の人は、全員が同じ θ(約1.1)になっていることである。満点の人は「全項目に『はい』」という同じ回答パターンなので、θ の推定値も1つに決まる。しかし、図3で見たとおり、この尺度は重症域の情報量が乏しい。真の θ が1.5の人も3.0の人も、この尺度では「満点」としか記録されず、区別できない。これが天井効果の正体である。特に真の θ が非常に高い人では、θ の推定値(約1.1)が実際の重症度を過小評価することになる点に注意したい。
3つ目は、合計点1点あたりの θ の上がり幅が一定ではないことである。合計点ごとに θ の推定値の平均を求めると(tapply(theta_hat[, 1], sum_score, mean))、1点から8点までは、1点上がるごとに θ が0.28〜0.39ずつ上がっていた。ところが、8点→9点、9点→10点では、上がり幅がどちらも約0.50に広がっていた。高得点側の1点は、低得点側の1点よりも、θ の差として大きいのである。合計点の「1点」の重さが、尺度のどこにいるかによって違うことが、ここからも読み取れる。冒頭の「3点→1点と10点→8点は同じ2点の改善か?」という問いへの答えは、「同じとは限らない」である。
7. 論文でそのまま使える英文テンプレート
以下は記述例である。Resultsの数値は本記事の疑似データの解析結果(6章の出力)にもとづくものなので、実際の解析結果に置き換えて使ってほしい。なお、Methodsにある一次元性の確認(探索的因子分析)は、6章のスクリプトには含めていない。実データでは必ず実施してほしい。一次元性の確認と、それが崩れたときの対処は、多次元IRTの記事で扱う。
Methods
We applied item response theory (IRT) to evaluate the psychometric properties of the 10-item depressive symptom checklist. Unidimensionality was first examined using exploratory factor analysis of the tetrachoric correlation matrix. We then fitted the one-parameter logistic (Rasch) model and the two-parameter logistic (2PL) model, and compared them using the likelihood ratio test, the Akaike information criterion (AIC), and the Bayesian information criterion (BIC). Model fit was assessed using the M2 statistic and the root mean square error of approximation (RMSEA), and item fit was assessed using the S-X2 statistic. Local independence was examined using Yen’s Q3 statistic. Item parameters were estimated by marginal maximum likelihood, and individual latent trait scores (θ) were estimated using the expected a posteriori (EAP) method. All analyses were conducted using the mirt package (version X.X) in R (version X.X.X).
(日本語訳)10項目の抑うつ症状チェックリストの心理測定学的特性を評価するため、項目反応理論(IRT)を適用した。まず、テトラコリック相関行列にもとづく探索的因子分析により一次元性を検討した。次に、1パラメータ・ロジスティック(Rasch)モデルと2パラメータ・ロジスティック(2PL)モデルを当てはめ、尤度比検定、赤池情報量規準(AIC)、ベイズ情報量規準(BIC)により比較した。モデルの適合度はM2統計量と近似誤差二乗平均平方根(RMSEA)で、項目の適合度はS-X² 統計量で評価した。局所独立性はYenのQ3統計量で検討した。項目パラメータは周辺最尤法で推定し、個人の潜在特性値(θ)はEAP法で推定した。解析にはR(バージョンX.X.X)のmirtパッケージ(バージョンX.X)を用いた。
Results
The 2PL model showed better fit than the Rasch model (AIC, 9480.4 vs. 9567.8; BIC, 9578.6 vs. 9621.8; likelihood ratio test, χ2 = 105.4, df = 9, P < 0.001). The overall fit of the 2PL model was good (M2 = 26.96, df = 35, P = 0.83; RMSEA = 0.000 [90% CI, 0.000–0.014]; SRMSR = 0.021; CFI = 1.00), and no item showed significant misfit according to the S-X2 statistic (all P > 0.10). No item pair showed evidence of local dependence (Yen’s Q3: maximum, 0.02; mean, −0.08). Item discrimination parameters ranged from 0.68 to 1.87, and item difficulty parameters ranged from −2.37 to 0.39. The test information function peaked at around θ = −1.2, indicating that the checklist measured mild to moderate depressive symptoms most precisely, whereas measurement precision was lower at the severe end of the latent trait.
(日本語訳)2PLモデルは、Raschモデルより良好な当てはまりを示した(AIC:9480.4 vs. 9567.8、BIC:9578.6 vs. 9621.8、尤度比検定 χ² = 105.4、自由度9、P < 0.001)。2PLモデルの全体的な適合度は良好であり(M2 = 26.96、自由度35、P = 0.83、RMSEA = 0.000[90%信頼区間 0.000〜0.014]、SRMSR = 0.021、CFI = 1.00)、S-X² 統計量で有意な不適合を示した項目はなかった(すべて P > 0.10)。局所依存を示す項目ペアも認められなかった(Yen の Q3:最大値0.02、平均値−0.08)。項目の識別力パラメータは0.68〜1.87、困難度パラメータは−2.37〜0.39の範囲であった。テスト情報量は θ = −1.2 付近で最大となり、本チェックリストは軽度〜中等度の抑うつ症状を最も精密に測定する一方、潜在特性の重症側では測定精度が低いことが示された。
8. まとめ
- 合計点は、すべての項目を「同じ重さの1点」として数えている。IRTは、項目ごとの困難度 b(『はい』の確率が五分五分になるのは、どのくらい重い人か)と識別力 a(どれだけくっきり見分けられるか)を考慮して、潜在特性 θ を推定する。
- 項目特性曲線(ICC)は、θ ごとの『はい』の確率を表すS字曲線で、b が位置、a が傾きを決める。
- 1PLは識別力を共通、2PLは項目ごと、3PLは当て推量の下限 c を加えたモデル。臨床の二値項目の質問票では、1PLか2PLが一般的である。
- テスト情報量は「尺度がどの θ の範囲を精密に測れるか」を示し、$SE(\theta) \approx 1/\sqrt{I(\theta)}$ で測定誤差に直結する。天井効果・床効果は、情報量の山が偏っている状態と言い換えられる。
- IRTは一次元性・局所独立性を前提とする。前提の確認を省略してはいけない。
本記事では、すべての項目が「1つの特性」を測っている一次元IRTを扱った。しかし実際の質問票では、「抑うつ」と「不安」のように、複数の特性が混ざっていることも多い。一次元性の前提が成り立たない場合に使うのが、多次元項目反応理論(MIRT)である。続きは多次元項目反応理論の記事で解説している。
一括コピペ用Rスクリプト
# ============================================
# 項目反応理論(IRT)の基礎:mirtによる2PL分析
# ============================================
# install.packages(c("mirt", "latticeExtra"))  # 初回のみ
library(mirt)
# latticeExtra は、Step 5 の plot(type = "infoSE") で
# 情報量と標準誤差を2軸で重ねて描くときに使われる(library() での読み込みは不要)

# ---- Step 0:概念図(図1・図2) ----
theta <- seq(-4, 4, length.out = 200)
p2pl  <- function(theta, a, b, c = 0) c + (1 - c) / (1 + exp(-a * (theta - b)))

par(mfrow = c(1, 2))
plot(theta, p2pl(theta, a = 1.5, b = -1), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = expression(theta), ylab = "P(Yes)", main = "Varying difficulty (b)")
lines(theta, p2pl(theta, a = 1.5, b = 0), lwd = 2, lty = 2)
lines(theta, p2pl(theta, a = 1.5, b = 1), lwd = 2, lty = 3)
abline(h = 0.5, col = "gray")
legend("topleft", legend = c("b = -1", "b = 0", "b = 1"), lty = 1:3, lwd = 2, bty = "n")
plot(theta, p2pl(theta, a = 0.5, b = 0), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = expression(theta), ylab = "P(Yes)", main = "Varying discrimination (a)")
lines(theta, p2pl(theta, a = 1.5, b = 0), lwd = 2, lty = 2)
lines(theta, p2pl(theta, a = 3.0, b = 0), lwd = 2, lty = 3)
abline(h = 0.5, col = "gray")
legend("topleft", legend = c("a = 0.5", "a = 1.5", "a = 3.0"), lty = 1:3, lwd = 2, bty = "n")
par(mfrow = c(1, 1))

par(mfrow = c(1, 3))
bs <- c(-1, 0, 1)
as <- c(0.6, 1.5, 3.0)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "1PL")
for (k in 1:3) lines(theta, p2pl(theta, a = 1.2, b = bs[k]), lwd = 2, lty = k)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "2PL")
for (k in 1:3) lines(theta, p2pl(theta, a = as[k], b = bs[k]), lwd = 2, lty = k)
plot(NA, xlim = c(-4, 4), ylim = c(0, 1), xlab = expression(theta), ylab = "P(Yes)", main = "3PL")
for (k in 1:3) lines(theta, p2pl(theta, a = as[k], b = bs[k], c = 0.2), lwd = 2, lty = k)
abline(h = 0.2, col = "gray")
par(mfrow = c(1, 1))

# ---- Step 1:疑似データの生成 ----
set.seed(2026)
N <- 1000
J <- 10
true_a <- c(1.2, 1.5, 0.8, 1.8, 1.0, 2.0, 1.4, 0.7, 2.2, 1.6)
true_b <- c(-2.4, -2.0, -1.8, -1.5, -1.3, -1.1, -0.8, -0.6, -0.3, 0.4)
true_theta <- rnorm(N, mean = 0, sd = 1)
P <- 1 / (1 + exp(-sweep(outer(true_theta, true_b, "-"), 2, true_a, "*")))
dat <- matrix(rbinom(N * J, size = 1, prob = P), nrow = N, ncol = J)
colnames(dat) <- paste0("Q", 1:J)
round(colMeans(dat), 2)
table(rowSums(dat))

# ---- Step 2:1PLと2PLの比較 ----
fit_1pl <- mirt(dat, model = 1, itemtype = "Rasch", verbose = FALSE)
fit_2pl <- mirt(dat, model = 1, itemtype = "2PL", verbose = FALSE)
anova(fit_1pl, fit_2pl)

# ---- Step 3:項目パラメータ ----
est <- coef(fit_2pl, IRTpars = TRUE, simplify = TRUE)
round(est$items[, c("a", "b")], 2)
round(cbind(true_a, est_a = est$items[, "a"],
            true_b, est_b = est$items[, "b"]), 2)

# ---- Step 4:適合度 ----
itemfit(fit_2pl)
M2(fit_2pl)
Q3 <- residuals(fit_2pl, type = "Q3")

# ---- Step 5:ICCとテスト情報量 ----
plot(fit_2pl, type = "trace")
itemplot(fit_2pl, item = 9, type = "trace")
itemplot(fit_2pl, item = 9, type = "info")
plot(fit_2pl, type = "infoSE", theta_lim = c(-4, 4))
theta_grid <- matrix(seq(-3, 3, by = 1))
info <- testinfo(fit_2pl, Theta = theta_grid)
round(data.frame(theta = theta_grid[, 1], info = info, SE = 1 / sqrt(info)), 2)

# ---- Step 6:θ の推定と合計点との比較 ----
theta_hat <- fscores(fit_2pl, method = "EAP")
sum_score <- rowSums(dat)
plot(jitter(sum_score, amount = 0.2), theta_hat[, 1],
     xlab = "Sum score", ylab = expression(hat(theta)),
     main = expression(paste("Sum score vs. estimated ", theta)), pch = 16, col = rgb(0, 0, 0, 0.3))
round(t(sapply(split(theta_hat[, 1], sum_score),
               function(x) c(min = min(x), max = max(x)))), 2)
round(tapply(theta_hat[, 1], sum_score, mean), 2)
参考文献
- Reeve BB, Hays RD, Bjorner JB, et al. Psychometric evaluation and calibration of health-related quality of life item banks: plans for the Patient-Reported Outcomes Measurement Information System (PROMIS). Medical Care. 2007;45(5 Suppl 1):S22–S31. https://pubmed.ncbi.nlm.nih.gov/17443115/
- Edelen MO, Reeve BB. Applying item response theory (IRT) modeling to questionnaire development, evaluation, and refinement. Quality of Life Research. 2007;16(Suppl 1):5–18. doi:10.1007/s11136-007-9198-0
- Bevans M, Ross A, Cella D. Patient-Reported Outcomes Measurement Information System (PROMIS): efficient, standardized tools to measure self-reported health and quality of life. Nursing Outlook. 2014;62(5):339–345. https://pmc.ncbi.nlm.nih.gov/articles/PMC4179871/
- Christensen KB, Makransky G, Horton M. Critical values for Yen’s Q3: identification of local dependence in the Rasch model using residual correlations. Applied Psychological Measurement. 2017;41(3):178–194. doi:10.1177/0146621616677520
- Chalmers RP. mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software. 2012;48(6):1–29. doi:10.18637/jss.v048.i06
おすすめ書籍
- 加藤健太郎・山田剛史・川端一光『Rによる項目反応理論』オーム社(2014)
https://www.amazon.co.jp/dp/4274050173- Rで実際に手を動かしながらIRTを学べる一冊。本記事の次に読む本としておすすめである。
- 豊田秀樹『項目反応理論[入門編](第2版)』朝倉書店(2012)
https://www.amazon.co.jp/dp/4254127952- 日本語でIRTを学ぶ定番の教科書。全編でRによる実習ができる。尺度定数 D = 1.7 を含む式の形はこの本で確認できる。
- 高橋信『IRT項目反応理論入門:統計学の基礎から学ぶ良質なテストの作り方』オーム社
https://www.amazon.co.jp/dp/4274227685- 副題のとおり、統計学の基礎からIRTを学べる入門書。数式に不安がある読者は、こちらから読むとよい。

コメント
コメント一覧 (1件)
[…] なお、同じような質問票データを「項目ごとの回答確率」という別の角度から分析するのが、項目反応理論(IRT)である。IRTの考え方は項目反応理論(IRT)の基礎で解説している。 […]