若手医師:抑うつ症状の質問票(8項目)の因子構造を確かめています。各項目は「0:全くない」「1:数日」「2:半分以上」「3:ほとんど毎日」の4段階です。「気分の症状」4項目と「身体の症状」4項目の2因子モデルで確認的因子分析(CFA)をしたら、適合度は良好でした。
統計担当:それはよかった。因子負荷量はどうだった?
若手医師:それが、思ったより低いんです。先行研究では0.8前後の項目が、0.5〜0.7台しかなくて。回答は「0」がほとんどで、6割くらいの人が「0」を選んでいます。
統計担当:なるほど。そのCFA、0〜3点を連続量として扱って、ふつうの相関(ピアソン相関)をもとに計算していない? 4段階しかない、しかも「0」に偏った点数どうしの相関は、本当の関係より小さく出やすいんだ。
若手医師:適合度が良くても、ですか?
統計担当:適合度は「モデルの形がデータと矛盾しないか」を見る指標だから、形が合っていれば良好と出ることもある。でも、負荷量の大きさそのものが、全体に小さめに推定されてしまうことがあるんだ。
0〜3点のような段階の点数は、症状の強さという「本来はなめらかな量」を、粗い目盛りで読み取った結果である。目盛りが粗いほど、そして回答が一方に偏るほど、点数どうしの相関は、本来の関係より小さく出る。
そこで、段階の裏にある「見えない連続量」どうしの相関を推定しようというのが、ポリコリック相関(polychoric correlation)である。本記事では、ポリコリック相関の考え方と、それが万能ではない理由、そして順序尺度の因子分析(探索的・確認的)での使い方を、Rで手を動かしながら確認していく。
なお、同じような質問票データを「項目ごとの回答確率」という別の角度から分析するのが、項目反応理論(IRT)である。IRTの考え方は項目反応理論(IRT)の基礎で解説している。
1. 段階の裏にある「見えない連続量」
1-1. 川の水位と警戒レベル
川の水位を思い浮かべてほしい。水位は本来、なめらかに上がったり下がったりする連続量である。ところが、私たちに知らされるのが「レベル1〜4」の4段階の警戒レベルだけだったとしたらどうだろう。同じ「レベル2」の中にも、レベル1寄りの低い水位もあれば、レベル3寄りの高い水位もある。段階の情報だけでは、その違いは見えない。
質問票の回答も同じように考えることができる。「抑うつ気分の強さ」は、本来は人によってなめらかに異なる連続量だと考えられる。しかし、私たちが観測できるのは「0〜3」のどれを選んだか、という段階の情報だけである。
1-2. 閾値で区切る:本記事の式
この考え方を式で書くと、次のようになる。観測された回答を $X$、その裏にある見えない連続量(潜在変数)を $X^*$ とすると、
$$
X = k \quad \Longleftrightarrow \quad \tau_k < X^* \le \tau_{k+1} \qquad (k = 0, 1, 2, 3)
$$
ここで $\tau_1, \tau_2, \tau_3$ は閾値(いきち、threshold)と呼ばれる区切りの位置である(両端は $\tau_0 = -\infty$、$\tau_4 = +\infty$ とする)。つまり、「潜在変数 $X^*$ が $\tau_1$ 以下なら『0』と答え、$\tau_1$ と $\tau_2$ の間なら『1』と答え……」というルールで、連続量が段階に変換されていると考えるのである。
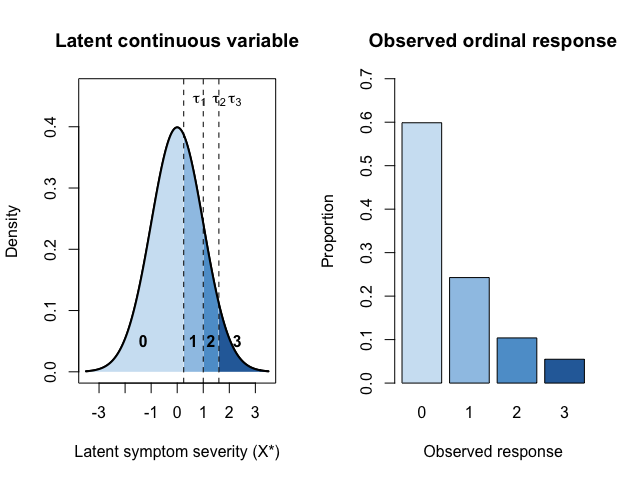
【図1:潜在変数を閾値で区切ると、段階の回答になる(左:潜在変数の分布と3本の閾値、右:観測される回答の割合)】
(図1はStep 0のコードで作成)
ポリコリック相関では、潜在変数 $X^*$ が標準正規分布に従うと仮定する。すると、閾値の位置は、各段階を選んだ人の割合から決まる。たとえば「0」と答えた人が全体の60%なら、$\tau_1$ は「標準正規分布で、下から60%の位置」、つまり約0.25になる。「0」か「1」と答えた人が84%なら、$\tau_2$ は下から84%の位置で、約1.0である。
図1の例では、閾値が右(重症側)に寄っているため、多くの人が「0」に集まっている。冒頭の質問票のように、回答が「0」に偏るのはこういう状況である。閾値の間隔が等間隔でないことにも注目してほしい。段階の点数(0, 1, 2, 3)は等間隔でも、その裏にある潜在変数の上での区切りは、等間隔とは限らないのである。
2. ポリコリック相関とは:2つの見えない連続量の相関
2-1. 2変量正規分布を格子で区切る
ここまでは1つの項目の話だった。相関は2つの項目の関係なので、項目Aの潜在変数 $X^$ と、項目Bの潜在変数 $Y^$ を同時に考える。
ポリコリック相関では、この2つの潜在変数が2変量正規分布に従うと仮定する。2変量正規分布は、等高線で描くと楕円形の山になる。相関が強いほど、楕円は細長く斜めに伸びる。
この山を、項目Aの閾値(縦線)と項目Bの閾値(横線)で区切ると、4×4=16個のマス目ができる。各マス目に入る確率が、「項目Aで $i$ と答え、項目Bで $j$ と答える人の割合」に対応する。
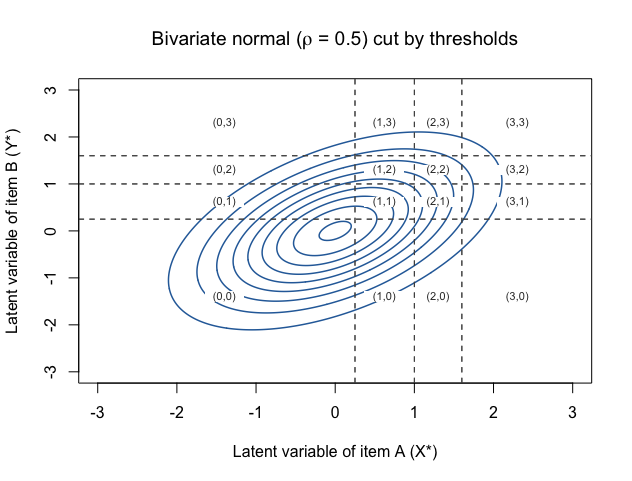
【図2:2変量正規分布(相関0.5)を閾値の格子で区切った図】
(図2はStep 0のコードで作成)
私たちが手にしているデータは、2項目の回答のクロス表(4×4の度数表)である。ポリコリック相関は、「観測されたクロス表を最もよく再現する、楕円の傾き(相関 $\rho$)はいくつか」を探すことで推定される。
例えるなら、マス目ごとの人数という「影」から、光を当てる前の立体の形(楕円の傾き)を逆算するようなものである。影の形がわかれば、元の立体の傾きをある程度推し量ることができる。
ここで大事なのは、ポリコリック相関は観測された点数どうしの相関ではない、という点である。あくまで、「裏に連続した潜在変数があり、それらが2変量正規分布に従う」という仮定のもとで推定した、潜在変数どうしの相関である。
※コラム:テトラコリック相関・ポリシリアル相関 ― 同じ発想の親戚たち
ポリコリック相関には、組み合わせる変数の種類によって名前の違う親戚がいる。
2つの変数の組み合わせ 名前 順序カテゴリ × 順序カテゴリ ポリコリック相関(polychoric) 2値 × 2値(「はい/いいえ」同士) テトラコリック相関(tetrachoric) 順序カテゴリ × 連続量 ポリシリアル相関(polyserial) テトラコリック相関はポリコリック相関の特別な場合(段階が2つずつ)で、歴史的にはこちらが先にPearson(1900)によって提案された。
名前の由来も見ておこう。「コリック(-choric)」は、ギリシャ語で「場所・区画」を意味する言葉(chōra)に由来する。テトラコリック(tetrachoric)の「テトラ」は「4」で、「4つの区画をもつ表(2×2のクロス表)から求める相関」という意味になる。ポリコリック(polychoric)の「ポリ」は「多くの」で、「多くの区画をもつ表(4×4などのクロス表)から求める相関」である。図2の格子のマス目が、まさにこの「区画」にあたる。
ポリシリアル(polyserial)の「シリアル」は「系列(series)」に由来する。連続量と2値の変数の相関を「バイシリアル(biserial)相関」と呼び、その2値の側を多段階に広げたものがポリシリアル相関である。いずれも「観測されたカテゴリの裏に連続した潜在変数があり、正規分布に従う」という同じ発想に立っている。順序変数と連続変数が混在するデータでは、Rの
polycorパッケージのhetcor()関数で、組み合わせに応じた相関をまとめて計算できる。
※コラム:2段階推定と完全な最尤法
ポリコリック相関の推定には、大きく2つの方法がある(Olsson, 1979)。
- 完全な最尤法:閾値と相関 $\rho$ を、クロス表全体から同時に推定する。
- 2段階推定:まず、各項目の回答の割合から閾値を決める(1-2節で説明した方法)。次に、閾値を固定したうえで、相関 $\rho$ だけを推定する。
2段階推定は計算が速く、結果も完全な最尤法とほとんど変わらないことが多いため、実務ではこちらが標準的に使われる。本記事で使う
psych::polychoric()もpolycor::polychor()も、既定では2段階推定の考え方で計算している。
3. なぜピアソン相関では小さく出るのか
3-1. 粗い目盛りは相関を薄める
連続量を段階に区切ると、同じ段階の中にいる人どうしの違いが消えてしまう。水位の例でいえば、「レベル2」の中の高い水位も低い水位も、すべて「2」として扱われる。この情報の損失のせいで、段階の点数どうしのピアソン相関は、潜在変数どうしの相関より小さく出る。これを相関の減衰(attenuation)という。
減衰の程度は、主に次の2つで決まる。
- 段階の数:段階が少ないほど、情報の損失が大きく、相関は大きく薄まる。
- 回答の偏り:回答が一方の端に集中する(床効果・天井効果)ほど、相関は大きく薄まる。
実際にどれくらい薄まるのかを、シミュレーションで確かめた(コードは6章のStep 7)。真の相関を0.5に固定した2変量正規分布から500人分のデータを作り、段階の数(2・3・5・7段階)と回答の偏り(偏りなし/偏りあり)を変えて段階に区切った。そのうえで、ピアソン相関、スピアマン相関、ポリコリック相関を計算し、200回繰り返した平均を比べた。
【図3:段階の数・回答の偏りと、相関係数の推定値(真の相関は0.5)】
| 段階の数 | 偏り | ピアソン | スピアマン | ポリコリック |
|---|---|---|---|---|
| 2 | なし | 0.327 | 0.327 | 0.491 |
| 3 | なし | 0.406 | 0.405 | 0.496 |
| 5 | なし | 0.456 | 0.456 | 0.503 |
| 7 | なし | 0.468 | 0.467 | 0.502 |
| 2 | あり | 0.276 | 0.276 | 0.493 |
| 3 | あり | 0.366 | 0.346 | 0.507 |
| 5 | あり | 0.409 | 0.394 | 0.496 |
| 7 | あり | 0.430 | 0.420 | 0.499 |
ポリコリック相関は、どの条件でも平均して真の値0.5の近くにある。一方、ピアソン相関とスピアマン相関は、段階が少ないほど、また回答が偏っているほど、真の値から大きく下にずれている。2段階で偏りがある場合、ピアソン相関の平均は0.276で、真の値のほぼ半分である。
ただし、このシミュレーションは、潜在変数が本当に2変量正規分布に従うようにデータを作っている。つまり、ポリコリック相関の前提が完全に成り立つ、ポリコリック相関に有利な条件での結果である点には注意してほしい。前提が崩れた場合の話は、4章で扱う。
3-2. 因子分析への影響
相関が薄まると、その相関行列から計算する因子分析の結果にも影響が出る。代表的なのは次の点である。
- 因子負荷量が小さく推定される(冒頭の若手医師の悩み)
- 因子数の判断や、因子間相関の推定がずれることがある
- 確認的因子分析(CFA)の適合度の評価が変わることがある
Holgado-Tello ら(2010)は、順序変数の探索的・確認的因子分析で、ピアソン相関よりポリコリック相関のほうが、もとの因子構造をより正確に再現することを示している。臨床の例として、Kiwanuka ら(2022)は、看護師からの支援に対する家族800人の評価(リッカート形式)を分析し、ポリコリック相関がピアソン相関より平均で約14%大きかったこと、ポリコリック相関にもとづくCFAは複数の基準で適合した一方、ピアソン相関にもとづくCFAは適合しなかったことを報告している。
ただし、適合度への影響はデータによって異なる。6章の疑似データでは、ピアソン相関(連続扱い)にもとづくCFAでも適合度は良好で、違いが出たのは主に負荷量の大きさだった。
※コラム:スピアマン相関なら大丈夫?
「順序データにはスピアマン相関」と習った人も多いだろう。スピアマン相関は、データを順位に置き換えてから計算するピアソン相関である。外れ値の影響を受けにくく、単調な関係をとらえる、という利点がある。
しかし、スピアマン相関は観測された順位どうしの相関であって、潜在変数の相関を推定するものではない。0〜3点の4段階しかないデータでは、同じ順位(同順位、タイ)の人が大量に出るため、段階に区切ったことによる情報の損失は、そのまま残る。上の表でも、スピアマン相関はピアソン相関とほぼ同じか、むしろ少し小さい値になっている。
「順序データだからスピアマン」は、減衰の問題の解決にはならない、ということである。
※コラム:リッカート尺度を「連続量」として扱うこととの関係
心理学や臨床研究では、5段階のリッカート尺度の回答(1〜5点)を、そのまま連続量として扱って平均や相関を計算することがよくある。実は、この慣習とポリコリック相関は、「段階の裏には連続量がある」という同じ発想に立っている。
そもそも、リッカート尺度の採点法の出発点にも、この発想がある。小杉考司先生が解説しているように、リッカート式の採点は、「態度は正規分布に従う」という仮定にもとづいて段階に数値を割り振るサーストンの方法を、簡便にしたものである(リッカート自身はこれを「シグマ法」と呼んだ)。そのうえでリッカートは、シグマ法の得点と、1〜5点を等間隔に割り振るだけの簡便な得点との相関が約0.99と非常に高いことを示した(Likert, 1932;Ferguson, 1941)。手間のかからない簡便な方法が広まったのは、このためである。
では、両者は何が違うのか。ポイントは目盛りの間隔の扱いである。
- 1〜5点をそのまま連続量として扱う:段階と段階の間隔が、すべて等しいと仮定している(定規の目盛りが等間隔であるのと同じ)。
- ポリコリック相関:閾値の位置をデータから推定するので、間隔が不揃いでもかまわない。さらに、段階に区切ったことによる相関の薄まりも補正する。
では、連続量として扱ってよいのはどんなときか。構造方程式モデリングのシミュレーション研究(Rhemtulla et al., 2012)では、5段階以上で回答の偏りが小さければ、連続量として扱っても大きな問題は少なく、5段階未満の場合や偏りが強い場合は、カテゴリカルな方法(ポリコリック相関にもとづく方法)が勧められている。上の表でも、偏りのない5段階や7段階では、ピアソン相関の薄まりは比較的小さい(0.456、0.468)。また、Norman(2010)は、リッカート尺度の得点に t検定などの通常の統計手法を使っても、結論がゆがむことは少ないと論じている。
冒頭の質問票は「4段階・回答が0に偏っている」という、まさに連続量として扱うのが苦手な条件にあてはまる。だからこそ、ポリコリック相関の出番になるのである。
4. ポリコリック相関は万能ではない:前提と罠
ここまで読むと、「順序データなら、いつでもポリコリック相関を使えばよい」と思うかもしれない。しかし、ポリコリック相関は強い仮定の上に成り立っている。前提と罠を押さえておこう。
4-1. 前提①:裏に連続した潜在変数があると考えられること
ポリコリック相関は、「段階の裏に連続量がある」と考えられる変数にのみ使う。症状の強さ、満足度、同意の程度などは、この考え方になじむ。一方、性別や血液型、診療科のように、本来がカテゴリそのものである変数に使うのは不適切である。裏に連続量を想定する理由がないからである。
4-2. 前提②:潜在変数が2変量正規分布に従うこと
ポリコリック相関は、潜在変数の2変量正規性を仮定している。Flora & Curran(2004)のシミュレーションでは、潜在変数の分布が正規分布から中程度にずれる程度なら、ポリコリック相関の推定は比較的頑健だった。しかし、極端に歪んだ分布では、偏りが大きくなることが示されている。
潜在変数そのものは観測できないので、この前提を直接確かめることはできない。ただし、polycor::polychor() は、「2変量正規性の仮定のもとで期待されるクロス表と、観測されたクロス表のずれ」を検定する結果を出力してくれる(6章のStep 3)。この検定で有意にならなくても、前提が正しいと証明されたわけではない点には注意してほしい。
4-3. 罠①:度数0のマス目(空セル)
クロス表のマス目に、度数0のセル(空セル)があると、推定が不安定になる。回答が偏っている項目どうしや、サンプルサイズが小さい場合によく起こる(たとえば「どちらの項目でも3と答えた人が1人もいない」)。
psych::polychoric() は、既定で空セルに0.5を足す補正(連続性補正)を行い、警告を出す。警告が出たら、まずクロス表を確認し、度数が極端に少ない段階を隣の段階と統合することを検討するとよい。
4-4. 罠②:相関行列が「正定値」でなくなることがある
ポリコリック相関は、項目の組ごとに別々に推定する。そのため、全体をまとめた相関行列が、数学的に矛盾を含む(正定値でない)ことがある。こうなると、因子分析などがそのままでは計算できない。psych::polychoric() は、既定でこの矛盾を最小限に修正する処理(スムージング)を行う。論文では、スムージングを行ったかどうかを報告するとよい。
※コラム:「正定値」とは?
相関行列には、数学的に満たすべき「つじつま」がある。たとえば、3つの項目A・B・Cについて、「AとBの相関が0.9」「BとCの相関が0.9」なのに「AとCの相関が−0.9」という組み合わせはありえない。AとBがほぼ同じように動き、BとCもほぼ同じように動くなら、AとCも同じように動くはずだからである。
このつじつまが合っている状態を、数学の言葉で正定値(positive definite)という。正確には、「項目をどんな重みで足し合わせても、その合計の分散が必ず正になる」という性質で、相関行列の固有値がすべて正であることと同じ意味である。上の例のように、つじつまの合わない相関行列から計算すると、「分散が負になる合計点」が存在することになってしまう。
実際のデータからふつうに計算したピアソン相関行列は、全員のデータを一度に使って計算しているので、(欠測値をペアごとに処理した場合や、人数が項目数より少ない場合などを除けば)つじつまが崩れることはない。一方、ポリコリック相関は項目の組ごとに別々に推定するため、1つ1つは妥当な値でも、全体としてのつじつまが少し崩れることがある。地図を区画ごとに別々に測量してつなぎ合わせると、継ぎ目がわずかにずれることがあるのと似ている。スムージングは、この継ぎ目のずれを、全体として最小限の修正でならす作業である。
4-5. 罠③:サンプルサイズが小さいと推定誤差が大きい
ポリコリック相関は、ピアソン相関より推定のばらつき(標準誤差)が大きい。段階が細かく、回答が偏っているほど、各マス目の度数が少なくなり、推定は不安定になる。「何人いれば十分」という一律の目安はないが、少ないサンプルで得られた値は、標準誤差とあわせて解釈したい。
4-6. 罠④:観測された点数の関連とは別物
ポリコリック相関は「潜在変数どうしの相関」の推定値である。「観測された点数どうしが、どの程度一緒に動いているか」を記述したい場合(たとえば、記述統計として項目間の関連を示したい場合)には、ピアソン相関やスピアマン相関のほうが目的に合う。どちらが正しいかではなく、何を知りたいかで使い分けるものである。
※コラム:順序α(ordinal alpha)
ポリコリック相関行列からα係数を計算したものを、順序α(ordinal alpha)と呼ぶ(Zumbo et al., 2007)。段階の点数から計算した通常のα係数より、大きな値になりやすい。
ただし、順序αは「潜在変数(連続量)を合計したと仮定したときの信頼性」を表すもので、実際に観測された合計点の信頼性ではない(Chalmers, 2018)。臨床研究で合計点を使うなら、その合計点の信頼性は通常のα係数などで評価するのが筋である。順序αの値が大きいからといって、合計点の精度が高いことにはならない点に注意したい。なお、順序αの使い方については、研究者の間でも議論がある(Zumbo & Kroc, 2019)。
5. 正攻法:順序尺度の因子分析の標準的な流れ
5-1. 分析の流れ
4段階程度のリッカート形式の質問票で因子構造を調べる場合、標準的な流れは次のようになる(Flora & Curran, 2004;Holgado-Tello et al., 2010)。
- 回答分布とクロス表の確認:各項目の段階ごとの割合を確認し、偏りや、空セルになりそうな段階がないかを見る。
- ポリコリック相関行列の計算:空セルの補正やスムージングが行われたかも確認する。
- 因子数の目安を得る:ポリコリック相関行列にもとづく平行分析などを使う。
- 探索的因子分析(EFA):ポリコリック相関行列にもとづいて因子を抽出し、必要に応じて斜交回転を行う。
- 確認的因子分析(CFA):項目を順序変数として指定し、ポリコリック相関にもとづく推定法(WLSMV推定など)でモデルを当てはめる。
5のWLSMV(平均・分散調整重み付き最小二乗法)は、順序変数のCFAで広く使われる推定法である。考え方としては、「まず閾値とポリコリック相関を推定し、次に、そのポリコリック相関行列を最もよく再現する因子モデルを探す」という2段構えになっている。Flora & Curran(2004)のシミュレーションでも、順序データのCFAで良好な性能が示されている。
なお、実際の研究では、EFAとCFAは別のサンプル(またはデータを無作為に2分割したもの)で行うのが望ましい。同じデータでEFAによって構造を探し、そのままCFAで「確認」すると、自分で作った問題を自分で解いて「正解しました」と言うようなもので、確認の意味が弱くなるからである。6章では手順を体験するために同じデータを使っている。
※コラム:IRTの段階反応モデルとの関係
前回のIRT記事で紹介した段階反応モデル(GRM)は、段階のある項目を、項目ごとの「回答確率の曲線」でモデル化する方法である。一方、ポリコリック相関にもとづく因子分析は、項目間の相関の構造をモデル化する方法である。
一見まったく別の手法に見えるが、両者は理論的にとても近い。曲線に正規分布の形(正規累積モデル)を使うGRMと、ポリコリック相関にもとづくカテゴリカルな因子分析は、パラメータを変換することで互いに対応づけられることが知られている(Takane & de Leeuw, 1987)。因子負荷量はIRTの識別力に、閾値はIRTの困難度に、それぞれ対応する。
同じ山を、北側の登山道(因子分析)から登るか、南側の登山道(IRT)から登るかの違い、と考えるとよい。Rの
psychパッケージには、ポリコリック相関にもとづく因子分析の結果をIRTのパラメータに変換して表示するirt.fa()という関数もある。
6. Rによる実装(psych / polycor / lavaan)
ここからは、Rで実際にポリコリック相関を計算し、ピアソン相関との違いを確かめる。疑似データは「真の答え」がわかるように作るので、どちらが真の値に近いかを直接比べられる。
以下の出力は、R 4.6.1、psych 2.6.9、polycor 0.8.2、lavaan 0.7.3 で実行した結果である。
Step 0:パッケージの準備と、概念図(図1・図2)の描画
# install.packages(c("psych", "polycor", "lavaan", "GPArotation"))  # 初回のみ
library(psych)    # polychoric(), fa.parallel(), fa()
library(polycor)  # polychor():1組の項目のポリコリック相関と標準誤差
library(lavaan)   # cfa():確認的因子分析
# GPArotation は fa() の斜交回転(oblimin)で使われる(library() での読み込みは不要)
# MASS は R に標準で付属している

# --- 図1:潜在変数を閾値で区切る ---
tau <- c(0.25, 1.00, 1.60)  # 閾値(重症側に寄っている=「0」が多くなる)
xx  <- seq(-3.5, 3.5, length.out = 400)
cols <- c("#cfe3f3", "#9ec5e6", "#5e9fd1", "#2b6ca8")
br <- c(-Inf, tau, Inf)

par(mfrow = c(1, 2))
plot(xx, dnorm(xx), type = "l", lwd = 2, ylim = c(0, 0.46),
     xlab = "Latent symptom severity (X*)", ylab = "Density",
     main = "Latent continuous variable")
for (k in 1:4) {
  s <- xx > br[k] & xx <= br[k + 1]
  polygon(c(xx[s][1], xx[s], tail(xx[s], 1)), c(0, dnorm(xx[s]), 0),
          col = cols[k], border = NA)
}
lines(xx, dnorm(xx), lwd = 2)
abline(v = tau, lty = 2)
text(tau, 0.44, labels = expression(tau[1], tau[2], tau[3]), pos = 4)
text(c(-1.3, 0.62, 1.3, 2.3), 0.05, labels = 0:3, font = 2)
barplot(diff(pnorm(br)), names.arg = 0:3, col = cols, ylim = c(0, 0.7),
        xlab = "Observed response", ylab = "Proportion",
        main = "Observed ordinal response")
par(mfrow = c(1, 1))

# --- 図2:2変量正規分布を閾値の格子で区切る ---
g   <- seq(-3, 3, length.out = 200)
rho <- 0.5
dens <- outer(g, g, function(x, y)
  exp(-(x^2 - 2 * rho * x * y + y^2) / (2 * (1 - rho^2))) / (2 * pi * sqrt(1 - rho^2)))
contour(g, g, dens, drawlabels = FALSE, nlevels = 8, col = "#2b6ca8", lwd = 1.5,
        xlab = "Latent variable of item A (X*)", ylab = "Latent variable of item B (Y*)",
        main = expression(paste("Bivariate normal (", rho, " = 0.5) cut by thresholds")))
abline(v = tau, h = tau, lty = 2, col = "grey30")
mid <- c(-1.4, 0.62, 1.3, 2.3)
for (i in 1:4) for (j in 1:4) {
  rect(mid[i] - 0.25, mid[j] - 0.11, mid[i] + 0.25, mid[j] + 0.11, col = "white", border = NA)
  text(mid[i], mid[j], paste0("(", i - 1, ",", j - 1, ")"), cex = 0.7, col = "grey20")
}
abline(v = tau, h = tau, lty = 2, col = "grey30")
図2のマス目の (i, j) は、「項目Aで i、項目Bで j と答える」組み合わせを表す。楕円の山の大部分が左下のマス目 (0, 0) に入っていることから、「どちらの項目でも0と答える人」が最も多くなることがわかる。
Step 1:疑似データの生成
「気分の症状(Mood)」と「身体の症状(Somatic)」の2つの潜在因子(因子間相関0.5)から、8項目の潜在得点(連続量)を作る。それを図1と同じ閾値で区切って、0〜3点の回答にする。
set.seed(2026)
N <- 500

# 真の因子構造
Phi <- matrix(c(1, 0.5, 0.5, 1), 2)       # 因子間相関 0.5
L <- matrix(0, 8, 2)
L[1:4, 1] <- c(0.80, 0.75, 0.70, 0.65)    # Q1〜Q4:気分の症状(Mood)
L[5:8, 2] <- c(0.80, 0.70, 0.65, 0.60)    # Q5〜Q8:身体の症状(Somatic)

# 潜在得点(連続量)を作る:因子 × 負荷量 + 独自の誤差
F <- MASS::mvrnorm(N, mu = c(0, 0), Sigma = Phi)
E <- matrix(rnorm(N * 8), N, 8) %*% diag(sqrt(1 - rowSums((L %*% Phi) * L)))
Ystar <- F %*% t(L) + E

# 閾値で区切って 0〜3 点の回答にする(式①)
tau <- c(0.25, 1.00, 1.60)
dat <- as.data.frame(apply(Ystar, 2, function(y) findInterval(y, tau)))
names(dat) <- paste0("Q", 1:8)

# 潜在得点どうしの「真の相関行列」
true_R <- L %*% Phi %*% t(L)
diag(true_R) <- 1

# 各項目の回答の割合
round(sapply(dat, function(x) prop.table(table(factor(x, 0:3)))), 2)
Q1 Q2 Q3 Q4 Q5 Q6 Q7 Q8
0 0.60 0.57 0.57 0.59 0.61 0.57 0.58 0.62
1 0.23 0.28 0.25 0.25 0.23 0.25 0.25 0.23
2 0.10 0.09 0.12 0.10 0.11 0.13 0.13 0.08
3 0.07 0.06 0.05 0.05 0.05 0.05 0.04 0.06どの項目でも6割前後が「0」と答えており、冒頭の若手医師のデータと同じように、回答が「0」に偏った状況が再現できている。
真の相関行列 true_R は、潜在得点どうしの相関の理論値である。たとえば、Q1とQ2の真の相関は 0.80 × 0.75 = 0.60、Q1とQ5(因子が違う項目)の真の相関は 0.80 × 0.5 × 0.80 = 0.32 になる。
> print(true_R)
     [,1]    [,2]   [,3]    [,4] [,5]   [,6]    [,7]  [,8]
[1,] 1.00 0.60000 0.5600 0.52000 0.32 0.2800 0.26000 0.240
[2,] 0.60 1.00000 0.5250 0.48750 0.30 0.2625 0.24375 0.225
[3,] 0.56 0.52500 1.0000 0.45500 0.28 0.2450 0.22750 0.210
[4,] 0.52 0.48750 0.4550 1.00000 0.26 0.2275 0.21125 0.195
[5,] 0.32 0.30000 0.2800 0.26000 1.00 0.5600 0.52000 0.480
[6,] 0.28 0.26250 0.2450 0.22750 0.56 1.0000 0.45500 0.420
[7,] 0.26 0.24375 0.2275 0.21125 0.52 0.4550 1.00000 0.390
[8,] 0.24 0.22500 0.2100 0.19500 0.48 0.4200 0.39000 1.000
Step 2:ピアソン相関とポリコリック相関を比べる
r_pear <- cor(dat)            # ピアソン相関(0〜3点を連続量として扱う)
pc     <- polychoric(dat)     # ポリコリック相関
r_poly <- pc$rho              # 相関行列
pc$tau                        # 推定された閾値

# 対角を除いた相関の平均を、真の値と比べる
low <- lower.tri(true_R)
round(c(true       = mean(true_R[low]),
        pearson    = mean(r_pear[low]),
        polychoric = mean(r_poly[low])), 3)

# 真の値に対する比の平均
round(c(pearson    = mean(r_pear[low] / true_R[low]),
        polychoric = mean(r_poly[low] / true_R[low])), 3)
true pearson polychoric
0.356 0.272 0.346
pearson polychoric
0.731 0.944 項目間の相関(28組)の平均は、真の値が0.356だったのに対し、ピアソン相関は0.272、ポリコリック相関は0.346だった。真の値に対する比で見ると、ピアソン相関は平均して真の値の約73%にとどまっており、3章で見た「減衰」がここでも起きている。ポリコリック相関は約94%で、真の値に近い。
推定された閾値(pc$tau)は、項目ごとに 0.17〜0.31、0.92〜1.06、1.48〜1.73 の範囲で、データを作るときに使った真の閾値(0.25、1.00、1.60)の近くに戻ってきていた。
Step 3:1組の項目で詳しく見る
Q1とQ2の組を取り出して、クロス表とポリコリック相関を詳しく見てみよう。
# クロス表
table(Q1 = dat$Q1, Q2 = dat$Q2)

# ポリコリック相関(2段階推定)と標準誤差
polychor(dat$Q1, dat$Q2, std.err = TRUE)

# 参考:真の値、ピアソン相関、スピアマン相関
true_R[1, 2]
cor(dat$Q1, dat$Q2)
cor(dat$Q1, dat$Q2, method = "spearman")
Q2
Q1 0 1 2 3
0 225 68 6 3
1 46 42 19 6
2 9 20 15 6
3 4 11 7 13
Polychoric Correlation, 2-step est. = 0.6629 (0.03425)
Test of bivariate normality: Chisquare = 6.895, df = 8, p = 0.548クロス表を見ると、500人中225人が「どちらも0」に集中している。図2の楕円の山の大部分が左下のマス目に入っていたのと、同じ姿である。
この組では、真の相関0.60に対して、ピアソン相関は0.557、スピアマン相関は0.525、ポリコリック相関は0.663(標準誤差0.034)だった。ポリコリック相関は、この組ではむしろ真の値より大きく出ている。これは推定のばらつき(標準誤差)の範囲で起こりうるずれで、ポリコリック相関が「1組ごとに必ず真の値に近い」わけではないことを示している。Step 2で見たように、平均して真の値に近づく、という性質のものである。
出力の2行目(Test of bivariate normality)は、4-2節で触れた2変量正規性の検定である。この組では P = 0.548 で、2変量正規性の仮定と明らかに矛盾する証拠は見られなかった。ただし、これは「仮定が正しいと証明された」という意味ではない。
Step 4:平行分析で因子数の目安を得る
# ピアソン相関にもとづく平行分析
fa.parallel(dat, cor = "cor", fa = "fa", main = "Parallel analysis (Pearson)")

# ポリコリック相関にもとづく平行分析
fa.parallel(dat, cor = "poly", fa = "fa", main = "Parallel analysis (Polychoric)")
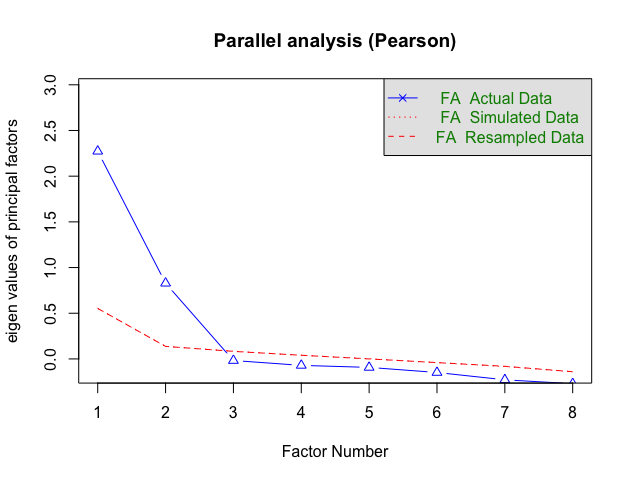
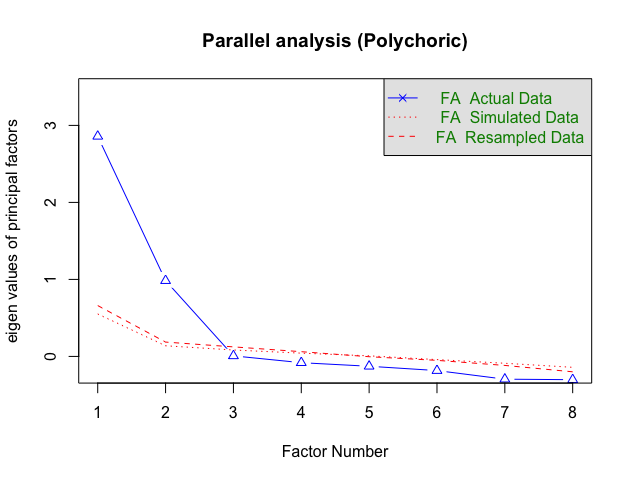
Parallel analysis suggests that the number of factors = 2 and the number of components = NA
Parallel analysis suggests that the number of factors = 2 and the number of components = NA今回の疑似データでは、どちらの相関行列を使っても、平行分析は真の因子数と同じ「2因子」を示した。2つの因子がはっきり分かれるように作ったデータなので、因子数の判断にまでは減衰の影響が出なかったと考えられる。実データでは、因子どうしの区別がもっと微妙なことも多く、結果が食い違うこともある。
Step 5:探索的因子分析(EFA)を比べる
efa_p <- fa(dat, nfactors = 2, cor = "cor",  rotate = "oblimin", fm = "minres")  # ピアソン
efa_c <- fa(dat, nfactors = 2, cor = "poly", rotate = "oblimin", fm = "minres")  # ポリコリック

print(efa_c$loadings, cutoff = 0)   # ポリコリックの負荷量
round(efa_c$Phi, 2)                 # 因子間相関

# 各項目の主な負荷量を、真の値と並べる
mainload <- function(f) apply(abs(unclass(f$loadings)), 1, max)
round(cbind(true       = rowSums(L),
            pearson    = mainload(efa_p),
            polychoric = mainload(efa_c)), 2)
true pearson polychoric
Q1 0.80 0.77 0.85
Q2 0.75 0.73 0.78
Q3 0.70 0.67 0.75
Q4 0.65 0.56 0.62
Q5 0.80 0.68 0.74
Q6 0.70 0.67 0.76
Q7 0.65 0.55 0.60
Q8 0.60 0.51 0.60どちらの方法でも、Q1〜Q4が1つの因子に、Q5〜Q8がもう1つの因子にまとまり、因子の「形」は正しく再現された(もう一方の因子への負荷量は、どちらの方法でもすべて絶対値0.11未満だった)。
違いが出たのは、負荷量の大きさである。8項目の主な負荷量の平均は、真の値0.71に対して、ピアソン相関では0.64、ポリコリック相関では0.71だった。ピアソン相関では8項目すべてで真の値より小さく、Q5(0.80 → 0.68)やQ8(0.60 → 0.51)のように、0.1前後小さくなる項目もある。冒頭の若手医師が感じた「負荷量が思ったより低い」の正体は、これである。
ポリコリック相関では、平均は真の値に近いものの、Q1(0.85)やQ6(0.76)のように真の値より大きく出た項目もある。これも推定のばらつきによるもので、ポリコリック相関を使えば個々の値が必ず正確になる、というわけではない。
なお、因子間相関(真の値0.5)は、ピアソン相関で0.39、ポリコリック相関で0.41と、どちらも小さめだった。これは疑似データ1回分の結果であり、推定のばらつきを含む点に注意してほしい。
Step 6:確認的因子分析(CFA)を比べる
最後に、lavaan で2因子モデルのCFAを行う。0〜3点を連続量として扱う方法(ロバスト最尤法、MLR)と、順序変数として扱う方法(WLSMV)を比べる。
model <- '
  Mood    =~ Q1 + Q2 + Q3 + Q4
  Somatic =~ Q5 + Q6 + Q7 + Q8
'

# 連続量として扱う(ロバスト最尤法)
fit_ml  <- cfa(model, data = dat, estimator = "MLR", std.lv = TRUE)

# 順序変数として扱う(ordered を指定すると、既定で WLSMV 推定になる)
fit_cat <- cfa(model, data = dat, ordered = names(dat), std.lv = TRUE)

# 適合度
fitMeasures(fit_ml,  c("chisq.scaled", "df", "pvalue.scaled",
                       "cfi.robust", "tli.robust", "rmsea.robust", "srmr"))
fitMeasures(fit_cat, c("chisq.scaled", "df", "pvalue.scaled",
                       "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr"))

# 標準化した負荷量を、真の値と並べる
sl <- function(f) {
  s <- standardizedSolution(f)
  s <- s[s$op == "=~", ]
  setNames(s$est.std, s$rhs)
}
round(cbind(true = rowSums(L), MLR = sl(fit_ml), WLSMV = sl(fit_cat)), 2)
== MLR(連続量として扱う) ==
chisq.scaled df pvalue.scaled cfi.robust tli.robust
22.759 19.000 0.248 0.995 0.993
rmsea.robust srmr
0.021 0.028
== WLSMV(順序変数として扱う) ==
chisq.scaled df pvalue.scaled cfi.scaled tli.scaled
27.049 19.000 0.104 0.994 0.991
rmsea.scaled srmr
0.029 0.038
true MLR WLSMV
Q1 0.80 0.74 0.79
Q2 0.75 0.77 0.85
Q3 0.70 0.65 0.72
Q4 0.65 0.58 0.66
Q5 0.80 0.71 0.81
Q6 0.70 0.63 0.70
Q7 0.65 0.56 0.63
Q8 0.60 0.50 0.57適合度は、どちらの方法でも良好だった(MLR:CFI 0.995、RMSEA 0.021、SRMR 0.028;WLSMV:CFI 0.994、RMSEA 0.029、SRMR 0.038)。2因子モデルが正しいデータなので、モデルの「形」はどちらの方法でもデータと矛盾しない、ということである。なお、推定法が違うと適合度指標の計算方法も違うため、MLRとWLSMVの適合度の数値を並べて「どちらが良いか」を比べることはできない。
一方、標準化した負荷量の平均は、真の値0.71に対して、MLRでは0.64、WLSMVでは0.72だった。MLRでは、Q2を除く7項目で真の値より小さく推定されている。冒頭の会話のとおり、適合度が良好でも、負荷量の大きさは小さめに推定されうるのである。WLSMVでも、Q2(0.75 → 0.85)のように真の値から0.1ずれる項目はあり、推定のばらつきは避けられない。
因子間相関(真の値0.5)は、MLRで0.41、WLSMVで0.44だった。
Step 7:図3のシミュレーション
3章の図3と表を作ったコードである。真の相関0.5の2変量正規分布から500人分のデータを作り、段階の数と偏りを変えて区切る、という作業を200回繰り返している(数十秒〜数分かかる)。
set.seed(123)
sim_one <- function(k, skew, rho = 0.5, n = 500) {
  # k 段階に区切る閾値(偏りありの場合は、全体を重症側に 1 ずらす)
  th <- qnorm((1:(k - 1)) / k) + if (skew) 1 else 0
  z <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, rho, rho, 1), 2))
  x <- findInterval(z[, 1], th)
  y <- findInterval(z[, 2], th)
  c(Pearson    = cor(x, y),
    Spearman   = cor(x, y, method = "spearman"),
    Polychoric = suppressWarnings(polychor(x, y)))
}

conds <- expand.grid(k = c(2, 3, 5, 7), skew = c(FALSE, TRUE))
res <- t(sapply(seq_len(nrow(conds)), function(i)
  rowMeans(replicate(200, sim_one(conds$k[i], conds$skew[i])))))
res <- cbind(conds, round(res, 3))
res

par(mfrow = c(1, 2))
for (sk in c(FALSE, TRUE)) {
  r <- res[res$skew == sk, ]
  matplot(r$k, r[, c("Pearson", "Spearman", "Polychoric")], type = "b",
          pch = c(16, 17, 15), lty = 1, col = c("#d1495b", "#edae49", "#00798c"),
          ylim = c(0.25, 0.55), xaxt = "n",
          xlab = "Number of categories", ylab = "Mean estimated correlation",
          main = if (sk) "Skewed responses" else "Symmetric responses")
  axis(1, at = c(2, 3, 5, 7))
  abline(h = 0.5, lty = 2)
  legend("bottomright", c("Pearson", "Spearman", "Polychoric", "True value (0.5)"),
         col = c("#d1495b", "#edae49", "#00798c", "black"),
         pch = c(16, 17, 15, NA), lty = c(1, 1, 1, 2), bty = "n")
}
par(mfrow = c(1, 1))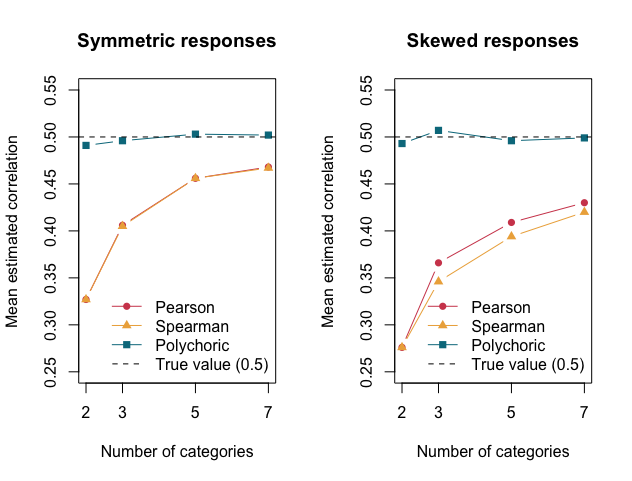
7. 論文でそのまま使える英文テンプレート
以下は記述例である。Resultsの数値は本記事の疑似データの解析結果(6章の出力)にもとづくものなので、実際の解析結果に置き換えて使ってほしい。
Methods
Because the items were rated on a 4-point ordinal scale and their response distributions were skewed, we treated the item responses as ordinal variables. Polychoric correlations were estimated, assuming that each observed item response reflects an underlying normally distributed continuous latent variable. The number of factors was determined by parallel analysis based on the polychoric correlation matrix. Exploratory factor analysis (EFA) was performed on the polychoric correlation matrix using the minimum residual method with oblimin rotation. The hypothesized two-factor structure was then examined (in practice, preferably in an independent sample or in the other half of a randomly split sample) by confirmatory factor analysis (CFA) using the mean- and variance-adjusted weighted least squares (WLSMV) estimator, with all items specified as ordered categorical variables. Model fit was evaluated using the comparative fit index (CFI), the Tucker–Lewis index (TLI), the root mean square error of approximation (RMSEA), and the standardized root mean square residual (SRMR). All analyses were conducted using the psych (version X.X.X) and lavaan (version X.X-X) packages in R (version X.X.X).
(日本語訳)各項目は4段階の順序尺度で評価され、回答分布に偏りがあったため、項目への回答を順序変数として扱った。観測された各項目の回答は、正規分布に従う連続的な潜在変数を反映していると仮定し、ポリコリック相関を推定した。因子数は、ポリコリック相関行列にもとづく平行分析により決定した。探索的因子分析(EFA)は、ポリコリック相関行列を用い、最小残差法とオブリミン回転により行った。続いて、仮説とした2因子構造を(実際には、独立したサンプル、または無作為に2分割したデータのもう一方で行うことが望ましい)、すべての項目を順序カテゴリ変数として指定したうえで、平均・分散調整重み付き最小二乗法(WLSMV)による確認的因子分析(CFA)で検討した。モデルの適合度は、比較適合度指標(CFI)、タッカー・ルイス指標(TLI)、近似誤差二乗平均平方根(RMSEA)、標準化残差平方平均平方根(SRMR)で評価した。解析にはR(バージョンX.X.X)のpsychパッケージ(バージョンX.X.X)およびlavaanパッケージ(バージョンX.X-X)を用いた。
Results
Parallel analysis based on the polychoric correlation matrix suggested a two-factor solution. In the EFA, items Q1–Q4 loaded on the first factor (mood symptoms; loadings, 0.62–0.85) and items Q5–Q8 loaded on the second factor (somatic symptoms; loadings, 0.60–0.76), with all cross-loadings below 0.11 in absolute value. The inter-factor correlation was 0.41. The CFA with the WLSMV estimator showed good fit of the two-factor model (scaled χ2 = 27.05, df = 19; CFI = 0.994; TLI = 0.991; RMSEA = 0.029; SRMR = 0.038). Standardized factor loadings ranged from 0.66 to 0.85 for the mood factor and from 0.57 to 0.81 for the somatic factor, and the correlation between the two factors was 0.44.
(日本語訳)ポリコリック相関行列にもとづく平行分析では、2因子解が示唆された。EFAでは、Q1〜Q4が第1因子(気分の症状、負荷量0.62〜0.85)に、Q5〜Q8が第2因子(身体の症状、負荷量0.60〜0.76)に負荷し、交差負荷量はすべて絶対値0.11未満であった。因子間相関は0.41であった。WLSMV推定によるCFAでは、2因子モデルの良好な適合が示された(スケール調整済み χ² = 27.05、自由度19、CFI = 0.994、TLI = 0.991、RMSEA = 0.029、SRMR = 0.038)。標準化因子負荷量は、気分の因子で0.66〜0.85、身体の因子で0.57〜0.81であり、2因子間の相関は0.44であった。
8. まとめ
- 0〜3点のような段階の回答は、裏にある連続した潜在変数を、閾値で区切った結果と考えることができる。
- ポリコリック相関は、2つの潜在変数が2変量正規分布に従うと仮定して推定した、潜在変数どうしの相関である。観測された点数どうしの相関ではない。
- 段階が少ないほど、また回答が偏るほど、ピアソン相関(スピアマン相関も)は小さく出る(減衰)。その結果、因子分析では負荷量が小さく推定されやすい。適合度が良好でも、この問題は起こりうる。
- 5段階以上で回答の偏りが小さければ、連続量として扱っても大きな問題は少ない。4段階以下や偏りが強い場合は、ポリコリック相関にもとづく方法を検討したい。
- ポリコリック相関は万能ではない。潜在変数の正規性、空セル、正定値でない相関行列、サンプルサイズに注意し、本来がカテゴリである変数には使わない。
- 順序尺度の因子分析は、ポリコリック相関行列にもとづく平行分析とEFA、そしてWLSMV推定によるCFAが標準的な流れである。
段階のある項目を、相関の構造ではなく「項目ごとの回答確率の曲線」としてモデル化したい場合は、IRTの段階反応モデルが選択肢になる。IRTの考え方は項目反応理論(IRT)の基礎で解説している。
一括コピペ用Rスクリプト
# ============================================
# ポリコリック相関:ピアソン相関との比較と、順序尺度の因子分析
# ============================================
# install.packages(c("psych", "polycor", "lavaan", "GPArotation"))  # 初回のみ
library(psych)
library(polycor)
library(lavaan)

# ---- Step 0:概念図(図1・図2) ----
tau <- c(0.25, 1.00, 1.60)
xx  <- seq(-3.5, 3.5, length.out = 400)
cols <- c("#cfe3f3", "#9ec5e6", "#5e9fd1", "#2b6ca8")
br <- c(-Inf, tau, Inf)
par(mfrow = c(1, 2))
plot(xx, dnorm(xx), type = "l", lwd = 2, ylim = c(0, 0.46),
     xlab = "Latent symptom severity (X*)", ylab = "Density",
     main = "Latent continuous variable")
for (k in 1:4) {
  s <- xx > br[k] & xx <= br[k + 1]
  polygon(c(xx[s][1], xx[s], tail(xx[s], 1)), c(0, dnorm(xx[s]), 0),
          col = cols[k], border = NA)
}
lines(xx, dnorm(xx), lwd = 2)
abline(v = tau, lty = 2)
text(tau, 0.44, labels = expression(tau[1], tau[2], tau[3]), pos = 4)
text(c(-1.3, 0.62, 1.3, 2.3), 0.05, labels = 0:3, font = 2)
barplot(diff(pnorm(br)), names.arg = 0:3, col = cols, ylim = c(0, 0.7),
        xlab = "Observed response", ylab = "Proportion",
        main = "Observed ordinal response")
par(mfrow = c(1, 1))

g   <- seq(-3, 3, length.out = 200)
rho <- 0.5
dens <- outer(g, g, function(x, y)
  exp(-(x^2 - 2 * rho * x * y + y^2) / (2 * (1 - rho^2))) / (2 * pi * sqrt(1 - rho^2)))
contour(g, g, dens, drawlabels = FALSE, nlevels = 8, col = "#2b6ca8", lwd = 1.5,
        xlab = "Latent variable of item A (X*)", ylab = "Latent variable of item B (Y*)",
        main = expression(paste("Bivariate normal (", rho, " = 0.5) cut by thresholds")))
abline(v = tau, h = tau, lty = 2, col = "grey30")
mid <- c(-1.4, 0.62, 1.3, 2.3)
for (i in 1:4) for (j in 1:4) {
  rect(mid[i] - 0.25, mid[j] - 0.11, mid[i] + 0.25, mid[j] + 0.11, col = "white", border = NA)
  text(mid[i], mid[j], paste0("(", i - 1, ",", j - 1, ")"), cex = 0.7, col = "grey20")
}
abline(v = tau, h = tau, lty = 2, col = "grey30")

# ---- Step 1:疑似データの生成 ----
set.seed(2026)
N <- 500
Phi <- matrix(c(1, 0.5, 0.5, 1), 2)
L <- matrix(0, 8, 2)
L[1:4, 1] <- c(0.80, 0.75, 0.70, 0.65)
L[5:8, 2] <- c(0.80, 0.70, 0.65, 0.60)
F <- MASS::mvrnorm(N, mu = c(0, 0), Sigma = Phi)
E <- matrix(rnorm(N * 8), N, 8) %*% diag(sqrt(1 - rowSums((L %*% Phi) * L)))
Ystar <- F %*% t(L) + E
dat <- as.data.frame(apply(Ystar, 2, function(y) findInterval(y, tau)))
names(dat) <- paste0("Q", 1:8)
true_R <- L %*% Phi %*% t(L)
diag(true_R) <- 1
round(sapply(dat, function(x) prop.table(table(factor(x, 0:3)))), 2)

# ---- Step 2:ピアソン相関 vs ポリコリック相関 ----
r_pear <- cor(dat)
pc     <- polychoric(dat)
r_poly <- pc$rho
pc$tau
low <- lower.tri(true_R)
round(c(true = mean(true_R[low]), pearson = mean(r_pear[low]),
        polychoric = mean(r_poly[low])), 3)
round(c(pearson = mean(r_pear[low] / true_R[low]),
        polychoric = mean(r_poly[low] / true_R[low])), 3)

# ---- Step 3:1組の項目で詳しく ----
table(Q1 = dat$Q1, Q2 = dat$Q2)
polychor(dat$Q1, dat$Q2, std.err = TRUE)
true_R[1, 2]
cor(dat$Q1, dat$Q2)
cor(dat$Q1, dat$Q2, method = "spearman")

# ---- Step 4:平行分析 ----
fa.parallel(dat, cor = "cor",  fa = "fa", main = "Parallel analysis (Pearson)")
fa.parallel(dat, cor = "poly", fa = "fa", main = "Parallel analysis (Polychoric)")

# ---- Step 5:探索的因子分析 ----
efa_p <- fa(dat, nfactors = 2, cor = "cor",  rotate = "oblimin", fm = "minres")
efa_c <- fa(dat, nfactors = 2, cor = "poly", rotate = "oblimin", fm = "minres")
print(efa_c$loadings, cutoff = 0)
round(efa_c$Phi, 2)
mainload <- function(f) apply(abs(unclass(f$loadings)), 1, max)
round(cbind(true = rowSums(L), pearson = mainload(efa_p),
            polychoric = mainload(efa_c)), 2)

# ---- Step 6:確認的因子分析 ----
model <- '
  Mood    =~ Q1 + Q2 + Q3 + Q4
  Somatic =~ Q5 + Q6 + Q7 + Q8
'
fit_ml  <- cfa(model, data = dat, estimator = "MLR", std.lv = TRUE)
fit_cat <- cfa(model, data = dat, ordered = names(dat), std.lv = TRUE)
fitMeasures(fit_ml,  c("chisq.scaled", "df", "pvalue.scaled",
                       "cfi.robust", "tli.robust", "rmsea.robust", "srmr"))
fitMeasures(fit_cat, c("chisq.scaled", "df", "pvalue.scaled",
                       "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr"))
sl <- function(f) {
  s <- standardizedSolution(f)
  s <- s[s$op == "=~", ]
  setNames(s$est.std, s$rhs)
}
round(cbind(true = rowSums(L), MLR = sl(fit_ml), WLSMV = sl(fit_cat)), 2)

# ---- Step 7:図3のシミュレーション ----
set.seed(123)
sim_one <- function(k, skew, rho = 0.5, n = 500) {
  th <- qnorm((1:(k - 1)) / k) + if (skew) 1 else 0
  z <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, rho, rho, 1), 2))
  x <- findInterval(z[, 1], th)
  y <- findInterval(z[, 2], th)
  c(Pearson    = cor(x, y),
    Spearman   = cor(x, y, method = "spearman"),
    Polychoric = suppressWarnings(polychor(x, y)))
}
conds <- expand.grid(k = c(2, 3, 5, 7), skew = c(FALSE, TRUE))
res <- t(sapply(seq_len(nrow(conds)), function(i)
  rowMeans(replicate(200, sim_one(conds$k[i], conds$skew[i])))))
res <- cbind(conds, round(res, 3))
res
par(mfrow = c(1, 2))
for (sk in c(FALSE, TRUE)) {
  r <- res[res$skew == sk, ]
  matplot(r$k, r[, c("Pearson", "Spearman", "Polychoric")], type = "b",
          pch = c(16, 17, 15), lty = 1, col = c("#d1495b", "#edae49", "#00798c"),
          ylim = c(0.25, 0.55), xaxt = "n",
          xlab = "Number of categories", ylab = "Mean estimated correlation",
          main = if (sk) "Skewed responses" else "Symmetric responses")
  axis(1, at = c(2, 3, 5, 7))
  abline(h = 0.5, lty = 2)
  legend("bottomright", c("Pearson", "Spearman", "Polychoric", "True value (0.5)"),
         col = c("#d1495b", "#edae49", "#00798c", "black"),
         pch = c(16, 17, 15, NA), lty = c(1, 1, 1, 2), bty = "n")
}
par(mfrow = c(1, 1))
参考文献
- Olsson U. Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika. 1979;44(4):443–460. doi:10.1007/BF02296207
- Flora DB, Curran PJ. An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods. 2004;9(4):466–491. doi:10.1037/1082-989X.9.4.466
- Holgado-Tello FP, Chacón-Moscoso S, Barbero-García I, Vila-Abad E. Polychoric versus Pearson correlations in exploratory and confirmatory factor analysis of ordinal variables. Quality & Quantity. 2010;44(1):153–166. doi:10.1007/s11135-008-9190-y
- Kiwanuka F, Kopra J, Sak-Dankosky N, Nanyonga RC, Kvist T. Polychoric correlation with ordinal data in nursing research. Nursing Research. 2022;71(6):469–476. doi:10.1097/NNR.0000000000000614
- Rhemtulla M, Brosseau-Liard PÉ, Savalei V. When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods. 2012;17(3):354–373. doi:10.1037/a0029315
- Norman G. Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education. 2010;15(5):625–632. doi:10.1007/s10459-010-9222-y
- Zumbo BD, Gadermann AM, Zeisser C. Ordinal versions of coefficients alpha and theta for Likert rating scales. Journal of Modern Applied Statistical Methods. 2007;6(1):21–29. doi:10.22237/jmasm/1177992180
- Chalmers RP. On misconceptions and the limited usefulness of ordinal alpha. Educational and Psychological Measurement. 2018;78(6):1056–1071.
- Zumbo BD, Kroc E. A measurement is a choice and Stevens’ scales of measurement do not help make it: a response to Chalmers. Educational and Psychological Measurement. 2019. doi:10.1177/0013164419844305
- Takane Y, de Leeuw J. On the relationship between item response theory and factor analysis of discretized variables. Psychometrika. 1987;52(3):393–408. doi:10.1007/BF02294363
- Pearson K. Mathematical contributions to the theory of evolution. VII. On the correlation of characters not quantitatively measurable. Philosophical Transactions of the Royal Society of London, Series A. 1900;195:1–47. doi:10.1098/rsta.1900.0022
- Likert R. A technique for the measurement of attitudes. Archives of Psychology. 1932;22(140):1–55.
- Ferguson LW. A study of the Likert technique of attitude scale construction. Journal of Social Psychology. 1941;13(1):51–57. doi:10.1080/00224545.1941.9714060
- 小杉考司「身長と体重を心理尺度で測る」金子書房note(連載「心理統計を探検する」), 2023. https://www.note.kanekoshobo.co.jp/n/n8d2d89f1984e
おすすめ書籍
- 豊田秀樹 編『因子分析入門:Rで学ぶ最新データ解析』東京図書(2012)
https://link.amazon/B0dA6WUqV- Rで因子分析を本格的に学べる定番の一冊。探索的因子分析から確認的因子分析まで、本記事の次に読む本としておすすめである。
- 松尾太加志『数式がなくてもわかる! Rでできる因子分析』北大路書房
https://link.amazon/B08IrtEXQ- 数式を使わずに、Rでの因子分析の手順と考え方を学べる入門書。
- 松尾太加志・中村知靖『誰も教えてくれなかった因子分析:数式が絶対に出てこない因子分析入門』北大路書房(2002)
https://link.amazon/B0f5jJTHd- 因子分析そのものに不安がある読者は、まずこちらから読むとよい。



コメント