Dunn検定と言えば、順位和を使った検定が有名である。
これはSPSSでクラスカルウォリス検定をしたあとのPost-hoc検定として有名。
どんな検定なのか?
Dunn検定の明確化
Olive Jean Dunn先生は、1961年と1964年に二つのDunn検定を発表している。
1961年のDunn検定は、平均値の多重比較方法の論文である。
https://sci2s.ugr.es/keel/pdf/algorithm/articulo/1961-Bonferroni_Dunn-JASA.pdf
この記事では、この平均値の多重比較法は、対象外である。
1964年のDunn検定は、順位和を使った多重比較法の論文である。
https://www.stat.cmu.edu/technometrics/59-69/VOL-06-03/v0603241.pdf
この記事ではこちらの順位和を使った多重比較法を紹介する。
Dunn検定とはどんな検定か?
まず、全群通じて、最小値から最大値まで、それぞれの値に順位をつける。
同じ値(同順位になる値。タイ)があった場合は、平均同順位をつける。
各群の順位の合計を T とする。
ここで、研究者が比較したいペア数を p とする。
Dunn検定は、各群を総当たりで比較することはもちろんのこと、複数群を一緒にした区切り、例えば、1群と2群の合計 vs 3群などの比較もできる。
こういう比較ペアも含めた、研究者が注目している比較ペア数が $ p $ となる。
最初の計算は、ペア間の差である。
\begin{equation}
y = \frac{\sum T_i}{\sum n_i} – \frac{\sum T_{i’}}{\sum n_{i’}}
\end{equation}
y がペア間の差で、比較したいペアの数 p 個計算される。
i, i’ は、比較群グループを表している。
1群と3群を比較する場合は、i = 1, i’ = 3 である。
1群+2群 vs 3群ならば、i = 1,2, i’ = 3 である。
1群+2群 vs 3群の場合は、$ y = \frac{T_1 + T_2}{n_1 + n_2} – \frac{T_3}{n_3} $ と計算される。
この差を標準誤差(原著では標準偏差とあるがサンプルサイズで割っているので標準誤差と解釈できる)s で割る。
\begin{equation}
s = \sqrt {\frac{N(N+1)}{12} \left( \frac{1}{\sum n_i} + \frac{1}{\sum n_{i’}} \right)}
\end{equation}
ここで、N は全群合わせたサンプルサイズ、$ n_i $, $ n_{i’} $ は比較群(複数群含む)それぞれの合計サンプルサイズである。
タイがある場合は、以下のように調整した s を用いる。
\begin{equation}
s = \sqrt { \left( \frac{N(N+1)}{12} – \frac{\sum (t^3-t)}{12(N-1)} \right) \left( \frac{1}{\sum n_i} + \frac{1}{\sum n_{i’}} \right)}
\end{equation}
ここで、t は、タイ順位別のタイの個数である。
最後に比較群ペアの y と s の比 y/s を計算すると、標準正規分布に従う検定統計量 z となる。
有意水準を $ \alpha $ とすると、有意水準を $ \alpha/p $ として小さくして検定する。
この点が Bonferroni 調整と同じである。
例えば両側5%で、3ペアの比較を行うとすると、$ 0.05 / 3 \fallingdotseq 0.0167 $ である。
さらに両側検定である場合は、この半分の確率が上側(又は下側)確率になるz値(の絶対値) $ z_{1-0.0167/2} \fallingdotseq 2.39 $ と y/s (の絶対値)を比較することになる。
統計ソフトウェアによっては、調整済みの p 値が表示される場合があり、その場合は元の有意水準5%と比較すればよくなっているので、出力結果が調整済みなのかどうかを確認する必要がある。
Dunn検定の各群のサンプルサイズが異なっても問題ないか?
原著論文を眺めた限り、問題との記載は見つからなかった。
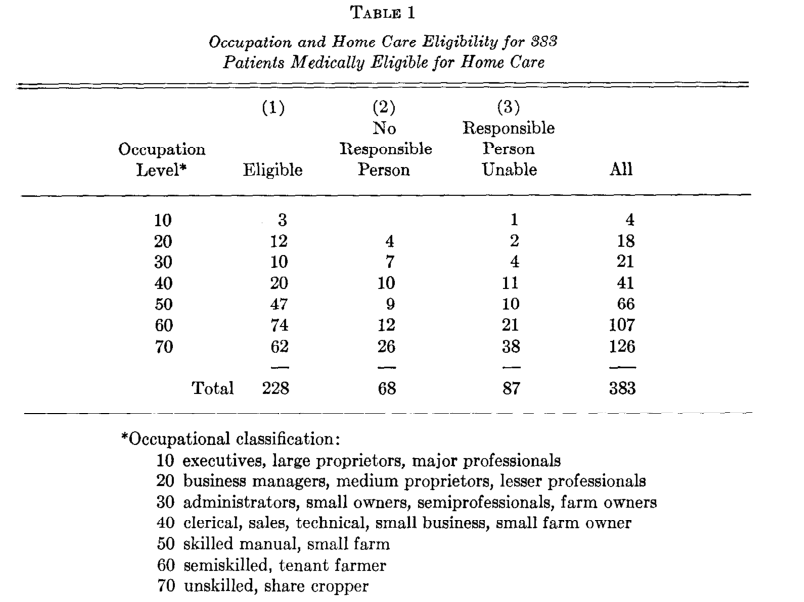
原著論文では、以下の例をもとに数値計算例を挙げているが、各群のサンプルサイズは、228例、68例、87例である。
かなり群ごとにサンプルサイズが異なる例を用いて計算している。
原著論文でこのような例を挙げていることを考慮すると、群ごとのサンプルサイズの違いは気にしなくてよいと考えられる。
Dunn検定においてタイデータはどのくらい支障をきたすか?
タイデータが存在すると問題になるかという点についても、上記の例を見て判断できる。
上記の例は、10カテゴリに分かれる職業レベル(1964年当時の考え方であろう)という順序カテゴリカルデータを3群で比較するというデータである。
同じレベルに該当する人数が4例から126例とある(Allの列参照)。
つまり、同じレベルに含まれる人数分だけタイデータが存在するということである。
論文の例では、タイデータがあるときの補正式を用いて計算しているのみで、それは問題にしていない。
上記に示した、タイデータを補正した s の式を見れば、タイデータが多くなると、$ \sum (t^3 – t) $ の部分が大きくなり、s は小さくなる計算式になっている。
つまり、検定統計量 z = y/s の分母が小さくなるわけなので、z 自体は大きくなる。
よって、より統計学的有意を検出しやすくなるわけで、少なくともタイデータが統計学的有意の検出力を下げる方向には影響しないと言える。
まとめ
順位を用いた多重比較検定のDunn検定の原著を確認してstep by stepで見てみた。
各群のサンプルサイズの偏りやタイデータの多少によって検定自体に支障をきたす根拠は見つからなかった。
あまりいろいろと気にせず適用してよいものと思われる。
参考文献
Olive Jean Dunn. Multiple Comparisons Using Rank Sums.
すべてのペア 併合順位のDunn検定、コントロール群との比較 併合順位のDunn検定 | JMP Help

コメント