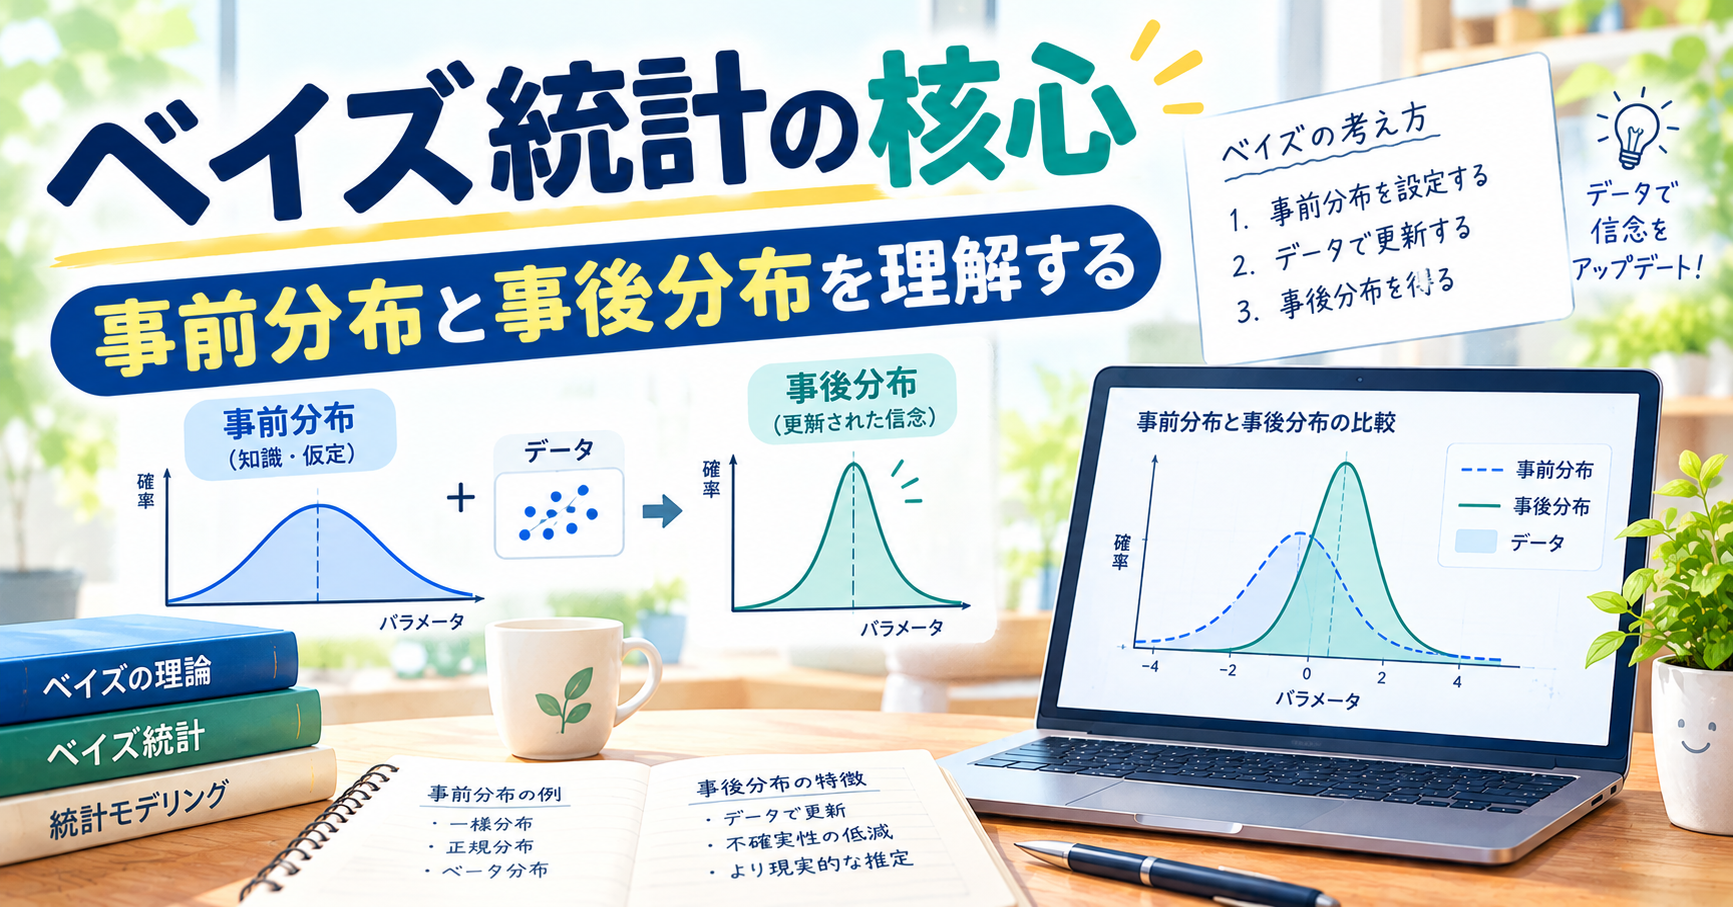
「データから何かを学ぶ」とき、私たちは常に何らかの「信念」を持っている。ベイズ統計学は、この「信念」をデータに基づいて更新していくという、非常に人間らしい思考プロセスを数学的に表現したものだ。今回は、その中心となる「事前分布」と「事後分布」について、分かりやすい比喩を交えながら解説していく。
ベイズ統計の概略
まず、ベイズ統計学がどのようなものか、簡単に見ていこう。頻度論統計学(いわゆる統計学)は、知りたい値(たとえば薬が効く割合)を「未知だが一つに決まった値」とみなし、「同じ手順を何度も繰り返したら、どれくらいの頻度で誤るか」という問いを立てる。P値や信頼区間は、この問いへの答えである。ベイズ統計学は、「今のデータと事前の知識のもとで、どの値がどれくらいありそうか」という問いを立て、事前知識をデータで更新していく。どちらが優れているかではなく、問いの立て方が違う。
事前分布と事後分布の概略
ベイズ統計学を理解する上で、最も重要な概念が「事前分布」と「事後分布」だ。
- 事前分布(Prior Distribution): データを見る「前」に、私たちが持っている「世界のあり方」に対する信念や知識を表す。これは、過去の経験、専門家の意見、あるいは単なる直感などに基づいているかもしれない。
- 事後分布(Posterior Distribution): データを「見た後」に、そのデータによって更新された「世界のあり方」に対する信念や知識を表す。事前分布にデータからの情報が加わることで、より洗練された、確信度の高い分布になる。
事前分布と事後分布のイメージ
事前分布:宝探し前の「漠然とした期待」
あなたは宝探しに出かける。まだ宝の地図を見ていない段階で、「この島には宝があるらしい」という漠然とした情報や期待を持っているとしよう。もしかしたら、「この島のどこかに隠されているだろう」という漠然とした考えかもしれないし、「昔の噂では、この洞窟の奥にある可能性が高い」という具体的な推測かもしれない。これが事前分布だ。データ(宝の地図や目撃情報)を得る前に、宝の場所(知りたい真実)に対して持っている、あなたの最初の「当たり」のことだ。
事後分布:地図を手に入れて絞り込まれた「期待」
いよいよ宝の地図を手に入れた!そこには「古い大木の根元」というヒントが書かれている。宝の場所についての見当は、地図を手に入れる前よりずっと絞り込まれる。この「絞り込まれた見当」が事後分布だ。ただし、地図の情報が少なければ、見当はまだ広い範囲に散らばっている。事後分布は「答え」そのものではなく、今ある情報のもとでの確信の度合いを表す地図である。データ(宝の地図)によって、あなたの宝の場所に対する「信念」が更新され、より具体的な場所を指し示すようになった状態だ。
つまり、ベイズ統計学では、「漠然とした期待(事前分布)」に「具体的な情報(データ)」が加わることで、「確信(事後分布)」へと変化していくプロセスを数学的に記述しているのだ。
具体例と簡単な R での可視化
例:新しい薬の効果
ある新しい薬の効果について考えてみよう。あなたは薬学の専門家として、これまでの経験から「この種類の薬は、だいたい30%から70%くらいの患者に効果があることが多い(平均 0.5 で幅がある)」という事前知識を持っていたとしよう。この見立てを、ベータ分布 Beta(5, 5) で表す。Beta(5, 5) は平均0.5で、全体の約8割が0.3〜0.7の範囲に入る(95%の範囲は約0.21〜0.79)。これは、薬の有効性に対するあなたの事前分布だ。
ここで、実際にこの新しい薬を10人の患者に投与し、8人に効果があったというデータが得られた。
このデータとあなたの事前知識を組み合わせることで、薬の本当の有効性がどのくらいなのか、より正確な情報を得ることができる。
R での簡単な可視化
ここでは、架空のデータを用いて、事前分布と事後分布がどのように変化するかをRでシミュレーションし、可視化してみよう。
R スクリプト例:
# 必要なライブラリをロード (インストールされていない場合は install.packages("ggplot2") でインストール)
library(ggplot2)

# パラメータ設定
# 事前分布のパラメータ (ベータ分布を使用)
# 例えば、事前知識として「効果がある確率は中央値が0.5くらい、幅がそこそこある」と設定
alpha_prior <- 5
beta_prior <- 5

# データの観測 (10人中8人に効果があった)
successes <- 8
trials <- 10

# 事後分布のパラメータ
alpha_posterior <- alpha_prior + successes
beta_posterior <- beta_prior + (trials - successes)

# 確率の範囲
p <- seq(0, 1, length.out = 500)

# 事前分布の確率密度
prior_density <- dbeta(p, alpha_prior, beta_prior)

# 事後分布の確率密度
posterior_density <- dbeta(p, alpha_posterior, beta_posterior)

# データフレームの作成
df <- data.frame(
    p = rep(p, 2),
    density = c(prior_density, posterior_density),
    type = c(rep("事前分布", length(p)), rep("事後分布", length(p)))
)

# 可視化
ggplot(df, aes(x = p, y = density, color = type)) +
    geom_line(linewidth = 1.2) +
    labs(
        title = "事前分布と事後分布の比較",
        x = "薬の効果がある確率",
        y = "確率密度",
        color = "分布の種類"
    ) +
    theme_minimal() +
    scale_color_manual(values = c("事前分布" = "blue", "事後分布" = "red")) +
    geom_vline(xintercept = successes / trials, linetype = "dashed", color = "gray", linewidth = 0.8) +
    annotate("text",
        x = successes / trials + 0.05, y = max(posterior_density) * 0.8,
        label = paste0("観測データ\n(", successes, "/", trials, ")"), color = "gray", hjust = 0
    )
ggsave("Bayes_prior_posterior_distribution.png", width = 8, height = 6)
実行結果:
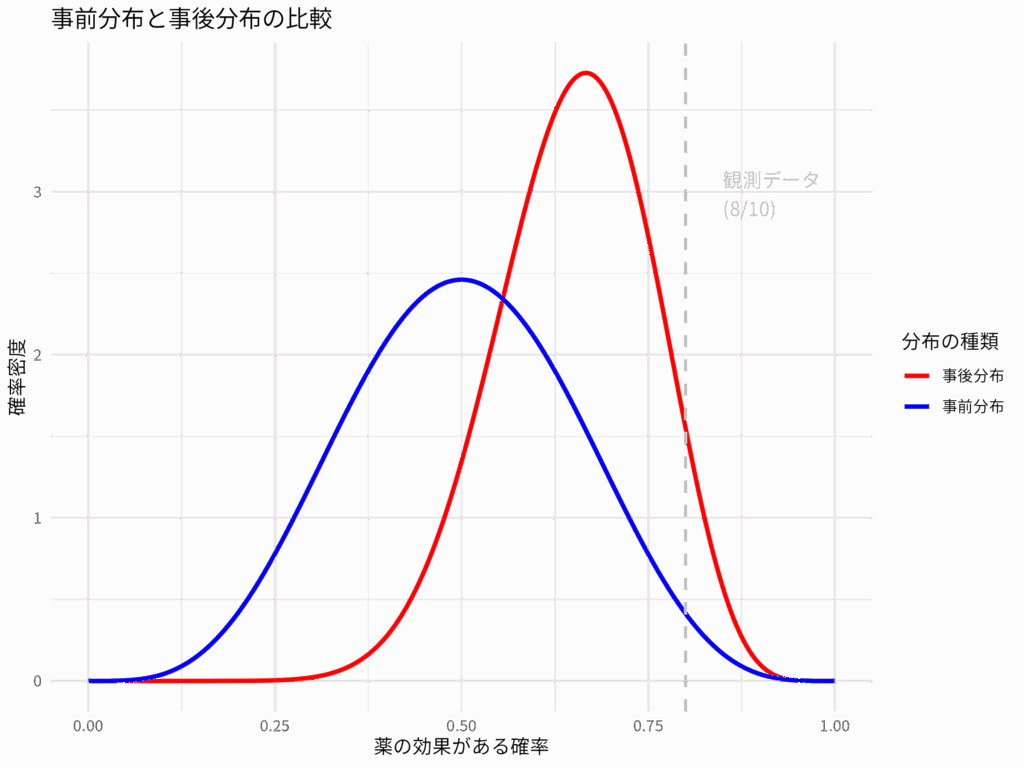
このグラフを見ると、青い線で示された事前分布は比較的幅広い範囲に広がっており、薬の効果に対するあなたの初期の不確実性を表している。しかし、赤い線で示された事後分布は、観測データ(10人中8人成功)の近くにピークが移動し、よりシャープになっていることがわかる。これは、データによって薬の効果に対するあなたの信念が更新され、より確信度が高まったことを示している。
数値でも確認しておこう。事後分布は Beta(13, 7) で、事後平均は0.65、95%信用区間は約0.43〜0.84である(Rなら qbeta(c(0.025, 0.975), 13, 7))。また、「効果がある確率が50%を超える」確率は約92%である(1 - pbeta(0.5, 13, 7))。
観測データの割合は8 ÷ 10 = 0.8なのに、事後平均は0.65にとどまっている。事前分布の平均0.5のほうへ引き戻されているのである。これは、事前分布 Beta(5, 5) が、「10人を診て5人に効いた」程度の重みを持っているためで(5 + 5 = 10)、今回の10人のデータとほぼ同じ重さで混ざっている。
事前分布の置き方によって変わる事後分布(感度分析)
実は、事前分布の置き方によって、事後分布は変わる。この例で、事前分布だけを変えて比べてみよう(データはどれも10人中8人)。
| 事前分布 | 事後分布 | 事後平均 | 95%信用区間 |
|---|---|---|---|
| Beta(5, 5)(本文の設定) | Beta(13, 7) | 0.65 | 0.43〜0.84 |
| Beta(1, 1)(一様、ほぼ情報なし) | Beta(9, 3) | 0.75 | 0.48〜0.94 |
| Beta(15, 15)(30人分の強い見立て) | Beta(23, 17) | 0.58 | 0.42〜0.72 |
事前分布の置き方で、事後平均は0.58〜0.75まで動く。逆に、データが増えると、事前分布の影響は小さくなる。たとえば、同じ Beta(5, 5) から出発しても、100人中80人に効果があったなら、事後平均は約0.77(95%信用区間 約0.69〜0.85)となり、データの割合0.8に近づく。
事後分布から、「全体の95%が集まっている範囲」を切り取ったものを95%信用区間という。今のデータと事前分布のもとで、知りたい値がこの範囲にある確率が95%、と読める区間である。頻度論の95%信頼区間と数値が似ることもあるが、意味は別物である。
このように、事前分布を変えて結果がどれだけ動くかを調べることを感度分析という。ベイズ解析の結果を読むときは、事前分布が何で、変えても結論が保たれるかを確認したい。
まとめ
ベイズ統計学における事前分布と事後分布は、「データを見る前の知識」と「データを見た後の知識」をそれぞれ表し、データによって知識が更新されていくプロセスを明確に示している。宝探しの比喩のように、漠然とした期待が具体的な情報によって確信に変わるように、ベイズ統計学は私たちの「信念」がデータによって洗練されていく過程を理解するための強力な枠組みを提供してくれる。
あなたも、日々の生活の中で「これまでの経験」と「新しい情報」がどのようにあなたの判断を形成しているか、ベイズ統計の視点から考えてみてはどうだろうか?

コメント