「先生!心不全患者のフェノタイプ(表現型)を見つけたくて、年齢・BMI・BNP値(量的変数)と性別・NYHA心機能分類(質的変数)を全部ダミー変数に変換してからPCAにかけ、その主成分でk-means法クラスタリングをやってみたのですが、クラスタリングの結果が実行するたびに大きく変わってしまいます。何が悪いのでしょうか?」
混合型データ(量的変数と質的変数が同居するデータ)を用いて患者の表現型を同定したいという需要は、臨床研究において非常に高い。
しかし、カテゴリ変数を安易に0/1のダミー変数に変換し、量的変数とそのまま並べて通常のPCAやユークリッド距離ベースのk-means法にかけてしまうと、解析結果が不安定になったり、特定の変数だけが結果を支配してしまったりする問題が頻発する。
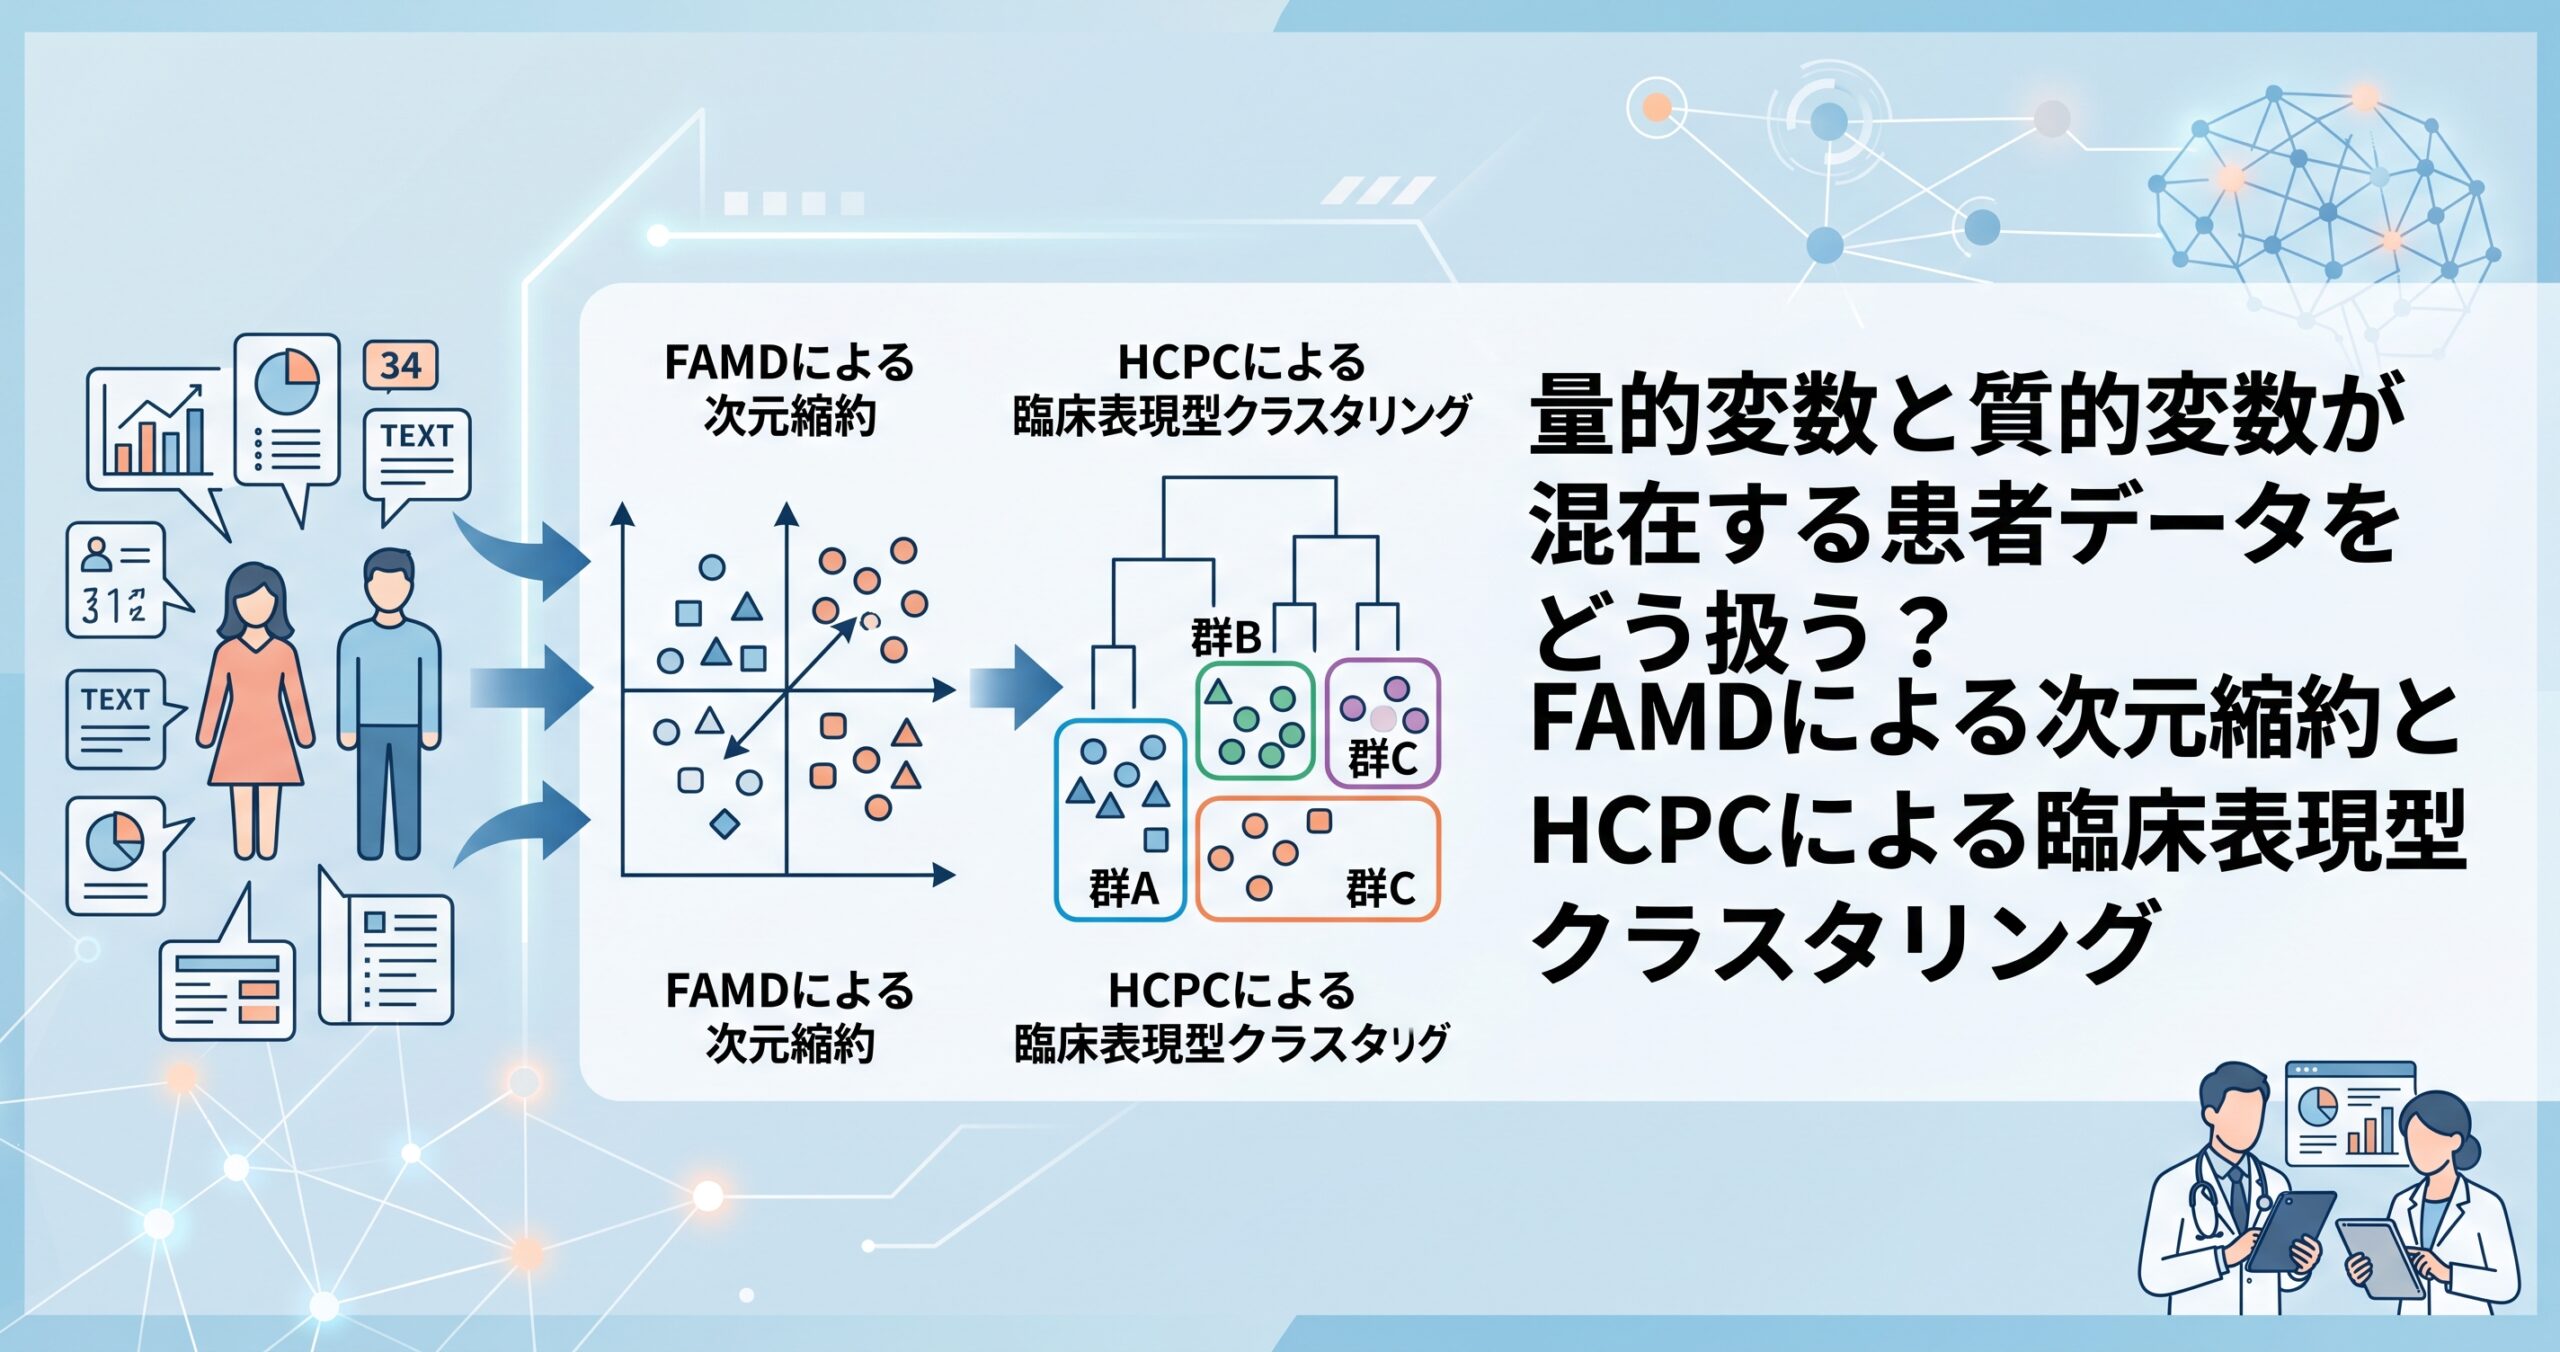
正攻法は、量的変数と質的変数のスケールを最初から対等に扱うよう設計された「FAMD(Factor Analysis of Mixed Data:混合データ因子分析)」によって次元を縮約し、その主成分に対して階層的クラスタリング(HCPC)をかけることである。
本記事では、ダミー変数化の落とし穴からFAMDの理論的背景、Rでの具体的な実装手順、そして論文でそのまま使える英文テンプレートまでを徹底解説する。
1. なぜ「ダミー化してからPCA・k-means」ではいけないのか?
臨床現場の罠
年齢・体重・検査値などの量的変数と、性別・重症度分類・合併症の有無などの質的変数が混在する患者データセットは、臨床研究において当たり前に存在する。
このようなデータから「似た患者群(フェノタイプ)」を見つけ出したいとき、最も安易な発想は、質的変数をすべて0/1のダミー変数に変換し、量的変数とまとめて通常のPCA(主成分分析)やユークリッド距離に基づくk-means法にかけることである。
しかし、この方法には2つの大きな落とし穴がある。
- スケールの不整合:量的変数はもともと連続的な数値であり分散も大きいのに対し、ダミー変数は0か1しか取らない。両者を単純に混在させると、変数ごとの「声の大きさ」が不揃いなまま距離計算が行われてしまう。
- カテゴリ数の多い変数による支配:例えば4段階のNYHA心機能分類(I〜IV)を4個のダミー変数に展開すると、性別(2値・1個のダミー変数)に比べて実質的な影響力が数倍に膨れ上がってしまう。
比喩的に言えば、これは「英語話者と手話話者を同じ会議に呼んだのに、共通の通訳を用意しないまま多数決を取る」ようなものである。声の大きさ(変数の分散や次元数)が発言力に直結してしまい、本来対等であるべき情報の重みが歪んでしまう。
※コラム:Gower距離という代替案について
混合データのクラスタリングでは、Gower距離という「変数の型ごとに異なる類似度計算を行い、それらを合成する」距離指標もよく使われる。ただし、カテゴリ変数がクラスタリングにあまり寄与しないデータでは性能が不安定になることが報告されており、距離指標の選択自体が結果を大きく左右する点には注意が必要である。
2. FAMD(Factor Analysis of Mixed Data)の直感的理解
FAMDとは何か
FAMDは、量的変数に対してはPCAのように、質的変数に対してはMCA(多重対応分析)のように働く、いわば「PCAとMCAの橋渡し役」を担う主成分分析手法である。
具体的には、量的変数は分散1になるよう標準化され、質的変数はダミー変数(指示行列)に変換されたうえでMCA特有のスケーリングが施される。これにより、量的変数と質的変数のどちらか一方が軸の決定を独占することなく、対等な立場でデータの変動方向(主成分)が決められる。
面白いことに、この手法は次の2つの特殊ケースを内包している。
- 全変数が量的変数であれば、FAMDは通常のPCAと一致する。
- 全変数が質的変数であれば、FAMDはMCAと一致する。
つまりFAMDは、「量的変数の世界」と「質的変数の世界」を結ぶ共通言語のような役割を果たしていると考えるとわかりやすい。
数式で見る標準化の考え方
個体数を $I$、量的変数の数を $K_1$、質的変数の数を $K_2$ としたとき、FAMDが構成するデータ行列の列数 $J$ は次のように表される。
$$J = K_1 + \sum_{k=K_1+1}^{K_1+K_2} q_k$$
ここで $q_k$ は $k$ 番目の質的変数が持つカテゴリ数である。
※記号の意味:$\sum$(シグマ)は「合計する」ことを意味する記号である。つまりこの式は、「量的変数の数($K_1$)」に「各質的変数のカテゴリ数をすべて足し合わせたもの」を加えると、最終的な列数 $J$ になる、ということを表している。
この式からもわかるように、カテゴリ数が多い質的変数ほど列数への寄与(=軸への潜在的な影響力)が大きくなる。したがって、実務上は次の2点に注意する必要がある。
- サンプル数が極端に少ない希少カテゴリは、地図の隅で小さくつぶやいているだけなのに、その一言が地図全体の向きを歪めてしまうことがある。事前に近縁カテゴリへ統合しておくことが望ましい。
- カテゴリ数が多い変数(例:8段階の重症度分類)は、二値変数よりも軸への影響力が強くなりやすいため、変数選択やカテゴリの粗視化が妥当かどうかを検討する必要がある。
※コラム:固有値・寄与率とは
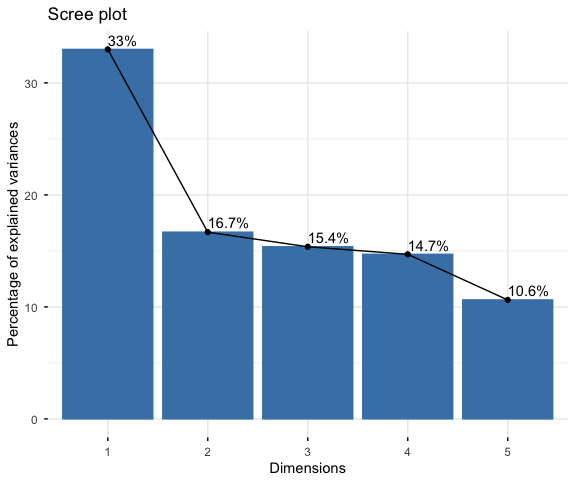
FAMDを含む主成分分析系の手法では、抽出された各軸(次元)に「固有値」という数値が対応する。固有値は、その軸がデータ全体のばらつきをどれだけ雄弁に説明しているかを示すスコアのようなものだと考えるとよい。固有値が大きい軸ほど、データの物語を多く語っている軸だと言える。慣習的に「固有値が1以上の軸を採用する」という基準(Kaiserの基準)がよく使われる。
ただし、この基準はもともと「全変数を標準化した通常のPCA」を前提に考案されたものであり、FAMDのように質的変数がダミー展開されて総慣性の構造がPCAと異なる場合には、そのまま機械的に適用してよいかは議論の余地がある。あくまで一つの目安として使い、スクリープロットの目視や累積寄与率(例えば60〜70%を超えるか)も併せて確認したうえで、最終的な採用次元数を判断するのが実務上望ましい。
3. FAMD後の階層的クラスタリング(HCPC)という正攻法
FAMDによって量的変数と質的変数を対等に扱った主成分が得られたら、次はその主成分に対して階層的クラスタリング(HCPC: Hierarchical Clustering on Principal Components)を適用することで、臨床的に解釈しやすい患者表現型(フェノタイプ)を同定できる。
この「FAMDで次元縮約 → HCPCでクラスタリング」という2段階アプローチは、実際の医学論文でも繰り返し採用されている定番の型である。例えば、COVID-19入院患者を対象に34項目の臨床変数へFAMDを適用したうえで複数のクラスタリング手法を比較し表現型を同定した研究、慢性心不全患者においてFAMDで抽出した固有値1以上の主成分をもとに階層的k-means法でフェノタイピングを行い予後の異なる3群を同定した研究、レビー小体型認知症患者の生物学的・臨床的・人口統計学的データにFAMDを適用して3次元を抽出し階層的クラスタリングで4つのサブグループに分類した研究などが報告されている。
いずれの研究にも共通するのは、「量的変数と質的変数を最初から対等に扱うFAMDでいったん次元を圧縮し、その上で解釈可能なクラスタリングをかける」という設計思想である。
※コラム:HCPC(Hierarchical Clustering on Principal Components)とは
HCPCは、その名の通り「主成分に対して行う階層的クラスタリング」である。通常の階層的クラスタリングを生データにそのまま適用すると、変数間の相関や次元の呪い(変数が多すぎることで距離の意味が薄れる現象)の影響を受けやすい。HCPCはあらかじめFAMDやPCAで次元を集約してから距離計算を行うため、いわば「荷物をコンパクトにまとめてから引っ越し業者(クラスタリング)に渡す」ようなものである。手順としては、①階層的クラスタリングでおおまかな併合の樹形図(デンドログラム)を作り、②そこから得られたクラスタ中心をもとにk-means法で微調整する、という2段階を自動で行う点が特徴であり、単独のk-means法よりも初期値に依存しにくく安定した結果が得られやすい。
4. 【実践Rコード】FAMD → HCPCの実装(Step by Step)
標準パッケージ FactoMineR(FAMDおよびHCPC本体)、factoextra(可視化)、missMDA(欠測値補完)を用いて、疑似臨床データによる一連の流れをStep by Stepで解説する。
Step 1:疑似臨床データの作成
患者200人分について、量的変数(年齢・BMI・BNP値)と質的変数(性別・NYHA心機能分類)を持つ疑似データを生成する。なお、単に各変数を独立に乱数生成すると変数間に何の関連もないデータになり、後段のクラスタリングが意味を持たなくなる。そこで、参考記事同様に「重症度」という共通の潜在変数を介して、BMI・BNP・NYHA分類が連動して変化するようデータを設計する。
library(tidyverse)
library(FactoMineR)
library(factoextra)
library(missMDA)

# 乱数シードの設定
set.seed(123)
n <- 200

# 疑似臨床データの作成(潜在的な「重症度」を介して変数間に相関を持たせる)
df_clin <- tibble(
  id = 1:n,
  age = round(rnorm(n, mean = 68, sd = 9)),
  sex = factor(sample(c("Male", "Female"), n, replace = TRUE))
) %>%
  mutate(
    # 重症度の潜在変数(大きいほど重症)
    severity_latent = 0.04 * (age - 68) + rnorm(n, mean = 0, sd = 1),
    bmi = round(27 - 1.5 * severity_latent + rnorm(n, mean = 0, sd = 2.5), 1),
    bnp = round(exp(5.3 + 0.6 * severity_latent + rnorm(n, mean = 0, sd = 0.3))),
    nyha = case_when(
      severity_latent < -0.6 ~ "I",
      severity_latent < 0.2  ~ "II",
      severity_latent < 1.0  ~ "III",
      TRUE ~ "IV"
    ) %>%
      factor(levels = c("I", "II", "III", "IV"), ordered = TRUE)
  ) %>%
  select(-severity_latent) %>%
  column_to_rownames("id")

# データ構造の確認
glimpse(df_clin)
※コラム:NYHA分類の「順序」はFAMDでどう扱われるか
上記のコードではNYHAを
ordered = TRUEの順序因子として作成しているが、FAMDは質的変数を名義変数(順序なし)として扱うため、この順序情報は解析上生かされない。順序を積極的に活かしたいのであれば「I〜IVを1〜4の量的変数として扱う」という設計もあり得るが、その場合はカテゴリ間の間隔が等間隔であるという強い仮定を置くことになる。どちらを選ぶかは、その順序尺度が本当に等間隔とみなせるかという臨床的判断に委ねられる、という点は覚えておきたい。
Step 2:FAMDの実行と固有値の確認
FactoMineR::FAMD()関数を用いてFAMDを実行し、各次元の固有値・寄与率を確認する。
# FAMDの実行(次元数は暫定的に5次元まで抽出)
res_famd <- FAMD(df_clin, ncp = 5, graph = FALSE)

# 固有値・寄与率の確認
res_famd$eig

# スクリープロットによる採用次元数の目視確認
fviz_screeplot(res_famd, addlabels = TRUE)
固有値が1を上回る次元、あるいはスクリープロットの「肘(エルボー)」の位置までを採用する、というのが実務上の目安である。
Step 3:個体・変数プロットによる可視化
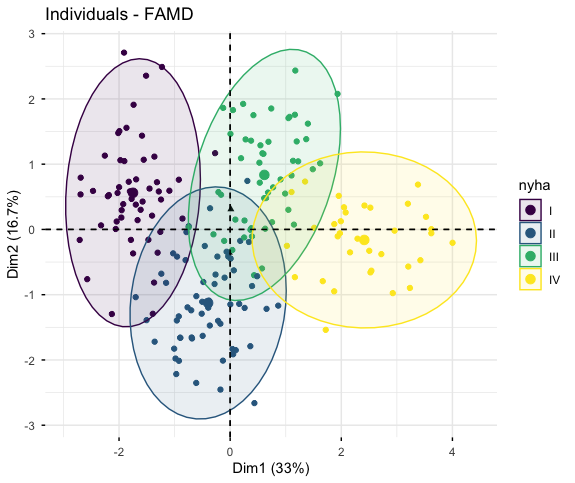
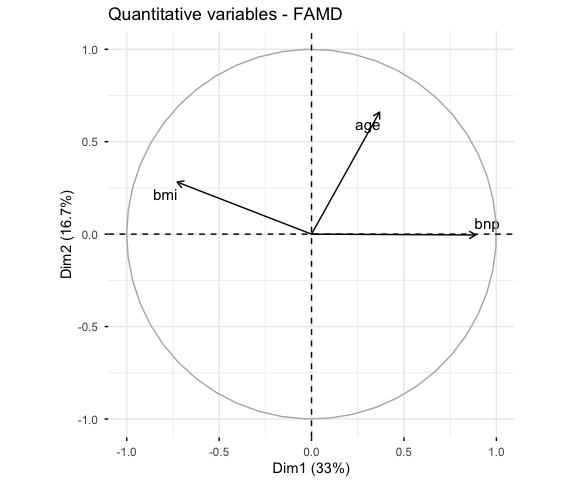
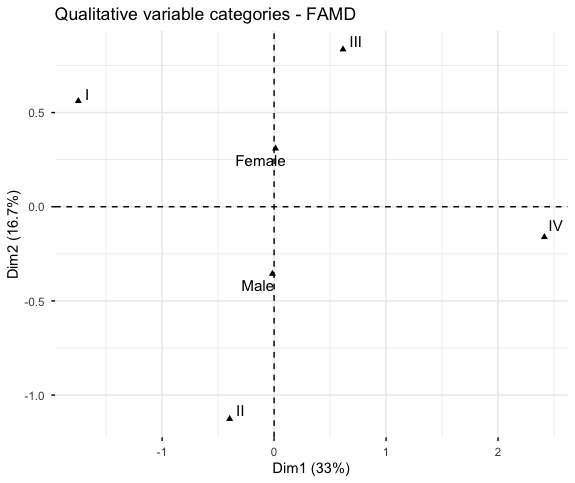
factoextra::fviz_famd()を用いて、個体(患者)と変数(量的・質的)の布置を可視化する。
# 個体(患者)の布置
fviz_famd_ind(res_famd, geom = "point", habillage = "nyha", addEllipses = TRUE)

# 量的変数の布置(相関円)
fviz_famd_var(res_famd, "quanti.var", repel = TRUE, col.var = "black")

# 質的変数のカテゴリの布置
fviz_famd_var(res_famd, "quali.var", repel = TRUE, col.var = "black")
Step 4:HCPCによる臨床表現型クラスタリング
FAMDで抽出した主成分に対してFactoMineR::HCPC()を適用し、階層的クラスタリングによって患者表現型を同定する。
# HCPC(階層的クラスタリング・オン・プリンシパルコンポーネンツ)の実行
res_hcpc <- HCPC(res_famd, nb.clust = -1, graph = FALSE)

# デンドログラムとクラスタ布置の可視化
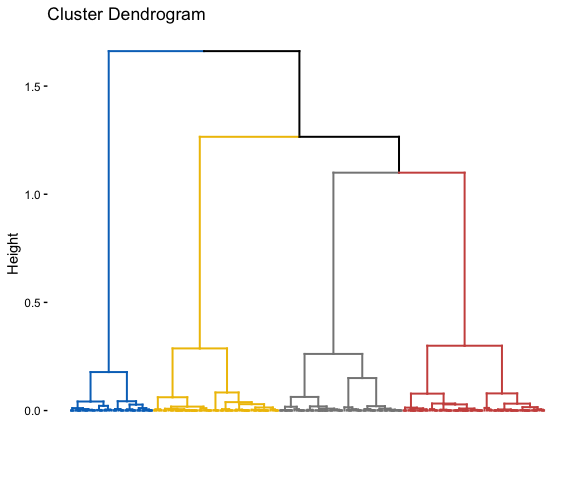
fviz_dend(res_hcpc, show_labels = FALSE, palette = "jco")
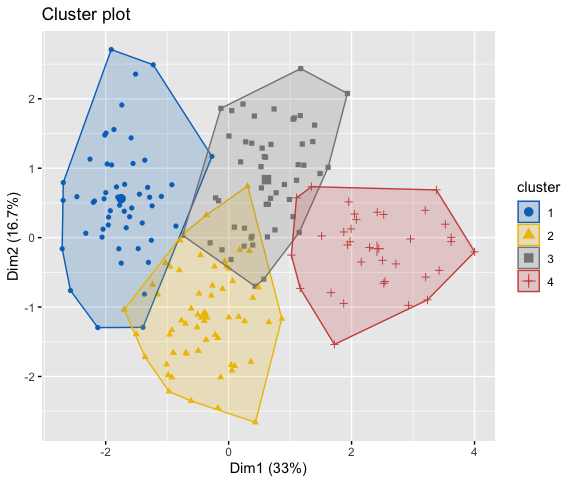
fviz_cluster(res_hcpc, geom = "point", palette = "jco", ellipse.type = "convex")

# 各クラスタを特徴づける変数の確認(記述的統計量による解釈)
res_hcpc$desc.var
nb.clust = -1と指定すると、階層的クラスタリングの結果からクラスタ数が自動的に提案される。ただしこれは慣性利得(inertia gain)が最も大きく変化する点を機械的に検出しているに過ぎないため、この数値のみを鵜呑みにするのではなく、デンドログラムの併合高さの目視確認や、臨床的に意味のあるグループ分けになっているかどうかの検討も併せて行い、最終的なクラスタ数を確定させるのが実務上の流れである。
補足:欠測値がある場合の対処
臨床データでは欠測値が避けられないことが多い。missMDA::imputeFAMD()で補完してからFAMDに渡すのが標準的な対処法である。
# デモ用に、df_clinの各列へランダムに欠測値(NA)を発生させる
set.seed(456)
miss_rate <- 0.05  # 各列につき5%の欠測を発生させる

df_clin_miss <- df_clin

for (col in colnames(df_clin_miss)) {
  na_idx <- sample(seq_len(nrow(df_clin_miss)), size = floor(nrow(df_clin_miss) * miss_rate))
  df_clin_miss[na_idx, col] <- NA
}

# 列ごとの欠測件数を確認
colSums(is.na(df_clin_miss))

# 欠測値補完(次元数は暫定的に5次元と仮定)
res_impute <- imputeFAMD(df_clin_miss, ncp = 5)

# 補完済みデータでFAMDを再実行
res_famd_imputed <- FAMD(res_impute$completeObs, ncp = 5, graph = FALSE)
5. 論文でそのまま使える英文テンプレート(Methods & Results)
Methods セクション英文テンプレート
“Factor analysis of mixed data (FAMD) was performed to reduce the dimensionality of the dataset comprising both continuous and categorical baseline variables. Principal components with an eigenvalue greater than 1 were retained. Hierarchical clustering on principal components (HCPC) was subsequently applied to the retained FAMD dimensions to identify clinically meaningful patient phenotypes.”
Results セクション英文テンプレート
“FAMD extracted four dimensions with eigenvalues greater than 1, cumulatively explaining 79.7% of the total variance. Subsequent hierarchical clustering on these dimensions identified four distinct patient phenotypes, which differed significantly in baseline age, BMI, BNP levels, and NYHA functional class distribution (P < 0.001).”
(上記の分散説明率79.7%やP値等の数値はあくまで記述例であり、実際の解析結果の数値に置き換えて使用されたい。)
6. まとめ&一括コピペ用Rスクリプト
本記事のポイントおさらい
- カテゴリ変数を安易にダミー化して通常のPCA/k-meansに投入してはいけない:スケールの不整合とカテゴリ数の多い変数による支配が生じ、結果が不安定になる。
- 正攻法はFAMDによる対等な次元縮約:量的変数はPCAのように、質的変数はMCAのように扱われ、両者が対等な立場で主成分が決定される。
- FAMD後にHCPCでクラスタリング:固有値1以上(あるいはスクリープロットの肘)の次元を採用し、階層的クラスタリングで臨床表現型を同定するのが医学論文でも定番の設計である。
一括実行用Rスクリプト
# ==============================================================================
# 混合データ因子分析(FAMD)と階層的クラスタリング(HCPC)一括実行スクリプト
# パッケージ: tidyverse, FactoMineR, factoextra, missMDA
# ==============================================================================

if (!requireNamespace("tidyverse", quietly = TRUE)) install.packages("tidyverse")
if (!requireNamespace("FactoMineR", quietly = TRUE)) install.packages("FactoMineR")
if (!requireNamespace("factoextra", quietly = TRUE)) install.packages("factoextra")
if (!requireNamespace("missMDA", quietly = TRUE)) install.packages("missMDA")

library(tidyverse)
library(FactoMineR)
library(factoextra)
library(missMDA)

# 1. 疑似臨床データの作成(潜在的な「重症度」を介して変数間に相関を持たせる)
set.seed(123)
n <- 200

df_clin <- tibble(
  id = 1:n,
  age = round(rnorm(n, mean = 68, sd = 9)),
  sex = factor(sample(c("Male", "Female"), n, replace = TRUE))
) %>%
  mutate(
    severity_latent = 0.04 * (age - 68) + rnorm(n, mean = 0, sd = 1),
    bmi = round(27 - 1.5 * severity_latent + rnorm(n, mean = 0, sd = 2.5), 1),
    bnp = round(exp(5.3 + 0.6 * severity_latent + rnorm(n, mean = 0, sd = 0.3))),
    nyha = case_when(
      severity_latent < -0.6 ~ "I",
      severity_latent < 0.2  ~ "II",
      severity_latent < 1.0  ~ "III",
      TRUE ~ "IV"
    ) %>%
      factor(levels = c("I", "II", "III", "IV"), ordered = TRUE)
  ) %>%
  select(-severity_latent) %>%
  column_to_rownames("id")

# 2. FAMDの実行
cat("\n--- FAMD 実行 ---\n")
res_famd <- FAMD(df_clin, ncp = 5, graph = FALSE)
print(res_famd$eig)

# 3. スクリープロットの表示
p_scree <- fviz_screeplot(res_famd, addlabels = TRUE)
print(p_scree)

# 4. 個体・変数の可視化
p_ind <- fviz_famd_ind(res_famd, geom = "point", habillage = "nyha", addEllipses = TRUE)
p_quanti <- fviz_famd_var(res_famd, "quanti.var", repel = TRUE, col.var = "black")
p_quali <- fviz_famd_var(res_famd, "quali.var", repel = TRUE, col.var = "black")
print(p_ind)
print(p_quanti)
print(p_quali)

# 5. HCPCによる臨床表現型クラスタリング
cat("\n--- HCPC 実行 ---\n")
res_hcpc <- HCPC(res_famd, nb.clust = -1, graph = FALSE)

p_dend <- fviz_dend(res_hcpc, show_labels = FALSE, palette = "jco")
p_cluster <- fviz_cluster(res_hcpc, geom = "point", palette = "jco", ellipse.type = "convex")
print(p_dend)
print(p_cluster)

cat("\n--- クラスタ特徴量の確認 ---\n")
print(res_hcpc$desc.var)
参考文献(実際の臨床応用例)
- Yamga E, Mullie L, Durand M, et al. Interpretable clinical phenotypes among patients hospitalized with COVID-19 using cluster analysis. Front Digit Health. 2023;5:1142822.
- Deng Y, Cheng S, Huang H, et al. Machine Learning-Based Phenomapping in Patients with Heart Failure and Secondary Prevention Implantable Cardioverter-Defibrillator Implantation: A Proof-of-Concept Study. Rev Cardiovasc Med. 2023;24(2):37.
- Abdelnour C, Ferreira D, van de Beek M, et al. Parsing heterogeneity within dementia with Lewy bodies using clustering of biological, clinical, and demographic data. Alzheimers Res Ther. 2022;14(1):14.
おすすめ書籍
多変量解析の基礎 II 主成分分析(改訂版):理論とRによる演習(古橋武 著)
主成分分析の理論をRで段階的に体験しながら学べるKindle書籍。FAMDの数式(分散の標準化・固有値の意味)を本記事より一段深く理解したい読者向けの副読本として適している。

コメント