製品開発の現場で、飲料の味や化粧品の肌触りといった「人間の感覚や嗜好」を客観的な数値として評価したい場面は非常に多い。
その際、最も信頼性が高い手法の1つが「2つのサンプルを提示して $-2 \sim +2$ 点で評価させる」シェッフェの一対比較法である。
しかし、いざ文献や統計ソフトを調べると「シェッフェの原法」「芳賀の変法」「中屋の変法」「浦の変法」という4つのバリエーションが登場し、どれを選ぶべきか困惑した経験はないだろうか。
結論から言えば、食品・飲料・化粧品のように「1人の評価者が何種類も試すと感覚が麻痺してしまう」現場では、芳賀の変法(Haga’s modification)が最も現実的かつ強力なアプローチとなる。
本記事では、4つの変法の違いを直感的な例えで整理した上で、なぜ芳賀の変法が実務最強なのか、その統計モデルの仕組み、多重比較の武器である「ヤードスティック(Yardstick)検定」、そしてRによる完全自動解析・可視化コードまでを徹底解説する。
1. なぜ一対比較法で迷うのか?シェッフェの4つの変法(原法・芳賀・中屋・浦)の違いと選び方フローチャート
一対比較法で迷ってしまう最大の原因は、「実験の制約(1人が何組評価できるか)」と「考慮したい効果(試飲の順番や個人の癖)」の組み合わせによって、数学的なモデルが4パターンに分かれるためである。
わかりやすく例えるなら、変法の選択は「総当たり戦の対戦ルール決め」に似ている。
4つの変法を決める「2つの軸」
4つの変法の違いは、以下の2つの質問に答えるだけで一瞬で整理できる。
- 軸1(評価量): 1人の被験者(パネル)が「1ペア(1組)だけ」評価するのか、それとも「全ペア(全組み合わせ)」を評価するのか?
- 軸2(考慮する効果): 提示する「順序効果(先に試すか後で試すか)」や「パネルの個体差(評価の甘さ・辛さの癖)」をモデルに組み込みたいか?
この2軸によって、4つの手法は明確にマトリクス化される。
| 手法名 | 1人の評価者の評価数 | 提示順序効果 | パネルの個体差 | 例えでわかる実験デザイン |
| シェッフェの原法 | 1組のみ | 考慮する | 考慮しない | 評価者が大勢おり、「A $\rightarrow$ B」と「B $\rightarrow$ A」の順番の違いまで厳密に調べたい場合 |
| 芳賀の変法(★本記事の主役) | 1組のみ | 考慮しない(ランダム化) | 考慮しない | 評価者が大勢いるが、疲労を避けるため1人1組とし、順序はランダムに入れ替えて打ち消す場合 |
| 中屋の変法 | 全組み合わせ | 考慮しない(ランダム化) | 考慮する | 1人が全組み合わせを評価でき(デザインや画像評価など)、評価者の「点の甘さ・辛さ」を補正したい場合 |
| 浦の変法 | 全組み合わせ | 考慮する | 考慮する | 1人が全組を評価でき、さらに順序効果も評価者の癖もすべて完璧にモデル化したい「全部乗せ」モデル |
一発で決まる選択フローチャート
実務で迷ったときは、以下のフローに従って選択すれば間違いがない。
【質問1】1人の評価者に、すべての組み合わせ(全ペア)を試させることができますか?
  │
  ├──[ NO ]──>【質問2】試す順番(A→B か B→A か)の影響を計算で抽出したいですか?
  │                │
  │                ├──[ YES ]──> 【シェッフェの原法】
  │                └──[ NO ] ──> 【芳賀の変法(★ベスト選択)】
  │
  └──[ YES ]──>【質問3】試す順番(順序効果)の影響を計算で抽出したいですか?
                   │
                   ├──[ YES ]──> 【浦の変法】
                   └──[ NO ] ──> 【中屋の変法】
2. 食品・コスメ開発の現場で「芳賀の変法」が最強である理由(1人1組・順序ランダム化の必然性)
なぜ食品やコスメの官能評価(Sensory Evaluation)において、芳賀の変法がこれほど重宝されるのだろうか。そこには現場ならではの切実な物理的制約がある。
官能評価の最大の敵「感度の疲労(Sensory Fatigue)」
例えば、5種類の新商品カレー(A, B, C, D, E)のおいしさを比較したいとする。5種類から2つを選ぶ組み合わせは全部で 10 ペア($\frac{5 \times 4}{2} = 10$)存在する。
もし1人の被験者に10ペア(計20皿のカレー)を食べ比べさせたらどうなるだろうか。
どんなに美食家であっても、3ペア目あたりで舌が麻痺し、お腹がいっぱいになり、後半の評価は適当になるはずだ。香水や口紅のテストでも同様で、鼻や肌の感覚はすぐに麻痺してしまう。これが「感度の疲労」である。
信頼できる官能評価データを得るための絶対条件は、「1人の被験者には1ペア(1組)だけを評価してもらう」ことである。200人の被験者を確保し、20人ずつ10個のペアに割り当てる不完備な設計(分割評価)にするのが最も理にかなっている。
順序効果は「ランダム化(カウンターバランス)」で消せばいい
「先に味わったサンプルの味が口に残って、2番目のサンプルの評価に影響するのではないか?」という懸念(提示順序効果)は当然生じる。
しかし、この順序効果は統計モデルの式に入れてわざわざ計算しなくても、実験の設計段階で消し去ることができる。
例えば A と B のペアを評価する20人のうち、
- 10人には「A $\rightarrow$ B」の順で試飲させる
- 残り10人には「B $\rightarrow$ A」の順で試飲させる
このように順番を半々(ランダム化・カウンターバランス)にすれば、順序による有利・不利は相殺されて消えてしまう。
順序効果をモデルから除外することで計算ロジックが極めてシンプルになり、データ分析の透明性と報告のしやすさが飛躍的に向上する。これこそが、実務で芳賀の変法が最強と呼ばれる理由である。
3. 芳賀の変法の統計モデルと分散分析(ANOVA)の仕組み:主効果・組み合わせ効果・誤差への分解
芳賀の変法では、得られた評点データをどのように分解して統計的に検証するのだろうか。その数式モデルと仕組みを紐解いていく。
数式モデルの分解(得られた点数の「内訳」)
被験者 $l$ が試料 $i$ と 試料 $j$ を比較したときの評点 $x_{ijl}$(例: $-2, -1, 0, +1, +2$)は、以下の3つの要素の足し算として表される。
$$x_{ijl} = (\alpha_i – \alpha_j) + \gamma_{ij} + e_{ijl}$$
この式は、一見難しそうに見えるが、「ある人がつけた点数は、何によって決まったのか?」の内訳を示している。
- $\alpha_i – \alpha_j$(主効果の差):試料 $i$ が本来持つ実力(平均嗜好度)と、試料 $j$ の実力との素直な差。私たちが最も知りたい「本当の心理的距離」である。
- $\gamma_{ij}$(組み合わせ効果 / 交互作用):「特定の2つを並べたときだけに生じる特有の相乗・相殺効果」である。例えるなら、「単体で見ると地味な選手(試料 $i$)が、特定のライバル(試料 $j$)と並んだときだけ急に引き立って見える現象」のようなものである。
- $e_{ijl}$(誤差):個人の体調やその場の気まぐれによる評価のばらつき(ノイズ)。
全変動(平方和)の分解とANOVA表
芳賀の変法では、データ全体のばらつき(全平方和 $S_T$)を、上の要素に対応させて以下のように3つに分解し、F検定を行う。
$$\text{全ばらつき }(S_T) = \text{主効果のばらつき }(S_\alpha) + \text{組み合わせ効果のばらつき }(S_\gamma) + \text{誤差のばらつき }(S_e)$$
試料数を $t$、1ペアあたりの評価者数を $n$ としたときの分散分析表(ANOVA表)の構造は以下の通りである。
| 分散源(要因) | 平方和(SS) | 自由度(df) | 平均平方(MS) | F 値 | 意味と判定内容 |
| 主効果(試料間の差) | $S_\alpha$ | $t – 1$ | $MS_\alpha = \frac{S_\alpha}{t – 1}$ | $\frac{MS_\alpha}{MS_e}$ | 試料間に統計学的な嗜好・評価の差が存在するか?(主目的) |
| 組み合わせ効果 | $S_\gamma$ | $\frac{(t-1)(t-2)}{2}$ | $MS_\gamma = \frac{S_\gamma}{df_\gamma}$ | $\frac{MS_\gamma}{MS_e}$ | 特定のペアだけで起きる特有の相乗効果や相殺効果があるか? |
| 誤差(残差) | $S_e$ | $\frac{t(t-1)(n-1)}{2}$ | $MS_e = \frac{S_e}{df_e}$ | – | 評価者個人の気まぐれや測定誤差 |
| 全体 | $S_T$ | $\frac{t(t-1)n}{2}$ | – | – | 収集した全データのばらつき |
主効果の $F$ 値の $P$ 値が $0.05$ 未満であれば、「試料の間に偶然とは言えない明確な感覚・嗜好の差が存在する」と結論付けることができる。
4. 平均嗜好度の算出と多重比較の武器「ヤードスティック(Yardstick)」検定
分散分析で「試料間に有意差あり」と分かったら、次は「具体的にどのサンプルとどのサンプルの間に差があるのか?」を突き止めるフェーズに入る。ここで登場するのが「平均嗜好度(心理的尺度値)」と「ヤードスティック(Yardstick)」である。
平均嗜好度($\hat{\alpha}_i$)の算出:感覚を「1次元の物差し」に乗せる
各試料 $i$ の平均嗜好度の推定量 $\hat{\alpha}_i$ は、試料 $i$ が獲得した総合評点和 $X_{i.}$ を用いて以下のように計算される。
$$\hat{\alpha}_i = \frac{X_{i.}}{t \cdot n}$$
すべての試料の平均嗜好度を合計すると、必ずちょうどゼロ($\sum_{i=1}^t \hat{\alpha}_i = 0$)になるという美しい性質を持つ。
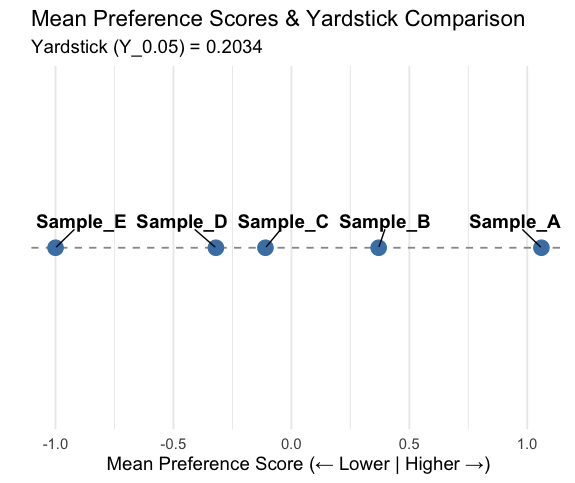
プラスの値が大きいほど「平均してより好ましい・感覚が強い」ことを示し、マイナスに大きいほど「好ましくない・感覚が弱い」ことを示す。これにより、定性的な好き嫌いが「数値化されたポジショニングマップ」へ変換される。
有意差判定の絶対的物差し「ヤードスティック($Y_\alpha$)」
平均嗜好度の位置が求まったら、2つの試料の差 $\vert{}\hat{\alpha}_i – \hat{\alpha}_j\vert{}$ が「意味のある差なのか、偶然の誤差範囲なのか」を判定しなければならない。
通常の多重比較(Tukey法など)ではなく、一対比較法専用の限界値として算出される判定の物差し、それがヤードスティック(Yardstick)である。
ヤードスティック限界値 $Y_\alpha$ の公式は以下の通りである。
$$Y_\alpha = q(t, df_e, \alpha) \cdot \sqrt{\frac{\hat{\sigma}^2}{2 t n}}$$
- $q(t, df_e, \alpha)$: 試料数 $t$、誤差自由度 $df_e$、有意水準 $\alpha$(通常 $0.05$)におけるステューデント化された範囲の限界値(Rの
qtukey関数で算出)。 - $\hat{\sigma}^2$: 分散分析表から得られた誤差の不偏分散($MS_e$)。
例えるなら、ヤードスティックとは「統計学的に引かれた判定用カーソル」である。
2つの試料の平均嗜好度の距離(差)が、このヤードスティックの長さ $Y_{0.05}$ より大きければ、「その2つのサンプルには 5% 水準で有意な選好差がある」と判定できる。
【ヤードスティック検定の判定イメージ】

  試料A (α_A = +0.65)         試料B (α_B = +0.10)       試料C (α_C = -0.75)
 ────┼───────────────────────────┼─────────────────────────┼──────> 心理的尺度
     └─────────── 差 = 0.55 ──────┘
     [==== ヤードスティック Y_0.05 = 0.35 ====]

 ➔ 試料Aと試料Bの差(0.55) > ヤードスティック(0.35)
 ➔ A と B の間には「有意差あり!」と判定できる。
5. 【実践Rコード】芳賀の変法による分散分析表の作成・ヤードスティック限界値計算・尺度図描画(Step by Step)
ここからは、実際にRを用いて、疑似データの作成から分散分析表(ANOVA)の出力、ヤードスティック限界値の算出、そして直感的な心理的尺度図(ggplot2)の描画までを行う手順を解説する。
Step 1: 疑似官能評価データの作成
5種類の清涼飲料水(Sample_A, B, C, D, E)を評価する実験を想定する。
- 試料数 $t = 5$(ペア数 = $\frac{5 \times 4}{2} = 10$ ペア)
- 1ペアあたりの評価者数 $n = 20$ 人(総被験者数 200 人)
- 評価点: $-2$(非常に悪い) $\sim$ $+2$(非常によい)
library(tidyverse)

# 乱数シードの設定
set.seed(123)

t <- 5  # 試料数
n <- 20 # 1ペアあたりの評価者数
sample_names <- paste0("Sample_", LETTERS[1:t])

# 全10ペアの組み合わせを作成
pairs <- combn(sample_names, 2)

# 疑似評点データの生成関数
generate_data <- function() {
  data_list <- list()

  # 設定する真の嗜好度(Aが最も高く、Eが最も低い)
  true_alpha <- c(0.8, 0.3, 0.0, -0.3, -0.8)
  names(true_alpha) <- sample_names

  for (k in 1:ncol(pairs)) {
    s1 <- pairs[1, k]
    s2 <- pairs[2, k]

    # 真の差 + ノイズから評点(-2 ~ +2)を生成
    diff <- true_alpha[s1] - true_alpha[s2]
    scores <- round(rnorm(n, mean = diff * 1.5, sd = 0.9))
    scores <- pmax(-2, pmin(2, scores)) # -2~+2の範囲に収める

    df_pair <- tibble(
      sample1 = s1,
      sample2 = s2,
      score = scores
    )
    data_list[[k]] <- df_pair
  }
  bind_rows(data_list)
}

raw_data <- generate_data()
head(raw_data)
Step 2: 各ペアの合計点行列と試料ごとの総合評点和の集計
芳賀の変法の計算に必要な、各ペアの評点和 $X_{ij}$ と、各試料の総合評点和 $X_{i.}$ を計算する。
# t × t の評点和行列 X_ij の作成
X_matrix <- matrix(0, nrow = t, ncol = t, dimnames = list(sample_names, sample_names))

for (i in 1:nrow(raw_data)) {
  s1 <- raw_data$sample1[i]
  s2 <- raw_data$sample2[i]
  sc <- raw_data$score[i]

  s1_idx <- match(s1, sample_names)
  s2_idx <- match(s2, sample_names)

  X_matrix[s1_idx, s2_idx] <- X_matrix[s1_idx, s2_idx] + sc
  X_matrix[s2_idx, s1_idx] <- X_matrix[s2_idx, s1_idx] - sc # 対称成分は符号反転
}

# 各試料の総合評点和 X_i. の算出
X_i_dot <- rowSums(X_matrix)

print(X_matrix)
print(X_i_dot)
Step 3: 芳賀の変法による分散分析(ANOVA)表の構築
平方和 $S_T, S_\alpha, S_\gamma, S_e$ および自由度を計算し、分散分析表を作成する。
# 総平方和 S_T の計算
S_T <- sum(raw_data$score^2)

# 主効果の平方和 S_alpha の計算
S_alpha <- sum(X_i_dot^2) / (t * n)

# 組み合わせ効果を含むペア平方和 S_pair の計算
# (上三角成分のみを使用)
X_ij_upper <- X_matrix[upper.tri(X_matrix)]
S_pair <- sum(X_ij_upper^2) / n

# 組み合わせ効果の平方和 S_gamma
S_gamma <- S_pair - S_alpha

# 誤差平方和 S_e
S_e <- S_T - S_alpha - S_gamma

# 自由度 (df) の計算
df_alpha <- t - 1
df_gamma <- (t - 1) * (t - 2) / 2
df_e <- (t * (t - 1) / 2) * (n - 1)
df_total <- t * (t - 1) * n / 2

# 平均平方 (MS) と F値の計算
MS_alpha <- S_alpha / df_alpha
MS_gamma <- S_gamma / df_gamma
MS_e <- S_e / df_e

F_alpha <- MS_alpha / MS_e
F_gamma <- MS_gamma / MS_e

p_alpha <- pf(F_alpha, df_alpha, df_e, lower.tail = FALSE)
p_gamma <- pf(F_gamma, df_gamma, df_e, lower.tail = FALSE)

# ANOVA表のデータフレーム作成
anova_table <- tibble(
  Source = c("主効果 (試料差)", "組み合わせ効果", "誤差 (残差)", "全体"),
  SS = c(S_alpha, S_gamma, S_e, S_T),
  df = c(df_alpha, df_gamma, df_e, df_total),
  MS = c(MS_alpha, MS_gamma, MS_e, NA),
  F_value = c(F_alpha, F_gamma, NA, NA),
  p_value = c(p_alpha, p_gamma, NA, NA)
)

print(anova_table)
Step 4: 平均嗜好度 $\hat{\alpha}_i$ とヤードスティック限界値 $Y_{0.05}$ の算出
平均嗜好度(心理的尺度値)と、多重比較の基準となるヤードスティック限界値を算出する。
# 平均嗜好度 (α_hat) の算出
alpha_hat <- X_i_dot / (t * n)

# 5%水準のヤードスティック限界値 Y_0.05 の計算
# qtukey(p, nmeans, df) を使用
q_val <- qtukey(p = 0.95, nmeans = t, df = df_e)
yardstick_05 <- q_val * sqrt(MS_e / (2 * t * n))

cat("--- 平均嗜好度 (心理的尺度値) ---\n")
print(round(alpha_hat, 4))

cat(sprintf("\nヤードスティック限界値 (Y_0.05): %.4f\n", yardstick_05))
Step 5: 心理的尺度図(ポジショニングマップ)の ggplot2 可視化
求まった平均嗜好度とヤードスティック幅を1次元のポジショニングマップとして美しくグラフ化する。
# 可視化用データフレームの作成
df_plot <- tibble(
  Sample = names(alpha_hat),
  Alpha = as.numeric(alpha_hat)
) %>%
  mutate(Sample = factor(Sample, levels = Sample[order(Alpha)]))

# 尺度図の描画
ggplot(df_plot, aes(x = Alpha, y = 1, label = Sample)) +
  geom_hline(yintercept = 1, color = "gray60", linetype = "dashed") +
  geom_point(size = 5, color = "steelblue") +
  ggrepel::geom_text_repel(size = 5, vjust = -1.5, fontface = "bold") +
  scale_y_continuous(limits = c(0.5, 1.5)) +
  theme_minimal(base_size = 14) +
  labs(
    title = "Mean Preference Scores & Yardstick Comparison",
    subtitle = sprintf("Yardstick (Y_0.05) = %.4f", yardstick_05),
    x = "Mean Preference Score (← Lower | Higher →)",
    y = ""
  ) +
  theme(
    axis.text.y = element_blank(),
    axis.ticks.y = element_blank(),
    panel.grid.major.y = element_blank(),
    panel.grid.minor.y = element_blank()
  )
6. まとめ&一括コピペ用Rスクリプト
本記事のポイントおさらい
- シェッフェの4つの変法は実験制約で選ぶ: 食品・コスメなど、1人の被験者に1ペアしか試させられない場合は「芳賀の変法」がベストアプローチ。
- 順序効果はランダム化で相殺する: 提示順序の有利・不利はカウンターバランス(ランダム化)で消すことで、モデルから排除してシンプルに解析できる。
- 主効果と組み合わせ効果を分ける: ANOVAによって「商品自体の実力差」と「特定の並びによる相乗・相殺効果」を明確に分離して検定できる。
- ヤードスティック(Yardstick)で差を判定: 平均嗜好度(心理的尺度値)の差がヤードスティック限界値 $Y_{0.05}$ より大きければ統計的有意差ありと判定する。
一括実行用Rスクリプト
以下のコードをコピー&ペーストすることで、データの集計から分散分析表の出力、平均嗜好度の算出、ヤードスティック限界値の表示、尺度図プロットまでを一気通貫で走らせることができる。
# ==============================================================================
# シェッフェの一対比較法(芳賀の変法)一括解析スクリプト
# パッケージ: tidyverse, ggrepel
# ==============================================================================

if (!requireNamespace("tidyverse", quietly = TRUE)) install.packages("tidyverse")
if (!requireNamespace("ggrepel", quietly = TRUE)) install.packages("ggrepel")

library(tidyverse)
library(ggrepel)

# --- 1. 疑似官能評価データの生成 ---
set.seed(123)
t <- 5  # 試料数
n <- 20 # 1ペアあたりの評価者数
sample_names <- paste0("Sample_", LETTERS[1:t])
pairs <- combn(sample_names, 2)

true_alpha <- c(0.8, 0.3, 0.0, -0.3, -0.8)
names(true_alpha) <- sample_names

data_list <- list()
for (k in 1:ncol(pairs)) {
  s1 <- pairs[1, k]
  s2 <- pairs[2, k]
  diff <- true_alpha[s1] - true_alpha[s2]
  scores <- round(rnorm(n, mean = diff * 1.5, sd = 0.9))
  scores <- pmax(-2, pmin(2, scores))
  data_list[[k]] <- tibble(sample1 = s1, sample2 = s2, score = scores)
}
raw_data <- bind_rows(data_list)

# --- 2. 評点和行列および総合評点和の算出 ---
X_matrix <- matrix(0, nrow = t, ncol = t, dimnames = list(sample_names, sample_names))
for (i in 1:nrow(raw_data)) {
  s1_idx <- match(raw_data$sample1[i], sample_names)
  s2_idx <- match(raw_data$sample2[i], sample_names)
  sc <- raw_data$score[i]
  X_matrix[s1_idx, s2_idx] <- X_matrix[s1_idx, s2_idx] + sc
  X_matrix[s2_idx, s1_idx] <- X_matrix[s2_idx, s1_idx] - sc
}
X_i_dot <- rowSums(X_matrix)

# --- 3. 分散分析 (ANOVA) 表の構築 ---
S_T <- sum(raw_data$score^2)
S_alpha <- sum(X_i_dot^2) / (t * n)
S_pair <- sum(X_matrix[upper.tri(X_matrix)]^2) / n
S_gamma <- S_pair - S_alpha
S_e <- S_T - S_alpha - S_gamma

df_alpha <- t - 1
df_gamma <- (t - 1) * (t - 2) / 2
df_e <- (t * (t - 1) / 2) * (n - 1)
df_total <- t * (t - 1) * n / 2

MS_alpha <- S_alpha / df_alpha
MS_gamma <- S_gamma / df_gamma
MS_e <- S_e / df_e

F_alpha <- MS_alpha / MS_e
F_gamma <- MS_gamma / MS_e

p_alpha <- pf(F_alpha, df_alpha, df_e, lower.tail = FALSE)
p_gamma <- pf(F_gamma, df_gamma, df_e, lower.tail = FALSE)

anova_table <- tibble(
  Source = c("主効果 (試料差)", "組み合わせ効果", "誤差 (残差)", "全体"),
  SS = c(S_alpha, S_gamma, S_e, S_T),
  df = c(df_alpha, df_gamma, df_e, df_total),
  MS = c(MS_alpha, MS_gamma, MS_e, NA),
  F_value = c(F_alpha, F_gamma, NA, NA),
  p_value = c(p_alpha, p_gamma, NA, NA)
)

# --- 4. 平均嗜好度とヤードスティック算出 ---
alpha_hat <- X_i_dot / (t * n)
q_val <- qtukey(p = 0.95, nmeans = t, df = df_e)
yardstick_05 <- q_val * sqrt(MS_e / (2 * t * n))

# 出力表示
cat("==================================================================\n")
cat("          シェッフェの一対比較法(芳賀の変法)解析結果            \n")
cat("==================================================================\n\n")
cat("【分散分析表 (ANOVA)】\n")
print(anova_table)
cat("\n【平均嗜好度 (心理的尺度値)】\n")
print(round(alpha_hat, 4))
cat(sprintf("\n【ヤードスティック限界値 (Y_0.05)】: %.4f\n", yardstick_05))
cat("==================================================================\n")

# --- 5. 心理的尺度図の描画 ---
df_plot <- tibble(
  Sample = names(alpha_hat),
  Alpha = as.numeric(alpha_hat)
) %>% mutate(Sample = factor(Sample, levels = Sample[order(Alpha)]))

p_map <- ggplot(df_plot, aes(x = Alpha, y = 1, label = Sample)) +
  geom_hline(yintercept = 1, color = "gray60", linetype = "dashed") +
  geom_point(size = 5, color = "steelblue") +
  geom_text_repel(size = 5, vjust = -1.5, fontface = "bold") +
  scale_y_continuous(limits = c(0.5, 1.5)) +
  theme_minimal(base_size = 14) +
  labs(
    title = "平均嗜好度(心理的尺度図)とヤードスティック比較",
    subtitle = sprintf("Yardstick (Y_0.05) = %.4f", yardstick_05),
    x = "平均嗜好度 (← 評価低い | 評価高い →)",
    y = ""
  ) +
  theme(
    axis.text.y = element_blank(),
    axis.ticks.y = element_blank(),
    panel.grid.major.y = element_blank(),
    panel.grid.minor.y = element_blank()
  )

print(p_map)
おすすめ書籍
ただし、かなり古く中古しかない

コメント