医療現場において、疾患の発症リスクや治療効果を予測する「臨床予測モデル」は、より精度の高い意思決定を支援する強力なツールである。新しいバイオマーカーを加えたモデルが既存のモデルより良いかを比べるとき、まず思い浮かぶのはAUCだろう。しかしAUCだけでは、「新しいモデルにしたことで、どの患者のリスク評価がどう変わったのか」まではわからない。本記事では、この変化を数値にする指標である「NRI (Net Reclassification Improvement)」と「IDI (Integrated Discrimination Improvement)」に焦点を当て、その概要、他の評価指標との違い、Rでの計算例、結果の解釈、そして使うときの注意点までを分かりやすく解説する。
NRIとIDIの概要
臨床予測モデルの評価には、AUC(Area Under the Curve)など様々な指標が用いられる。AUCはモデルの識別能、つまり病気の人とそうでない人をどれだけ区別できるかを示す優れた指標である。しかし、AUCはリスクスコアの順序付けに着目した指標なので、新しいモデルにしたことで個々の患者のリスク評価がどう変わったかまでは教えてくれない。
そこで考えられたのが、NRIとIDIである(Pencina 2008)。これらの指標は、新しいモデルで患者のリスク区分や予測確率がどれだけ「正しい方向」に動いたかを評価する。
- NRI (Net Reclassification Improvement:純再分類改善度): リスク区分(例:低・中・高)をあらかじめ決めておき、新しいモデルにしたとき、実際にイベントが発生した人がより高いリスク区分に、イベントが発生しなかった人がより低いリスク区分に移ったかを数える指標である。具体的には、イベント発生群の「良い方向に移った割合-悪い方向に移った割合」と、非発生群の同じ値を足し合わせたものである。分母の違う2つの割合の和なので、最大値は2になり、「全患者のうち何%が正しく再分類されたか」という意味にはならない。そのため、合計だけでなく、イベント発生群と非発生群の値を分けて示すことがすすめられている(Leening 2014)。NRIは設定されたリスク閾値(カットオフ値)に基づいて計算されるため、治療方針の境目と結びつけて考えやすいという特徴を持つ。
- IDI (Integrated Discrimination Improvement:統合識別改善度): 「イベント発生群の平均予測確率-非発生群の平均予測確率」(識別の傾き、discrimination slope と呼ぶ)が、新しいモデルでどれだけ広がったかを示す指標である。簡単に言えば、病気の人では予測確率が高く、健康な人では予測確率が低い、という「見分ける力」の向上を数値にする。IDIはNRIと異なり、特定の閾値に依存せず、予測確率の分布全体の変化を評価する。
どちらも「予測がどれだけ良くなったか」を、リスク区分や予測確率の動きで表す指標である。ただし、治療する・しないを決めたときの得と損(見逃しと過剰治療の重み)は計算に入っていない。治療判断にとっての有用性(臨床的有用性)を直接評価するには、意思決定曲線分析(DCA)の net benefit を使う(Vickers 2006)。NRI・IDIは、AUCと臨床的有用性のあいだを埋める「補助的な指標」と考えるとよい。
使い分けのガイドライン
基本的には、まずAUCと較正プロットでモデルの土台を確認し、次にNRI・IDIで「どの患者の評価がどう変わったか」を見て、最後に意思決定曲線分析(DCA)で治療判断にとっての有用性を確かめる、という順で深掘りしていくとよい。較正プロットは、予測確率と実際の発生率が合っているかを見る図である。後のコラムで見るように、較正の悪いモデルではNRI・IDIが見かけ上よく出てしまうため、この確認は欠かせない。
AUCがモデルの全体的な識別能を見るのに対し、NRIとIDIはモデルが個々の患者のリスク評価をどれだけ「正しい方向」に動かしたかに焦点を当てる。
- モデル開発の初期段階: AUCと較正プロットを用いて、モデルの基本的な性能を確認する。
- 既存モデルの改良・新規モデルの比較: NRIやIDIを用いて、新しいモデルで患者のリスク評価がどう変わったかを評価する。AUCは既にある程度高いモデルに項目を足しても数値が動きにくいため、わずかな予測確率の変化がリスク区分の変更につながる様子は、NRIやIDIのほうが見えやすい。
ただし、既存のモデルに項目を足した新モデル(入れ子のモデル)では、「足した項目に意味があるか」は、その項目の尤度比検定で確かめるのが基本である。NRI・IDIのP値は、その代わりにはならない(Pepe 2013)。シミュレーション(n=500、1000回)でも、本当に役立つ項目(1SDあたりオッズ比 約1.5)を足したとき、「改善あり(P<0.05)」と判定できた割合は次のとおりで、尤度比検定が最も確実だった。
| 方法 | 「改善あり」と判定できた割合 |
|---|---|
| 追加した項目の尤度比検定 | 92% |
| IDI | 87% |
| NRI (Continuous) | 82% |
| NRI (Categorical) | 42% |
① IDIを使うべき場面
- 予測確率の「見分ける力」全体の向上を示したいとき。
- まだ明確な治療の閾値が決まっていない研究段階で、新しく追加した変数(バイオマーカーなど)が予測能を全体的に高めているかを確認したいとき。
② NRIを使うべき場面
- リスク区分の変化として、改善を具体的に示したいとき。
- 「イベントが起きた人のうち、正味で何%がより高いリスク区分に移ったか」「起きなかった人のうち、正味で何%がより低い区分に移ったか」を、それぞれ示したいとき。合計のNRIは2つの割合の和なので、「100人中○人がより適切な治療を受けられる」とは読めない点に注意する。
- ガイドライン等で「リスク20%以上で投薬」などの閾値が明確に決まっているとき。
具体例
架空の心血管疾患発症予測モデルを例に考えてみよう。既存モデルと新しいモデルがあり、新しいモデルが既存モデルよりも心血管疾患発症リスクの予測精度を高めているかを評価する。
シナリオ:
- イベント: 10年以内の心血管疾患発症(Yes/No)
- 患者数: 1000人
- リスクカテゴリー: 低リスク(予測確率 < 0.1)、中リスク(0.1 ≦ 予測確率 < 0.3)、高リスク(予測確率 ≧ 0.3)
旧モデルと新モデルで各患者のリスク確率が計算され、それぞれの閾値に基づいてリスクカテゴリーに分類される。NRIは、この再分類の結果を分析し、イベント発生群と非発生群のそれぞれで、より適切なリスクカテゴリーへ移動した人の正味の割合を評価する。IDIは、イベント発生群と非発生群それぞれの予測確率の平均値の変化を評価し、両群の分離がどれだけ改善されたかを定量化する。
なお、Categorical NRIはリスク区分の切り方で値が変わる。たとえば同じデータ・同じ2つのモデル(シミュレーション、n=1000)でも、切り方を変えるだけで次のようになった。
| 区分の切り方 | NRI | イベント発生群 | 非発生群 |
|---|---|---|---|
| 10%・30%(本記事と同じ) | 0.062 | 0.009 | 0.053 |
| 20%の1本 | 0.038 | 0.013 | 0.025 |
| 15%・25% | 0.093 | 0.052 | 0.042 |
| 5・10・20・30・50%(6区分) | 0.158 | 0.077 | 0.081 |
区分は、治療方針が変わる境目など臨床的な根拠で、解析の前に決めておく。結果を見てから切り方を選ぶと、NRIはいくらでも大きく見せられてしまう。
R 計算例
ここでは、Rを用いたNRIとIDIの計算例を示す。PredictABELパッケージの reclassification() 関数で、再分類表とNRI・IDIをまとめて計算できる。
最初の例では、あえて「新モデルに新しい情報が何も入っていない」ダミーデータを使う。改善がないときにNRIとIDIがどう出るかを見ておくと、実際のデータで結果を読むときの物差しになるからである。
R スクリプト例:
if(!require(PredictABEL)) install.packages("PredictABEL")
library(PredictABEL)

# ダミーデータの作成(実際は臨床データを使用)
set.seed(123)
n <- 1000
outcome <- rbinom(n, 1, 0.2) # イベント発生有無 (1:発生, 0:非発生)。予測確率とは無関係に作っている

# 旧モデルと新モデルの予測確率
# 旧モデル (例: 年齢、性別など)
pred_old <- runif(n, 0.05, 0.4)
# 新モデル (例: 旧モデルに加えて、新しいバイオマーカーなど)
# ここでは旧モデルに乱数(偶然の揺れ)を足しただけで、新しい情報は入っていない
# =「改善がないはずの例」
pred_new <- pred_old + rnorm(n, 0, 0.1)
pred_new[pred_new < 0] <- 0
pred_new[pred_new > 1] <- 1

data <- data.frame(outcome, pred_old, pred_new)

# リスク閾値の定義
# 実際の臨床ガイドラインやリスク評価に基づき、解析の前に決めておく
thresholds <- c(0, 0.1, 0.3, 1)

# NRIとIDIの計算
# reclassification関数でNRIとIDIをまとめて計算できる
# cOutcome: イベント発生有無 (0/1) の列番号
# predrisk1: 旧モデルの予測確率
# predrisk2: 新モデルの予測確率
# cutoff: リスク閾値ベクトル
reclassification(
    data = data,
    cOutcome = 1, # outcome変数の列番号
    predrisk1 = pred_old,
    predrisk2 = pred_new,
    cutoff = thresholds
)
実行結果:
> reclassification(
+     data = data,
+     cOutcome = 1, # outcome変数の列番号
+     predrisk1 = pred_old,
+     predrisk2 = pred_new,
+     cutoff = thresholds
+ )
 _________________________________________

     Reclassification table
 _________________________________________

 Outcome: absent

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)        70        37       2              36
    [0.1,0.3)      68       292     104              37
    [0.3,1]         1        63     165              28


 Outcome: present

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)        21        15       2              45
    [0.1,0.3)      20        61      23              41
    [0.3,1]         3        12      41              27


 Combined Data

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)        91        52       4              38
    [0.1,0.3)      88       353     127              38
    [0.3,1]         4        75     206              28
 _________________________________________

 NRI(Categorical) [95% CI]: 0.0115 [ -0.0832 - 0.1063 ] ; p-value: 0.81139
 NRI(Continuous) [95% CI]: 0.0481 [ -0.1072 - 0.2034 ] ; p-value: 0.54352
 IDI [95% CI]: 0.006 [ -0.0098 - 0.0218 ] ; p-value: 0.45377
このダミーデータでは、イベントの有無は予測確率と無関係に作っており、新モデルは旧モデルに乱数を足しただけである。実際、AUCは旧モデル0.521、新モデル0.504で、どちらもコイン投げ(0.5)とほとんど変わらない。予測確率と実際の結果のずれを表すBrierスコア(小さいほど良い)は、旧モデル0.172、新モデル0.179で、新モデルのほうがむしろ悪い。天気予報に「サイコロで決めた補正」を足したようなものである。
結果読み取り
IDI
IDIは、「予測確率の平均値」の変化から計算している。
- Present群(イベント発生群): 平均予測確率($\text{IS}$:Integrated Sensitivity)。新モデルで上がってほしい。
- Absent群(イベント非発生群): 平均予測確率($\text{IP}$:Integrated 1-Specificity)。新モデルで下がってほしい。
$$IDI = (\text{IS}_{new} – \text{IS}_{old}) – (\text{IP}_{new} – \text{IP}_{old})$$
$$= (\text{Mean } P_{new, present} – \text{Mean } P_{old, present}) – (\text{Mean } P_{new, absent} – \text{Mean } P_{old, absent})$$
これは「イベント発生群と非発生群の平均予測確率の差」(識別の傾き)が、どれだけ広がったかと同じである。今回の例では、Present群の平均予測確率は0.0123上がったが、Absent群の平均予測確率も0.0063上がっており(本来は下がってほしい)、差し引きでIDIは 0.006 となった。両群の予測確率の差が0.6ポイント広がったことになるが、95%信頼区間は-0.0098〜0.0218で0をまたいでおり、改善があるとは言えない。
NRI (Continuous)
NRI(Continuous) は、上記の表(0.1や0.3といった閾値)を使わず、「予測確率がわずかでも上がったか下がったか」ですべての動きをカウントしたものである。
- 区分の境目をまたがない小さな変化も拾うため、Categorical NRIより大きな値が出やすい。意味のない項目を足しただけでも正の値が出ることがあるので(Pencina 2011、Kerr 2014)、値の大きさだけで判断しないようにしたい。
- 今回は
0.0481であるが、95%信頼区間(-0.1072〜0.2034)が0をまたいでおり、改善があるとは言えない。
NRI (Categorical)
NRIは、「イベント発生群(Present)での正味の改善割合」と「イベント非発生群(Absent)での正味の改善割合」の合計である。
① Outcome: present (イベント発生群) の動き
この群では、リスクカテゴリーが上がることが「改善」。
- Up (改善): $15 + 2 + 23 = 40$ 人
- Down (改悪): $20 + 3 + 12 = 35$ 人
- 計算: $\frac{(40 – 35)}{\text{Total Present (198)}} = \frac{5}{198} \approx 0.025$
② Outcome: absent (イベント非発生群) の動き
この群では、リスクカテゴリーが下がることが「改善」。
- Down (改善): $68 + 1 + 63 = 132$ 人
- Up (改悪): $37 + 2 + 104 = 143$ 人
- 計算: $\frac{(132 – 143)}{\text{Total Absent (802)}} = \frac{-11}{802} \approx -0.014$
③ NRI の合計
$$NRI = \frac{5}{198} + \frac{-11}{802} = 0.0253 – 0.0137 = 0.0115$$
- (各項を四捨五入してから足すと0.0116になるが、Rは丸める前の値で計算しているので0.0115となる。)
- この
0.0115も数値上はわずかにプラスだが、95%信頼区間(-0.0832〜0.1063)は0をまたいでおり、改善があるとは言えない。 - 分母が198人と802人で違う2つの割合を足しているので、「1000人中1.15%が正しく再分類された」という意味ではない。
総合的な解釈
この結果から以下のことが言える:
- 改善の有無: NRI(Categorical・Continuous)もIDIも0に近く、どの95%信頼区間も0をまたいでいる。新モデルが旧モデルより良くなったとは言えない。
- データとの対応: これは、新モデルが旧モデルに乱数を足しただけで、新しい情報を持っていないことと合っている。改善がないときには、NRIとIDIは0の周りでばらつく。
- 群ごとの中身: Categorical NRIを分けて見ると、イベント発生群は+0.025、非発生群は-0.014だった。合計の値だけでなく、どちらの群で改善・悪化したのかを確認しておくとよい。
- 臨床的意義: NRIやIDIに「この値以上なら臨床的に意味がある」という決まった基準はない。値の大きさは、信頼区間、較正、臨床的有用性(DCA)と合わせて判断する。
実用的な推奨事項
- 今回の例のようにNRI・IDIに改善が見られない場合、新モデル(新しい項目を測る手間やコスト)を採用する理由は乏しい。
- NRI・IDIだけで判断せず、他の評価指標(AUC、較正プロット、意思決定曲線分析(DCA)など)も併せて評価する。
- 既存のモデルに項目を足した新モデルなら、まず追加した項目の尤度比検定で、項目に意味があるかを確かめる。
- 新しい項目を測るコストも考慮に入れる(費用対効果分析)。
- 同じデータで作って同じデータで評価すると、性能は楽観的に出る。ブートストラップによる内的検証や、別のデータでの外的検証で確かめる。
コラム:較正の悪いモデルでも、NRI・IDIは「改善」と出る
NRIとIDIは、イベント発生群の予測が上がり、非発生群の予測が下がると「改善」と数える。そのため、新しい情報が何もなくても、予測確率を極端にしただけで値が大きくなる。
シミュレーションで確かめてみた。旧モデルは正しいモデル(較正良好)で、新モデルは患者の並び順はまったく同じまま、予測確率だけを極端にしたもの(較正の傾き 約0.67)である。下の図は、その1回分(n=1000)の較正プロットだ。
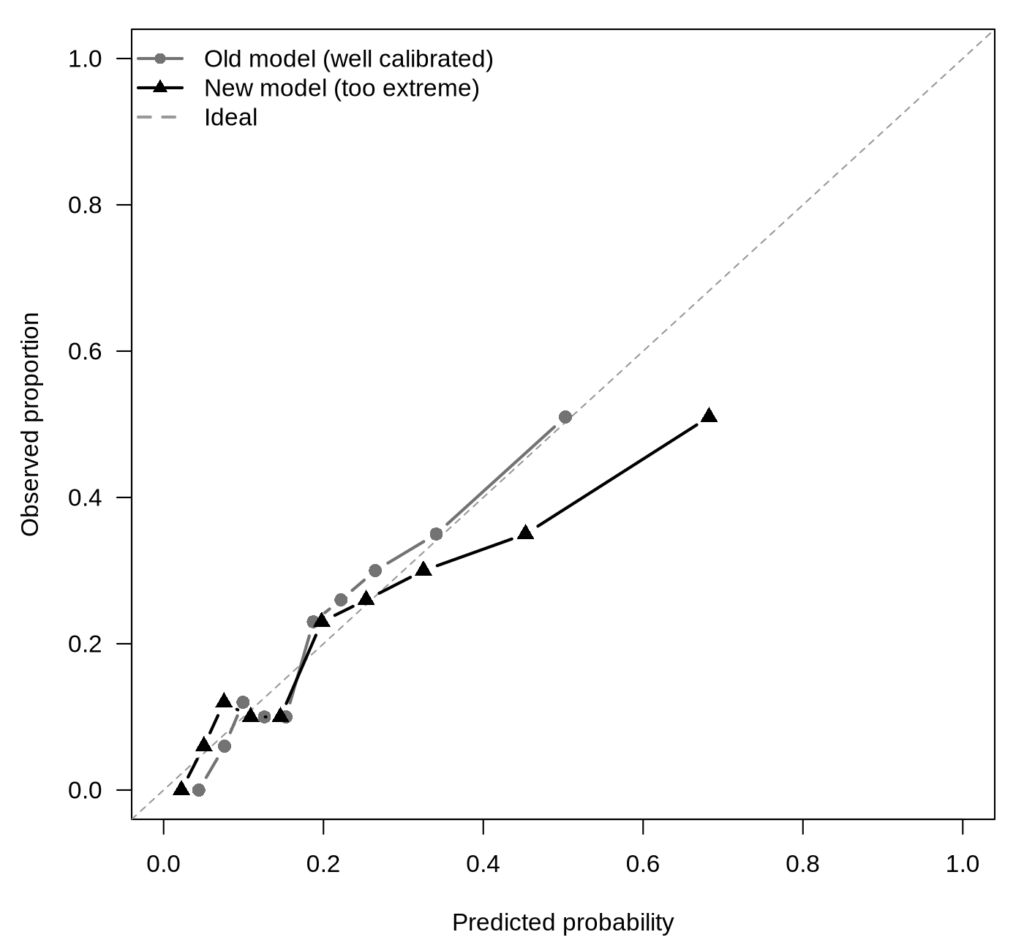
新モデルは、予測確率68%のグループで実際の発生割合が約50%しかない。それでも、このデータでは AUC は両モデルとも0.753で同じ、Brierスコアは0.140→0.144と新モデルのほうが悪いのに、IDIは0.058、Continuous NRIは0.767で、どちらもP<0.001の「有意な改善」になった。同じ設定を1000回くり返しても結果は変わらない。
| 指標(1000回くり返し) | 結果 |
|---|---|
| AUCの差 | すべて0(並び順が同じため) |
| Brierスコア(平均) | 0.143 → 0.148(新モデルのほうが悪い) |
| IDI | 平均0.053、1000回すべてでP<0.05 |
| NRI (Continuous) | 平均0.63、1000回すべてでP<0.05 |
| NRI (Categorical) | 平均0.082、76%でP<0.05 |
声を大きくしただけの話し手を「説得力が増した」と評価してしまうようなものである。NRI・IDIで比べる前に、両方のモデルの較正プロットを確認しておく必要がある(Hilden & Gerds 2014)。
実データでNRIとIDIを計算してみる
ダミーデータの例は「改善がない」場合だった。次は、本当に改善する場合を実データで見てみよう。Rに最初から入っている MASS パッケージの糖尿病データ(ピマ族の女性532人、うち糖尿病177人)で、年齢・BMI・妊娠回数のモデル1に、血糖値と糖尿病の家族歴スコアを足したモデル2を比べる。臨床予測モデルの性能比較の記事と同じデータ・同じモデルである。
R スクリプト例:
# install.packages("PredictABEL")
library(MASS)         # Pima データ(R に最初から入っている)
library(PredictABEL)  # reclassification()
library(pROC)         # AUC

pima <- rbind(Pima.tr, Pima.te)                 # 2つを合わせて532人
pima$diabetes <- as.integer(pima$type == "Yes")  # 糖尿病あり=1

# モデル1:年齢・BMI・妊娠回数/モデル2:モデル1+血糖値(glu)・家族歴スコア(ped)
m1 <- glm(diabetes ~ age + bmi + npreg, family = binomial, data = pima)
m2 <- glm(diabetes ~ age + bmi + npreg + glu + ped, family = binomial, data = pima)
pima$p1 <- fitted(m1)  # 予測確率
pima$p2 <- fitted(m2)

# 識別能(AUC)と、追加した2項目の尤度比検定
auc(pima$diabetes, pima$p1, quiet = TRUE)
auc(pima$diabetes, pima$p2, quiet = TRUE)
anova(m1, m2, test = "Chisq")

# 再分類表と NRI・IDI(区切りは記事の例と同じ 10%・30%)
dat <- pima[, c("diabetes", "p1", "p2")]
reclassification(data = dat, cOutcome = 1,
                 predrisk1 = dat$p1, predrisk2 = dat$p2,
                 cutoff = c(0, 0.1, 0.3, 1))

# NRI をイベント群と非イベント群に分けて見る
nri_parts <- function(y, p_old, p_new, cutoff) {
  c_old <- as.integer(cut(p_old, cutoff, include.lowest = TRUE, right = FALSE))
  c_new <- as.integer(cut(p_new, cutoff, include.lowest = TRUE, right = FALSE))
  up   <- c_new > c_old  # 上の区分へ移った
  down <- c_new < c_old  # 下の区分へ移った
  c(event    = mean(up[y == 1]) - mean(down[y == 1]),
    nonevent = mean(down[y == 0]) - mean(up[y == 0]))
}
round(nri_parts(dat$diabetes, dat$p1, dat$p2, c(0, 0.1, 0.3, 1)), 3)
round(nri_parts(dat$diabetes, dat$p1, dat$p2, c(0, 0.2, 1)), 3)  # 20%の1本で切った場合
実行結果:
> auc(pima$diabetes, pima$p1, quiet = TRUE)
Area under the curve: 0.7635
> auc(pima$diabetes, pima$p2, quiet = TRUE)
Area under the curve: 0.8606
> anova(m1, m2, test = "Chisq")
Analysis of Deviance Table

Model 1: diabetes ~ age + bmi + npreg
Model 2: diabetes ~ age + bmi + npreg + glu + ped
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       528     573.14
2       526     467.08  2   106.07 < 2.2e-16 ***

(reclassification() の出力)
 Outcome: absent

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)        48        10       0              17
    [0.1,0.3)      80        75      17              56
    [0.3,1]         8        49      68              46

 Outcome: present

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)         1         0       0               0
    [0.1,0.3)       2        21      23              54
    [0.3,1]         0        15     115              12

 Combined Data

             Updated Model
Initial Model [0,0.1) [0.1,0.3) [0.3,1]  % reclassified
    [0,0.1)        49        10       0              17
    [0.1,0.3)      82        96      40              56
    [0.3,1]         8        64     183              28
 _________________________________________

 NRI(Categorical) [95% CI]: 0.3438 [ 0.2497 - 0.4378 ] ; p-value: 0
 NRI(Continuous) [95% CI]: 0.815 [ 0.6487 - 0.9813 ] ; p-value: 0
 IDI [95% CI]: 0.1829 [ 0.146 - 0.2198 ] ; p-value: 0

> round(nri_parts(dat$diabetes, dat$p1, dat$p2, c(0, 0.1, 0.3, 1)), 3)
   event nonevent
   0.034    0.310
> round(nri_parts(dat$diabetes, dat$p1, dat$p2, c(0, 0.2, 1)), 3)  # 20%の1本で切った場合
   event nonevent
  -0.045    0.200
AUCは0.763から0.861に上がり、追加した2項目の尤度比検定もP<0.001である。NRI(Categorical)は0.344(95%信頼区間0.250〜0.438)、IDIは0.183(同0.146〜0.220)で、どちらもP<0.001だった。PredictABELは小さいP値を「0」と表示するが、0ではないので「P<0.001」と書く。
ここで、NRIをイベント発生群と非発生群に分けてみる。
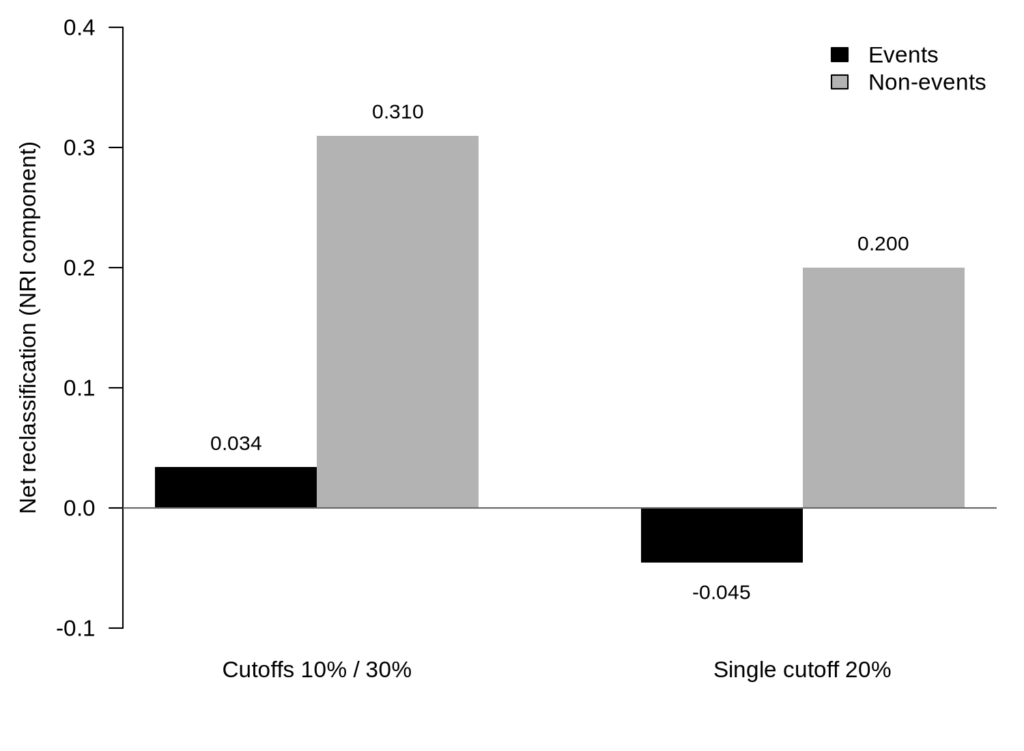
10%・30%で区切ると、イベント発生群は0.034、非発生群は0.310だった(合計0.344)。改善のほとんどは「糖尿病でない人をより低いリスク区分に移せた」ことによるもので、糖尿病の人をより高い区分に移す改善はわずかである。さらに、20%の1本で区切ると、イベント発生群のNRIは-0.045とマイナスになる。合計のNRIだけを見ていると、この中身には気づけない。
なお、この計算はモデルを作ったデータでそのまま評価しているので、性能は楽観的に出ている。実際の研究では、ブートストラップによる内的検証や外的検証で確かめ、較正プロットとDCAも合わせて示す。
まとめ
NRIとIDIは、AUCだけではわからない「新しいモデルで、どの患者の予測がどう変わったか」を表す指標である。NRIはリスクカテゴリーの再分類の改善を、IDIはイベント発生群と非発生群の予測確率の差の拡大を定量化する。新たなバイオマーカーを組み込んだモデルの評価や、既存の臨床予測モデルの改良効果を検証するとき、AUCを補う情報になる。
一方で、較正の悪いモデルでも値が大きく出ること、区分の切り方で値が変わること、合計のNRIは「患者の割合」ではないこと、入れ子のモデルの比較では追加項目の尤度比検定が基本であることに注意が要る。NRI・IDIは単独で使わず、AUC、較正プロット、意思決定曲線分析(DCA)と組み合わせて、モデルが本当に診療の役に立つかを判断したい。本記事が、臨床予測モデルの評価を深める一助となれば幸いである。
参考文献
- Pencina MJ, D’Agostino RB Sr, D’Agostino RB Jr, Vasan RS. Evaluating the added predictive ability of a new marker: from area under the ROC curve to reclassification and beyond. Stat Med. 2008;27(2):157-172.
- Pencina MJ, D’Agostino RB Sr, Steyerberg EW. Extensions of net reclassification improvement calculations to measure usefulness of new biomarkers. Stat Med. 2011;30(1):11-21.
- Leening MJG, Vedder MM, Witteman JCM, Pencina MJ, Steyerberg EW. Net reclassification improvement: computation, interpretation, and controversies: a literature review and clinician’s guide. Ann Intern Med. 2014;160(2):122-131.
- Kerr KF, Wang Z, Janes H, McClelland RL, Psaty BM, Pepe MS. Net reclassification indices for evaluating risk prediction instruments: a critical review. Epidemiology. 2014;25(1):114-121.
- Pepe MS, Kerr KF, Longton G, Wang Z. Testing for improvement in prediction model performance. Stat Med. 2013;32(9):1467-1482.
- Hilden J, Gerds TA. A note on the evaluation of novel biomarkers: do not rely on integrated discrimination improvement and net reclassification index. Stat Med. 2014;33(19):3405-3414.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384:e074819.

コメント
コメント一覧 (1件)
[…] なお、NRIとIDIは、厳密には識別能がどれだけ改善したかを測る指標で、DCAのように治療の損得を直接表すものではない。また、較正の悪いモデルでも値がよく出てしまうことがあるため、単独で使うことはすすめられていない(Kerr 2014、Hilden 2014)。詳しくはNRIとIDIの記事で解説している。 […]