臨床予測モデルは、医療現場で患者の将来を予測する強力なツールだ。特に血圧や血糖値のような連続データをアウトカムとするモデルは、病状の進行予測や治療効果の判定に役立つ。しかし、これらのモデルが実際に役立つためには、その予測能力が信頼できるものであることを確認する検証が不可欠だ。本記事では、連続アウトカムを扱う臨床予測モデルに焦点を当て、その内的検証と外的検証の重要性から具体的な方法、そしてその解釈までを詳しく解説する。
臨床予測モデルにおける内的検証と外的検証の概要
臨床予測モデルの検証は、開発されたモデルがどれほど正確に、そして汎用的に予測できるかを評価するプロセスだ。
内的検証は、モデルが開発された同じデータセット、あるいはそのサブセットを使ってモデルの性能を評価する。これは、モデルが学習データに過剰に適合していないか(過学習)、そして偶然の結果ではないかを確認するために行われる。内的検証によって、モデルの内部的な信頼性と安定性が保証される。
一方、外的検証は、モデル開発には一切使われていない独立した新しいデータセットを用いてモデルの性能を評価する。これは、モデルが開発された環境や特定の患者群だけでなく、異なる集団や状況においても同様の予測能力を発揮できるか、つまり汎用性があるかを確かめるために最も重要だ。外的検証をクリアして初めて、そのモデルの臨床応用への道が開かれる。
具体例で学ぶ内的検証と外的検証(Rを用いた計算例)
ここでは、患者の入院時の情報から退院時の HbA1c値(連続データ)を予測するモデルを例に、内的検証と外的検証の具体的な流れと評価指標を見ていこう。Rを用いたシミュレーションで解説する。
1. 必要なパッケージのインストールと読み込み
rmsパッケージを使用するため、まだインストールしていない場合は以下のコマンドでインストールしてほしい。
R スクリプト例:
# install.packages("rms")
# install.packages("ggplot2") # 可視化のため
library(rms)
library(ggplot2)
set.seed(123) # 再現性のためのシード設定
2. ダミーデータの生成
ここでは、架空の「病院A」と「病院B」のデータを生成する。
age: 年齢 (共変量1)bmi: BMI (共変量2)admission_glucose: 入院時血糖値 (共変量3)discharge_hba1c: 退院時HbA1c (アウトカム)
R スクリプト例:
# 病院Aのデータ(モデル開発用および内的検証用)
n_hospital_A <- 1000
hospital_A_data <- data.frame(
    age = round(rnorm(n_hospital_A, mean = 60, sd = 10)),
    bmi = round(rnorm(n_hospital_A, mean = 25, sd = 3), 1),
    admission_glucose = round(rnorm(n_hospital_A, mean = 150, sd = 30))
)
# 退院時HbA1cはage, bmi, admission_glucoseと乱数で生成
hospital_A_data$discharge_hba1c <- round(3.0 + 0.03 * hospital_A_data$age +
    0.05 * hospital_A_data$bmi +
    0.01 * hospital_A_data$admission_glucose +
    rnorm(n_hospital_A, mean = 0, sd = 0.8), 1)

# HbA1cは臨床上ありえそうな値範囲に調整
hospital_A_data$discharge_hba1c[hospital_A_data$discharge_hba1c < 4.0] <- 4.0
hospital_A_data$discharge_hba1c[hospital_A_data$discharge_hba1c > 12.0] <- 12.0


# 病院Bのデータ(外的検証用)
# 病院Aとは少し異なる特性を持つように平均値をわずかにずらす
set.seed(456) # 再現性のためのシード設定
n_hospital_B <- 300
hospital_B_data <- data.frame(
    age = round(rnorm(n_hospital_B, mean = 62, sd = 10)),
    bmi = round(rnorm(n_hospital_B, mean = 26, sd = 3), 1),
    admission_glucose = round(rnorm(n_hospital_B, mean = 160, sd = 30))
)

hospital_B_data$discharge_hba1c <- round(3.0 + 0.03 * hospital_B_data$age +
    0.05 * hospital_B_data$bmi +
    0.01 * hospital_B_data$admission_glucose +
    rnorm(n_hospital_B, mean = 0, sd = 0.8), 1)

hospital_B_data$discharge_hba1c[hospital_B_data$discharge_hba1c < 4.0] <- 4.0
hospital_B_data$discharge_hba1c[hospital_B_data$discharge_hba1c > 12.0] <- 12.0

# データの構造確認
str(hospital_A_data)
str(hospital_B_data)
3. モデル開発
rmsパッケージのdatadistとols関数を用いて線形回帰モデルを作成する。datadistは、データセットの変数分布に関する情報を設定し、後続のrms関数のヘルパーとして機能する。
R スクリプト例:
# モデル開発用のデータ(病院Aの全データを使用)
dd <- datadist(hospital_A_data)
options(datadist="dd")

# ols (Ordinary Least Squares) を用いて線形回帰モデルを開発
# 退院時HbA1cをage, bmi, admission_glucoseで予測
# validate() でブートストラップするには x = TRUE, y = TRUE が必要
model_hba1c <- ols(discharge_hba1c ~ age + bmi + admission_glucose, data=hospital_A_data, x = TRUE, y = TRUE)
print(model_hba1c)
validate() はブートストラップ標本でモデルを作り直すため、元のデータをモデルに持たせておく必要がある。そのため ols() に x = TRUE, y = TRUE を指定している。これを忘れると「must have specified x=T and y=T on original fit」というエラーになる。
4. 内的検証(rms::validate関数を用いたブートストラップ検証)
rms::validate関数は、ブートストラップリサンプリングを用いてモデルの性能を評価し、特に楽観的バイアスを補正した評価指標を提供する。これにより、モデルが学習データにどれだけ過学習しているかを定量的に把握できる。
R スクリプト例:
# validate関数を用いた内的検証
# B はブートストラップの繰り返し回数。実際の解析では500回以上(例: B=1000)を推奨
# 実行には少し時間がかかる場合がある。
set.seed(456) # validate関数の再現性のためのシード設定
validation_results_internal <- validate(model_hba1c, method="boot", B=500)
print(validation_results_internal)
実行結果:
          index.orig training   test optimism index.corrected   Lower  Upper   n
R-square      0.2643   0.2659 0.2613   0.0046          0.2597  0.2110 0.3060 500
MSE           0.6311   0.6295 0.6336  -0.0041          0.6352  0.5799 0.6917 500
g             0.5370   0.5381 0.5355   0.0026          0.5343  0.4697 0.5952 500
Intercept     0.0000   0.0000 0.0288  -0.0288          0.0288 -1.0474 0.9902 500
Slope         1.0000   1.0000 0.9960   0.0040          0.9960  0.8676 1.1374 500
※ rms のバージョン8以降では、補正済み指標の区間(Lower・Upper)の列も表示される。
ブートストラップの回数について、Collins ら(2024)は、楽観性は200回程度でもほぼ精確に推定できるとしつつ、少なくとも500回を推奨している。
内的検証結果の解釈:
ブートストラップ検証の結果に表示されている各指標の意味について説明する。
1. index.orig (Original Index)
- 意味: 元のデータセット全体でモデルを構築・評価した際の指標値
- 説明: 過学習の可能性がある「楽観的な」推定値。モデルが同じデータで構築され、同じデータで評価されているため、実際の性能よりも良く見積もられがち。
2. training (Training)
- 意味: 各ブートストラップサンプルでモデルを構築した際の指標値の平均
- 説明: ブートストラップサンプルでモデルを構築し、同じサンプルで評価した値の平均。これも過学習の影響を受けている。
3. test (Test)
- 意味: 各ブートストラップサンプルで構築したモデルを、元のデータセット全体で評価した際の指標値の平均
- 説明: より現実的な性能推定値。新しいデータでの性能をより正確に反映している。
4. optimism (Optimism)
- 意味: 楽観性バイアス(過学習の程度)
- 計算式:
training - test - 説明: この値が大きいほど、モデルが過学習していることを示す。理想的な値は0に近いことである。
5. index.corrected (Corrected Index)
- 意味: 楽観性バイアスを補正した指標値
- 計算式:
index.orig - optimism - 説明: 過学習の影響を取り除いた、より現実的なモデル性能の推定値。
結果の解釈例
R-square に関して
- index.orig: 0.2643 – 元のデータでの決定係数
- training: 0.2659 – ブートストラップサンプルでの平均決定係数
- test: 0.2613 – より現実的な性能推定
- optimism: 0.0046 – 楽観性バイアス(比較的小さい)
- index.corrected: 0.2597 – 補正後の決定係数
この場合、楽観性バイアス(0.0046)は比較的小さく、モデルの過学習は軽微であることが示されている。
Slope 行は、ブートストラップ標本で作ったモデルを元のデータに当てはめたときの較正の傾きである(理想は1)。0.996 とほぼ1で、予測が極端になる傾向(過学習)はほとんどない。1000人に対して説明変数が3つと少ないためである。もしこの値が0.8などと小さければ、係数をこの値で縮める(縮小係数として使う)ことも検討する。Intercept 行は、その傾きと組になる切片である。
5. 外的検証:予測精度とキャリブレーションの評価
外的検証では、開発に使用していない「病院B」のデータセットを用いてモデルの予測性能を評価する。ここでは、予測の正確さ(予測精度)と、予測値と実測値のずれ(キャリブレーション)の両面から評価する。
R スクリプト例:
# 病院Bのデータを用いて予測
predictions_external <- predict(model_hba1c, newdata = hospital_B_data)

# 実測値
actual_hba1c_external <- hospital_B_data$discharge_hba1c

### 予測精度 の評価 ###
# 1. RMSE (Root Mean Squared Error) の計算
rmse_external <- sqrt(mean((actual_hba1c_external - predictions_external)^2))
cat("\n--- 外的検証における予測精度の評価 ---\n")
cat("外的検証 RMSE:", rmse_external, "\n")

# 2. R2 (決定係数) の計算 - 外的検証用の修正版
# 外的検証では、予測値の平均ではなく実測値の平均を基準にする
# TSS (Total Sum of Squares) - 実測値の分散
tss_external <- sum((actual_hba1c_external - mean(actual_hba1c_external))^2)
# RSS (Residual Sum of Squares) - 予測誤差の二乗和
rss_external <- sum((actual_hba1c_external - predictions_external)^2)

# R²の計算
r_squared_external <- 1 - (rss_external / tss_external)
cat("外的検証 R2:", r_squared_external, "\n")

### キャリブレーション (Calibration) の評価 ###
# 1. Calibration-in-the-large の評価(予測値の平均と実測値の平均の比較。理想は差が0)
mean_predicted <- mean(predictions_external)
mean_actual <- mean(actual_hba1c_external)
cat("\n--- 外的検証におけるキャリブレーションの評価 ---\n")
cat("外的検証データにおける実測HbA1cの平均:", mean_actual, "\n")
cat("外的検証データにおける予測HbA1cの平均:", mean_predicted, "\n")
cat("平均の差 (実測 - 予測):", mean_actual - mean_predicted, "\n")
# 同じ患者の実測値と予測値のペアなので、検定するなら対応のあるt検定
t.test(actual_hba1c_external, predictions_external, paired = TRUE)

# 2. キャリブレーションの傾き(理想は1)
# 実測値を目的変数、予測値を説明変数とする線形回帰モデル
calibration_model_external <- lm(actual_hba1c_external ~ predictions_external)
summary(calibration_model_external) # ここのP値は「傾き=0」の検定である点に注意
confint(calibration_model_external) # 傾きの95%信頼区間が1を含むかを見る

# 「傾き=1」を直接検定する:予測値を offset() で引いておくと、
# predictions_external の係数が「傾き - 1」になる
calibration_slope_test <- lm(actual_hba1c_external ~ predictions_external +
                               offset(predictions_external))
summary(calibration_slope_test)

# 3. キャリブレーションプロット
plot_data_calibration <- data.frame(
    Actual = actual_hba1c_external,
    Predicted = predictions_external
)
ggplot(plot_data_calibration, aes(x = Predicted, y = Actual)) +
    geom_point(alpha = 0.5) +
    geom_abline(intercept = 0, slope = 1, linetype = "dashed", color = "red") +      # 理想線 (y = x)
    geom_smooth(method = "lm", formula = y ~ x, se = FALSE, color = "blue") +        # 較正の直線
    geom_smooth(method = "loess", formula = y ~ x, se = TRUE, color = "darkgreen") + # 柔軟な較正曲線
    labs(
        title = "外的検証: HbA1c キャリブレーションプロット (病院B)",
        x = "予測 HbA1c",
        y = "実測 HbA1c"
    ) +
    theme_minimal() +
    coord_equal(ratio = 1) # x軸とy軸のスケールを合わせる
実行結果:
> cat("\n--- 外的検証における予測精度の評価 ---\n")
--- 外的検証における予測精度の評価 ---
> cat("外的検証 RMSE:", rmse_external, "\n")
外的検証 RMSE: 0.7457927
> cat("外的検証 R2:", r_squared_external, "\n")
外的検証 R2: 0.2196644

> cat("\n--- 外的検証におけるキャリブレーションの評価 ---\n")
--- 外的検証におけるキャリブレーションの評価 ---
> cat("外的検証データにおける実測HbA1cの平均:", mean_actual, "\n")
外的検証データにおける実測HbA1cの平均: 7.861
> cat("外的検証データにおける予測HbA1cの平均:", mean_predicted, "\n")
外的検証データにおける予測HbA1cの平均: 7.789605
> cat("平均の差 (実測 - 予測):", mean_actual - mean_predicted, "\n")
平均の差 (実測 - 予測): 0.07139512

> cat("\n--- 外的検証におけるキャリブレーション回帰モデルの要約 ---\n")
--- 外的検証におけるキャリブレーション回帰モデルの要約 ---
> summary(calibration_model_external)

Call:
lm(formula = actual_hba1c_external ~ predictions_external)

Residuals:
     Min       1Q   Median       3Q      Max
-1.67026 -0.51287  0.00196  0.52809  2.24725

Coefficients:
                     Estimate Std. Error t value Pr(>|t|)
(Intercept)           1.15231    0.70667   1.631    0.104
predictions_external  0.86124    0.09055   9.511   <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.7419 on 298 degrees of freedom
Multiple R-squared:  0.2329,    Adjusted R-squared:  0.2303
F-statistic: 90.46 on 1 and 298 DF,  p-value: < 2.2e-16

>
Paired t-test
data: actual_hba1c_external and predictions_external
t = 1.663, df = 299, p-value = 0.09737
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
-0.01309247 0.15588272
sample estimates:
mean difference
0.07139512 2.5 % 97.5 %
(Intercept) -0.2383929 2.543008
predictions_external 0.6830320 1.039441Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 1.15231 0.70667 1.631 0.104
predictions_external -0.13876 0.09055 -1.532 0.126外的検証結果の解釈:
予測精度
- RMSE: 予測の平均的な誤差をアウトカムと同じ単位で示す。値が小さいほど予測精度が高いことを意味する。ただし、予測精度の良し悪しを判断する一般的な基準はない。
- R2: モデルがアウトカムの変動をどれだけ説明できているかを示す。1に近いほど説明力がある。
- 内的検証のR-square の
index.correctedと、外的検証のR2が大きく乖離しないことが重要だ。また、RMSEも同様に、両者で大きく異ならないことが望ましい(内部検証結果の MSE の index.corrected の平方根を計算する)。もし外的検証でこれらの指標が著しく悪化した場合、モデルの汎用性に問題がある可能性が高い。
内的検証の補正済み MSE(0.635)から求めた RMSE は約0.797、外的検証の RMSE は0.746で、病院Bでも誤差の大きさは悪化していない。一方、R² は0.260から0.220に下がった。R² は「その集団の実測値のばらつき」を分母にするため、誤差の大きさが同じでも、ばらつきの小さい集団では低く出る。RMSE と R² を両方見るのはこのためである。
キャリブレーション
- 外的検証データにおける実測HbA1cの平均と予測HbA1cの平均を比較する。これらの平均値が近いほど、モデル全体としての予測が偏っていないことを示す(約 0.07)
calibration_model_externalのsummary()出力で、切片 (Intercept) の推定値とP値に注目する。P値が0.05未満の場合、切片が0と有意に異なることを意味し、平均的に予測が過大評価または過小評価されていることを示唆する(Intercept = 1.15, P=0.104 なので、大きく予測が外れているわけでもない)
キャリブレーションプロット
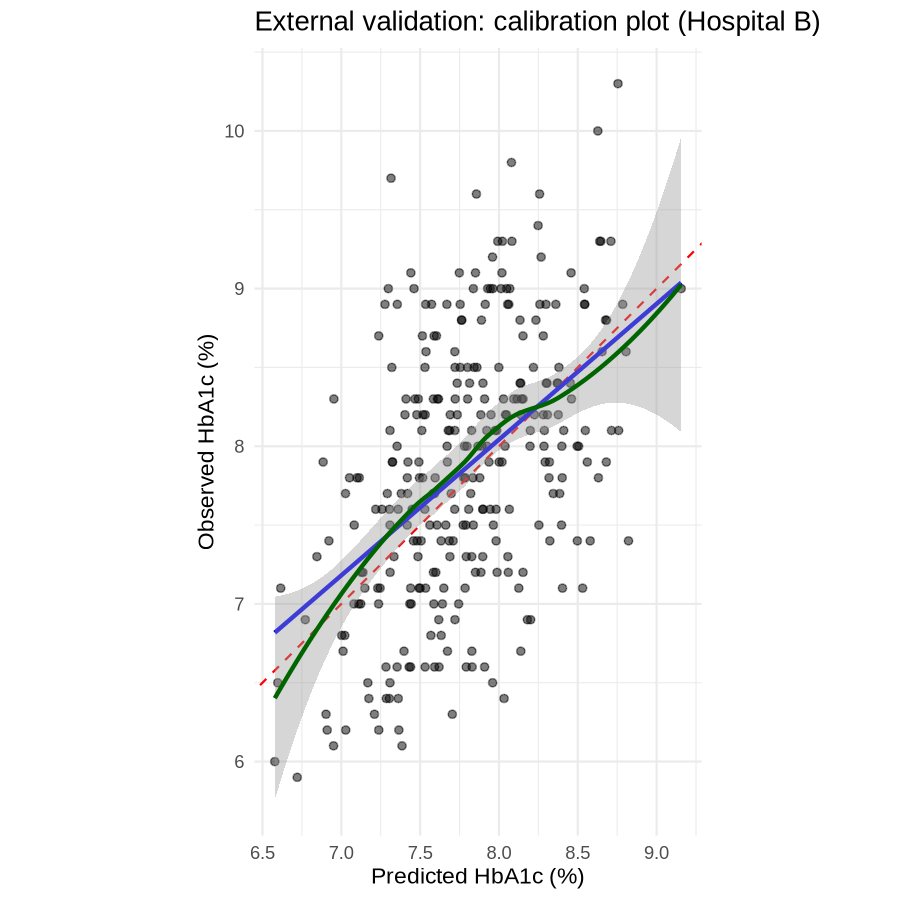
- 赤の破線 (y=x): 理想的なキャリブレーションを示す。予測値と実測値が完全に一致している状態。
- 青の実線 (回帰直線): モデルの実際のキャリブレーションを示す。この線が赤の破線にどれだけ近いかで、視覚的にキャリブレーションの良し悪しを判断できる。
- 緑の曲線: loess による柔軟な較正曲線で、直線を当てはめると見えにくい「一部の範囲だけずれている」パターンを見つけるのに役立つ。Van Calster ら(2019)は、較正を傾きなどの要約値だけでなく、このような柔軟な較正曲線で確かめることをすすめている。この例では、曲線は予測値7〜9%の大部分で理想線に沿っており、データの少ない両端で信頼帯が広がっている。
平均の差は0.071で、対応のある t 検定でも P = 0.097(95%信頼区間 −0.013〜0.156)であった。病院Bでの予測は、全体としてはほとんどずれていない(calibration-in-the-large は良好)。
キャリブレーション回帰の傾きは0.861で、理想の1より小さい。実測値を予測値に回帰したときに傾きが1未満になるのは、予測値の幅が実際より広い、つまり予測が極端すぎる状態である。高い人を高く見積もりすぎ、低い人を低く見積もりすぎている。開発データに合わせすぎた(過学習した)モデルでよく見られるパターンである。逆に、傾きが1より大きければ予測は控えめすぎる。暑い日は実際より暑く、寒い日は実際より寒く言いがちな天気予報士を思い浮かべるとわかりやすい。
ここで注意したいのは、summary() に表示される P 値(< 2e-16)は「傾き=0」の検定であり、「傾きが1と異なるか」には答えていない点である。傾きの95%信頼区間は0.683〜1.039で1を含み、offset() を使って傾き=1を直接検定しても P = 0.126 であった。この例では「点推定はやや極端寄りだが、明確な過学習の証拠はない」と解釈するのが妥当である。
なお、このシミュレーションでは病院Bのアウトカムも病院Aと同じ式で作っており、ずらしたのは年齢・BMI・入院時血糖の分布だけである。モデルの式そのものは正しいので、傾きが1からずれたのは主に300人という標本の偶然の揺れと考えられる。
また、傾きと同時に推定した切片1.15は「予測値が0のときの実測値」であり、平均的なずれを表すものではない。平均的なずれは、先に計算した平均の差で判断する。
総合的な判断
モデルが臨床現場で有用であるためには、予測精度が高く、かつキャリブレーションが良好であることが求められる。予測精度が高くてもキャリブレーションが悪ければ、個々の予測値が系統的にずれてしまい、臨床判断を誤る可能性がある。
この例では、rms::validateを使うことで、内的検証が単なるホールドアウト法よりも堅牢に行われ、ブートストラップによるバイアス補正が施された、より信頼性の高い内的性能指標が得られる。そして、独立したデータセットでの外的検証を行うことで、モデルの真の汎用性(予測精度とキャリブレーションの両面)が確認できる。
まとめ
臨床予測モデルは、その開発と同じくらい、あるいはそれ以上に検証プロセスが重要だ。特に連続アウトカムを扱うモデルでは、その予測の精度が患者の健康に直接影響を与えるため、慎重な評価が求められる。
内的検証は、モデルが過学習を起こしていないか、統計的に安定しているかを内部で確認するものであり、モデルの「基礎体力」を測るものだ。一方、外的検証は、モデルが開発された環境を超えて、様々な臨床現場でどれだけ通用するかを試すものであり、モデルの「実戦能力」を評価するものだ。
外的検証においては、予測の正確さを示す予測精度(RMSEやR2など)だけでなく、予測値と実測値がどれだけ一致しているかを示すキャリブレーション(平均値の比較やキャリブレーションプロットの切片・傾き)の評価も不可欠だ。これらの検証を通じて、モデルの限界を理解し、その信頼性を客観的に評価することが、臨床予測モデルを安全かつ有効に医療現場に導入するための不可欠なステップとなる。
参考文献
- Collins GS, Dhiman P, Ma J, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384:e074819. https://www.bmj.com/content/384/bmj-2023-074819
- Van Calster B, McLernon DJ, van Smeden M, Wynants L, Steyerberg EW. Calibration: the Achilles heel of predictive analytics. BMC Med. 2019;17:230. https://link.springer.com/article/10.1186/s12916-019-1466-7
- Steyerberg EW. Clinical Prediction Models: A Practical Approach to Development, Validation, and Updating. 2nd ed. Springer; 2019. https://link.amazon/B09PzD4GJ

コメント
コメント一覧 (1件)
[…] もう一つ大切なのは、どのデータで評価するかだ。モデルを作ったデータでそのまま計算したAUCや較正は、実際より良く見える(楽観性)。自分で作った問題を自分で解いて満点を取るようなものだ。7:3などにランダムに分けて評価するより、全員のデータでモデルを作り、ブートストラップで楽観性を補正する内的検証がすすめられている(Collins 2024)。さらに、別の施設や時期のデータで確かめる外的検証ができれば理想的だ。複数のモデルを比べるときは、同じデータ・同じ検証方法にそろえて評価する。具体的な手順は連続アウトカムの臨床予測モデルの内的検証・外的検証の記事でも紹介している。 […]