研究計画を立てる際、避けて通れないのが目標症例数(サンプルサイズ)の決定である。特に、同一被験者を複数回測定する「縦断データ」や「反復測定データ」の場合、データの相関を考慮する必要があり、計算は一気に複雑化する。
本記事では、従来の数式による計算が困難な「線形混合モデル」において、R言語のシミュレーションを用いて論理的にサンプルサイズを導き出す手法を解説する。
線形混合モデルとは
線形混合モデル(Linear Mixed Model: LMM)とは、解析モデルの中に「固定効果」と「変量効果」を同時に組み込んだモデルのことである。
- 固定効果: 薬剤の種類や経過時間など、研究者が直接的に差を検証したい主たる要因である。
- 変量効果: 被験者ごとの個体差(ベースラインの高さや反応性の違い)など、データのバラツキとして処理すべき要因である。
縦断データでは「同一人物から得られたデータ同士は似通っている(独立していない)」という性質がある。このデータの依存関係を適切に処理できるのが、混合モデルの最大の特徴である。
サンプルサイズ計算が必要な局面
特に重要となるのが、小規模な研究で「有意差なし」という結果に終わった仮説を再検証する場合である。
有意差が出なかった原因が「本当に薬に効果がない」ためなのか、あるいは「サンプルサイズ不足による検出力(Power)の欠如」によるものなのかは、事前の計算なしには判別できない。特に治療効果の「変化の傾向(傾き)」の差を検出したい場合、単純な2群比較よりも多くの人数を要することが多いため、綿密な設計が不可欠である。
シミュレーションで行うべき理由
なぜ、一般的な統計ソフトの数式入力では不十分なのだろうか。
- モデルの複雑性: 混合モデルには個体間・個体内の分散パラメータが多数存在し、単純な数式(t検定など)ではその構造を表現しきれない。
- 非定型な測定点: 今回の例のように「0, 1, 3, 6ヶ月」といった不等間隔の測定スケジュールであっても、シミュレーションなら実態に即して柔軟に計算できる。
- 現実的な条件の反映: 将来的に予測される脱落パターンの組み込みなど、実務に即したカスタマイズが可能である。
Rでの実践例:simrパッケージの活用
Rの simr パッケージを用いれば、構築したモデルをベースにモンテカルロ・シミュレーションを回し、検出力を算出できる。以下に、4時点での比較を想定したコードの骨格を示す。
1. モデル構造の定義
まず、ダミーデータを用いて「解析したいモデルの形」をRに教える。
# パッケージの準備(未インストールの場合のみインストール)
pkgs <- c("lme4", "simr", "lmerTest")
for (p in pkgs) if (!requireNamespace(p, quietly = TRUE)) install.packages(p)
library(lme4)
library(simr)

# 10人分のダミーデータ(0, 1, 3, 6ヶ月)
dat <- expand.grid(time = c(0, 1, 3, 6), id = factor(1:10))
dat$group <- factor(rep(c("Old", "New"), each = 20),
                    levels = c("Old", "New"))  # 従来薬(Old)を基準群にする
set.seed(123)
# モデルの「型」を作るための仮の値(数値は手順2ですべて上書きされる)
dat$score <- rnorm(10, sd = 0.8)[dat$id] + rnorm(nrow(dat), sd = 1.2)

model <- lmer(score ~ time * group + (1 | id), data = dat)
factor() の水準はアルファベット順に並ぶため、何も指定しないと New(新薬)が基準群になってしまう。ここでは levels で従来薬(Old)を先頭にし、「従来薬と比べて新薬の傾きがどれだけ違うか」を交互作用 time:groupNew で表せるようにしている。
2. パラメータ(効果量とばらつき)の設定
ここが最も重要なステップである。先行研究などを参考に、「最低限これくらいの差は検出したい」という数値をモデルに注入する。すでにデータがある場合は、そのデータに合わせて設定するのがよい。
# 固定効果(係数)の設定
# 6ヶ月時点で新薬が従来薬より「1.2」スコアが改善すると仮定(傾きの差 = 1.2/6 = 0.2)
fixef(model) <- c(
  "(Intercept)"   = 10,    # ベースラインの平均点(従来薬群)
  "time"          = -0.1,  # 従来薬の自然な変化(1ヶ月あたり)
  "groupNew"      = 0,     # 開始時点の群間差
  "time:groupNew" = 0.2    # 【重要】検出したい「傾きの差」
)
# 誤差(ばらつき)の設定
sigma(model) <- 1.2                 # 残差SD(個体内の変動)
VarCorr(model) <- list(id = 0.8^2)  # 個体差(ランダム切片の分散 = SD 0.8 の2乗)
3. サンプルサイズの拡張と試行
人数を増やしながら、80%の検出力を超えるポイントを探る。
# 両群合計100人まで拡張し、20〜100人を10人刻みで評価する
model_ext <- extend(model, along = "id", n = 100)

set.seed(2026)
pc <- powerCurve(model_ext,
                 test   = fixed("time:groupNew", "t"),  # Satterthwaite 近似の t 検定(lmerTest を利用)
                 along  = "id",
                 breaks = seq(20, 100, by = 10),
                 nsim   = 100)   # 試し実行は 100 程度、最終判断は 1000 以上を推奨
print(pc)
plot(pc)

# simr のシミュレーション後に作られる offset と weights を削除しておく
rm(list = intersect(c("offset", "weights"), ls()))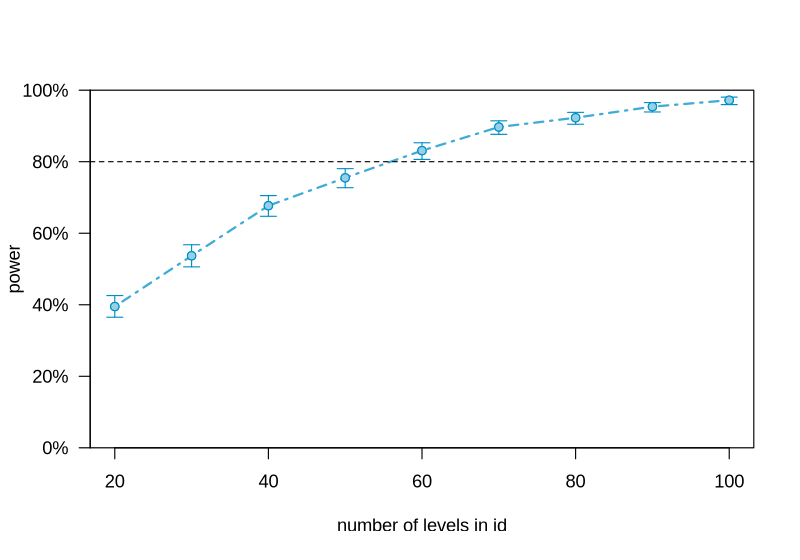
breaks を指定しないと、最小の点が「3人」になる。今回のダミーデータでは1〜5番目の id がすべて従来薬群なので、3人では片方の群しか存在せず、交互作用を推定できない(100回すべてエラーになる)。10人刻みにしておけば、どの点でも両群が 1:1 に保たれる。
※コラム:simr を回すと
offsetとweightsが現れるpowerSim()やpowerCurve()を実行すると、グローバル環境にoffsetとweightsというオブジェクトが作られる。これは R 本体のstats::offset()・stats::weights()と同じ名前で、いわば「本物の道具箱の横に、同じラベルの空き箱が置かれた」状態である。直ちにエラーになるわけではないが、後でweightsを引数に使う解析をしたときに取り違えの原因になりうる。シミュレーションが終わったらrm()で片付けておくと安心である。同じ理由で、データフレーム名にdf(F分布の密度関数と同名)を使うのも避けたい。
結果の解釈
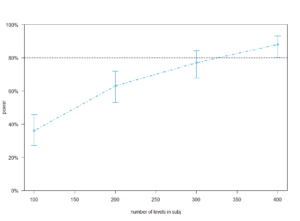
シミュレーションを実行すると、サンプルサイズ(横軸)と検出力(縦軸)の関係を示す「パワーカーブ」が得られる。
- 青い点(点推定値): 各サンプルサイズにおけるシミュレーション上の平均的な検出力である。
- エラーバー(95%信頼区間): 試行回数に基づく推定の幅である。
横軸の「number of levels in id」は id の数、つまり両群を合わせた人数である。
実務的には、「信頼区間の下限が目標とする検出力(一般に80%)を安定して上回るポイント」を必要サンプルサイズとして採用するのが、最も堅実な判断である。上記の設定で nsim = 1000 として実行すると、下限が80%を初めて超えるのは両群合計60人(検出力83.1%、95%信頼区間 80.6〜85.4%)だが、ぎりぎりである。余裕をもって上回る両群合計70人(各群35人、検出力89.7%、95%信頼区間 87.7〜91.5%)を採用するのが安全である。なお、nsim = 100 のままでは信頼区間が広く、実行のたびに結論が揺れやすい。目安をつかむ段階では100回、最終決定の前には1000回以上で確認するとよい。
ドロップアウトを考慮した実務的な判断
シミュレーションで算出された $n$ は、解析対象となる「有効データ数」であることに注意が必要である。
実際の臨床研究では必ず脱落(ドロップアウト)が発生するため、以下の計算で最終的な募集人数を決定する。
- 予測脱落率の算出: 先行研究に基づき、最終測定時点での脱落率を予測する(例:20%)。
- 目標募集人数の設定:
必要サンプルサイズ ÷ (1 - 脱落率)。- 例:計算上の必要数が70人の場合、$70 \div 0.8 = 87.5$。よって、90人程度をリクルートするのが妥当である。
なお、線形混合モデルは途中で脱落した人のデータも、そこまでの測定値を解析に使える。そのため「÷(1 − 脱落率)」は安全側(多め)の見積もりになる。より厳密に見積もりたい場合は、脱落パターンを組み込んだデータでシミュレーションするとよい。
論文でそのまま使える英文テンプレート
以下の数値は本記事の設定例である。実際の研究の想定値と、手元で実行した結果に置き換えて使ってほしい。
Methods(Sample size)
The sample size was determined by simulation-based power analysis using the simr package (version 1.0.11) in R (version 4.5). We assumed a linear mixed-effects model with fixed effects of time, treatment group, and their interaction, and a random intercept for participants, with outcome assessments at baseline and 1, 3, and 6 months. Based on previous studies, we assumed a difference in the rate of change between groups of 0.2 points per month (corresponding to a 1.2-point difference at 6 months), a between-participant standard deviation of 0.8, and a residual standard deviation of 1.2. The group-by-time interaction was tested using a t-test with Satterthwaite’s approximation for degrees of freedom at a two-sided significance level of 0.05. Based on 1,000 simulations, a total of 70 participants (35 per group) was required to achieve at least 80% power, where the lower limit of the 95% confidence interval for the estimated power exceeded 80%. Allowing for an anticipated dropout rate of 20%, we planned to enroll 90 participants (45 per group).
和訳
サンプルサイズは、R(version 4.5)の simr パッケージ(version 1.0.11)を用いたシミュレーションによる検出力分析で決定した。時間・治療群・その交互作用を固定効果、参加者のランダム切片を変量効果とする線形混合モデルを想定し、評価時点はベースライン、1、3、6ヶ月とした。先行研究に基づき、群間の変化速度の差を 1ヶ月あたり 0.2点(6ヶ月時点で 1.2点の差に相当)、参加者間の標準偏差を 0.8、残差標準偏差を 1.2 と仮定した。群×時間の交互作用は、Satterthwaite 近似による自由度を用いた t 検定(両側有意水準 0.05)で検定した。1,000回のシミュレーションの結果、推定検出力の 95%信頼区間の下限が 80% を上回る人数は合計 70 人(各群 35 人)であった。20% の脱落を見込み、登録目標数を 90 人(各群 45 人)とした。
まとめ
線形混合モデルのサンプルサイズ計算において、シミュレーションは極めて強力な武器となる。
- simr 等のツールを活用し、実態に即したデータ構造で試行すること。
- 単なる平均値の差ではなく、「時間の経過に伴う群間差(相互作用)」をターゲットに据えること。
- パワーカーブのエラーバーの下限を確認し、余裕を持った計画を立てること。
論理的な裏付けに基づくサンプルサイズ設計こそが、研究の価値を決定づける重要なプロセスである。
一括コピペ用Rスクリプト
# ============================================================
# 線形混合モデルのサンプルサイズ計算(simr によるシミュレーション)
# 一括コピペ用スクリプト
# ============================================================

# パッケージの準備(未インストールの場合のみインストール)
pkgs <- c("lme4", "simr", "lmerTest")
for (p in pkgs) if (!requireNamespace(p, quietly = TRUE)) install.packages(p)
library(lme4)
library(simr)

# 1. モデル構造の定義 ------------------------------------------
# 10人分のダミーデータ(0, 1, 3, 6ヶ月)
# ※ データ名を df にすると stats::df()(F分布の密度関数)と名前が衝突するため dat とする
dat <- expand.grid(time = c(0, 1, 3, 6), id = factor(1:10))
dat$group <- factor(rep(c("Old", "New"), each = 20),
                    levels = c("Old", "New"))  # 従来薬(Old)を基準群にする
set.seed(123)
# モデルの「型」を作るための仮の値(数値は手順2ですべて上書きされる)
dat$score <- rnorm(10, sd = 0.8)[dat$id] + rnorm(nrow(dat), sd = 1.2)

model <- lmer(score ~ time * group + (1 | id), data = dat)

# 2. パラメータ(効果量とばらつき)の設定 ----------------------
# 6ヶ月時点で新薬が従来薬より「1.2」スコアが改善すると仮定(傾きの差 = 1.2/6 = 0.2)
fixef(model) <- c(
  "(Intercept)"   = 10,    # ベースラインの平均点(従来薬群)
  "time"          = -0.1,  # 従来薬の自然な変化(1ヶ月あたり)
  "groupNew"      = 0,     # 開始時点の群間差
  "time:groupNew" = 0.2    # 【重要】検出したい「傾きの差」
)
sigma(model) <- 1.2                 # 残差SD(個体内の変動)
VarCorr(model) <- list(id = 0.8^2)  # 個体差(ランダム切片の分散 = SD 0.8 の2乗)

# 3. サンプルサイズの拡張と試行 --------------------------------
# 両群合計100人まで拡張し、20〜100人を10人刻みで評価する
model_ext <- extend(model, along = "id", n = 100)

set.seed(2026)
pc <- powerCurve(model_ext,
                 test   = fixed("time:groupNew", "t"),  # Satterthwaite 近似の t 検定(lmerTest を利用)
                 along  = "id",
                 breaks = seq(20, 100, by = 10),
                 nsim   = 1000)   # 試し実行は 100 程度、最終判断は 1000 以上を推奨。nsim = 1000 で実行時間は数分程度
print(pc)
plot(pc)

# 4. 後片付け --------------------------------------------------
# simr のシミュレーション後、グローバル環境に offset と weights という
# オブジェクトが作られ、stats::offset() / stats::weights() と名前が衝突する。
# 以降の解析に影響しないよう削除しておく
rm(list = intersect(c("offset", "weights"), ls()))
参考文献
- Green P, MacLeod CJ. SIMR: an R package for power analysis of generalized linear mixed models by simulation. Methods in Ecology and Evolution. 2016;7(4):493–498. https://doi.org/10.1111/2041-210X.12504
- Kumle L, Võ ML-H, Draschkow D. Estimating power in (generalized) linear mixed models: An open introduction and tutorial in R. Behavior Research Methods. 2021;53(6):2528–2543. https://pmc.ncbi.nlm.nih.gov/articles/PMC8613146/
おすすめ書籍
誰も教えてくれなかった 医療統計の使い分け〜迷いやすい解析手法の選び方が,Rで実感しながらわかる!

コメント