後輩:「先輩、うちの病院で2年前に始めた手指衛生キャンペーンの効果を調べたいんです。月ごとの院内感染率のデータが、キャンペーンの前後2年ずつ、48か月分あります」
先輩:「前回の記事で解説した 分割時系列解析(ITS) が使えそうだね。介入前のトレンドを延長して、実際の値と比べる方法だ」
後輩:「はい、やってみたら感染率がガクッと下がっていました。でも、ちょうど同じ時期に、国から感染対策の強化を求める通知が出ていたんです。下がったのはキャンペーンのおかげなのか、通知のおかげなのか……」
先輩:「そこが1群だけのITSの弱点なんだ。同じ時期に起きた別の出来事と、介入の効果を区別できない。でも、キャンペーンをしていない 比較病院 の同じ期間のデータがあれば話は変わる。通知の影響は比較病院にも同じように出るはずだから、その分を差し引けばいい」
後輩:「比較病院のデータなら、地域の感染対策ネットワークで共有されています!」
先輩:「それなら Comparative Interrupted Time Series(CITS、比較分割時系列解析) の出番だね」
CITSをひとことで言えば、「ITS+比較対照群」 である。介入を受けた集団の時系列と、受けていない集団の時系列を並べて比べることで、同じ時期に起きた別の出来事(共介入)の影響を差し引いて、介入そのものの効果に迫ることができる。
ITSの基本は、前回の記事で解説している。まだ読んでいない人は、先にこちらを読むとCITSが理解しやすい。
👉 介入の前後比較は危ない|時系列データの効果検証は分割時系列解析(ITS)で
この記事でわかること
- CITSはどんな場面で使うのが良いか、統制群(比較対照群)はどう選ぶか
- CITSの3つのモデル(Baseline Mean/Linear-Trend/Nonlinear-Trend)の違いと使い分け
- RでCITSを実行する方法と、1群だけのITSで分析すると効果をどう誤るか
数式が苦手な人は、先に「RでCITSを実行してみる」の章でグラフと結果を眺めてから、理論の章に戻ってくるのもおすすめである。
CITSの前にITS
現実世界の状況として、集団全部に介入するということが起き、時系列データだけがあり、そのデータを分析せざるを得ないことはある。
そのような大規模介入の例として、集団ベースの健康介入、メディアキャンペーン、専門家のガイドラインの周知、あるいは、新たな法律や税制を導入して実施される公衆衛生政策の変更などがある。
このような1群しかない場合に、介入前後を比較する方法として Interrupted Time Series (ITS) がある。
ある時間間隔で目的変数が測定されているとして、独立変数は、調査開始からの年、介入前か後か、年数と介入の交互作用項の3つからなる、重回帰モデルで解析する。
ランダム化で比較していないが、介入前後の複数回のデータがある場合に取りうる、介入効果を推定する方法の一つと言える。
※コラム:交互作用項とは
交互作用項とは、2つの変数を 掛け算 した項のことである。ITSの「年数×介入」の項は、介入前は0、介入後だけ年数の値をとる。そのため、この項の係数は「介入後に、傾きがどれだけ変わったか」を表す。
たとえるなら、坂道を歩いている途中で道の勾配が変わる地点があり、その「勾配の変わり具合」を測るための専用の物差しが交互作用項である。CITSでも「介入後×処置群」「時間×処置群」のように、交互作用項が主役になる。
CITSはどんなときに使うのが良いか?
CITSは、ITSに比較対照となる統制群がおける場合の解析方法だ。
この方法を選択する場面は、以下のような状況が適している。
- RCTを実施するのが現実的でない。
- 処置(治療や介入)が集団レベルで施される(クラスタと言うとわかりやすいかもしれない)。
- 複数時点のデータを所持している。
- 処置以外は類似の複数群である。
- 処置としては同じ履歴とinstrumentation threatsを持つ(Instrumentation threats: 測定にまつわる脅威。測定方法論的問題点であり、内的整合性の脅威としてinstrumentationの違いや適切性が論じられている)。
- 処置群(実験群、介入群と同じ意味合い)と統制群(コントロール群、比較対照群と同じ意味合い)ともに一貫したデータ測定がなされている。
※コラム:Instrumentation threats(測定にまつわる脅威)とは
Instrumentation threats とは、測定の「物差し」が途中で変わる ことで、本当は変化していないのに変化したように見えてしまう危険のことである。院内感染で言えば、サーベイランスの判定基準の変更、検査件数の増加、担当者の交代などが当てはまる。
CITSでは、この物差しの変化が処置群と統制群に 同じように 起きていれば、比較することで打ち消し合う。逆に、処置群だけで物差しが変わると、それが介入の効果に紛れ込んでしまう。「処置としては同じ履歴とinstrumentation threatsを持つ」という条件は、このことを指している。
※コラム:クラスタとは
クラスタとは、病院、病棟、学校、市町村のような 人の「まとまり」 のことである。手指衛生キャンペーンのように、患者一人ひとりではなく病院全体に介入するとき、介入の単位はクラスタになる。
同じクラスタに属する人のデータは互いに似やすい(同じ病院の患者は、同じ医療スタッフ・同じ設備のもとにいる)。そのため、クラスタ単位の介入では、一人ひとりを独立に扱う分析では誤差を小さく見積もりすぎることがある点に注意が必要である。
グラフに示すとこんな感じのデータだ。
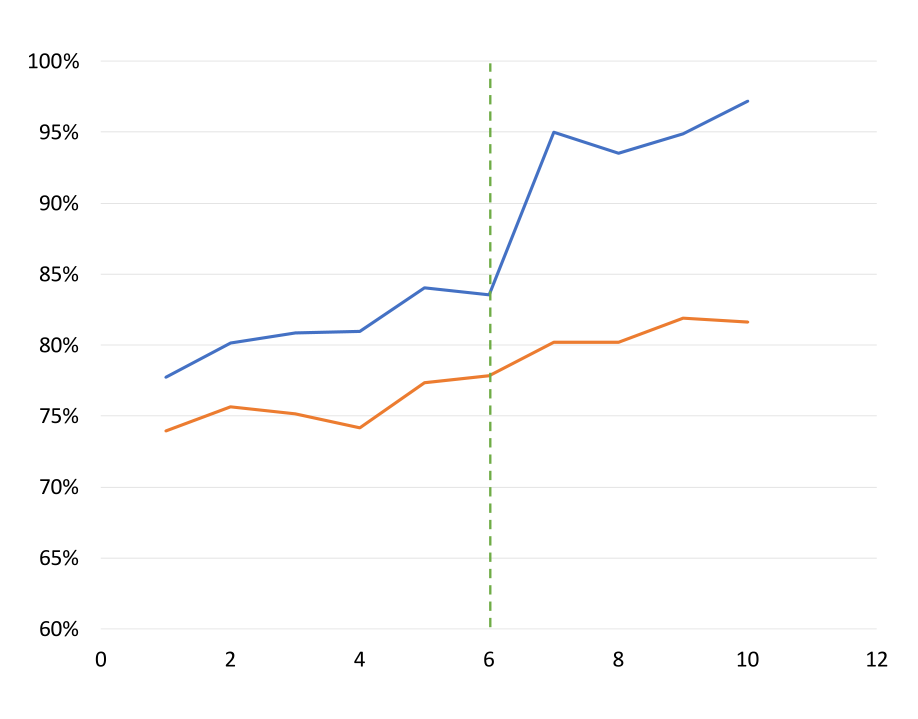
出典:https://cteresearchnetwork.org/sites/default/files/2020-11/CTERN-STI20-CITS-508.pdf 3ページ目
切片、傾き、介入のときの大きな変化などをイメージで表すと以下のようなグラフになる。
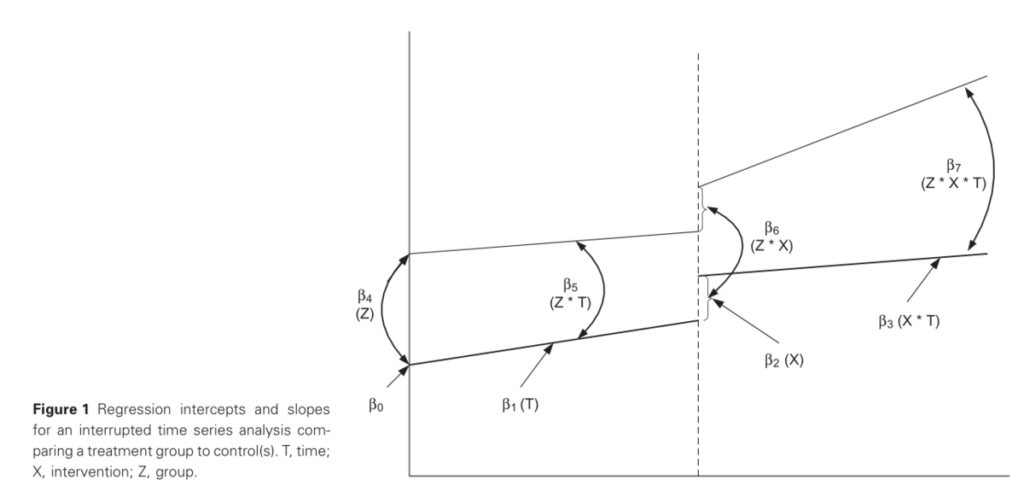
出典:http://lindenconsulting.org/documents/Weighted_TSA_Article.pdf Figure 1
ただし、ここで使っている変数名と以下で登場する変数名は異なるため、あくまでイメージとして見てほしい。
CITSはどんなときに適用できるか?
CITSが適用できる条件をまとめると以下のようになる。
- 複数時点の測定データがある。
- 処置群と統制群の両方の背景データがある。
- 介入前に少なくとも2時点分の測定値がある。
- より柔軟なモデルを用いるには、介入前のデータが少なくとも3時点分必要になる。
※コラム:介入前の時点数はいくつあればよいか
上の「少なくとも2時点」「3時点」は、モデルの式が計算できるための 最低限 の目安である。直線を引くには2点あれば足りるが、2点だけでは、その直線が本当の傾向なのか、たまたまの揺らぎなのかを見分けられない。
Somersら(2013)は、介入前のトレンドを推定するCITSには、介入前に少なくとも4時点のデータが必要だとしている。介入前の時点が多いほど傾きの推定は安定するので、データを集める段階で、できるだけ介入前の期間を長く確保しておくとよい。後半のRの例では、介入前に24か月分のデータを使っている。
CITSの統制群はどのように選択するのか?
それでは、CITSの統制群をどのように選んだらよいのか?
よく用いられている方法は、次の 5 つである。
- 処置を受けていない利用可能なすべての集団(Using All Available Nontreatment Samples)
- 介入前の背景でマッチングして選択する(Matching)
- 観察可能な特徴についてマッチする(Focal Selection)
- 処置群と地理的に近い集団(Local)
- FocalとLocalのミックス(Hybrid)
Hybridマッチングがバイアスを抑制するというエビデンスがある一方、他の方法それぞれはエビデンスがない。
※コラム:共介入(同じ時期に起きた別の出来事)と、統制群が効く理由
介入とほぼ同じ時期に起きた別の出来事を 共介入(co-intervention) と呼ぶ。冒頭の例では、国からの通知がこれに当たる。1群だけのITSでは、介入と共介入の効果を区別できない。
統制群は、いわば 「天気の影響を測るための隣の畑」 である。肥料(介入)を撒いた畑の収穫が増えても、その年が豊作の天候だったなら、肥料のおかげとは言い切れない。肥料を撒いていない隣の畑も同じだけ増えていれば、それは天候(共介入)の影響だとわかる。
ただし、この差し引きが成り立つのは、共介入の影響が 処置群と統制群に同じくらい及ぶ 場合である。隣の畑だけ日当たりが悪ければ、天気の恵みの受け方が違ってしまう。統制群を選ぶときは、共介入の影響の受け方も似ているかを考えておきたい。
Lopez Bernalら(2018)は、ITSに対照系列を加えることで、こうした共介入などによる偏りに対処できることを整理している。また St.Clairら(2014)は、CITSの推定値をランダム化比較試験(RCT)の結果と突き合わせ、介入前の測定値と背景の特徴の両方で比較群を選ぶ と、RCTの結果に近づいたことを報告している。統制群の選び方が結果を左右する、ということである。
CITSにおける処置効果の推定:Baseline Mean Model
CITSの推定値を回帰分析で求める。
モデル式は以下の通り。
$$ Y = \beta_0 + \beta_1 Z + \beta_2 Post + \beta_3 T + \beta_4 (Post \times T) + v + u $$
ここで、Zは各群の特徴セット、Postは介入後かどうかの変数、Tは処置群かどうか、vは群内誤差、uは平均ゼロの誤差。
わかりやすさ優先のために添え字はほぼ削除している。
式はイメージをつかむ目的にのみ登場させている。
興味のあるパラメータは$ \beta_4 $ ということになる。
※コラム:差分の差分法(Difference-in-Differences、DiD)との関係
Baseline Mean Modelは、経済学や政策評価でよく使われる 差分の差分法(DiD) と同じ考え方である。①処置群の「介入後の平均 − 介入前の平均」、②統制群の「介入後の平均 − 介入前の平均」を求め、③その差(①−②)を介入の効果とみなす。差を2回とるので「差分の差分」と呼ぶ。
Somersら(2013)は、DiDが介入前の 平均 の群間差だけを調整するのに対し、CITSは介入前の 平均とトレンド(傾き)の両方 の群間差を調整できる点で、より厳密な方法だと整理している。後半のRの例では、この違いが推定値にどう表れるかを実際に確かめる。
CITSにおける処置効果の推定:Baseline Linear-Trend Model
このモデルは、前述のBaseline Mean Modelの拡張版で、時間 Time そのものを線形で投入している。
$$ Y = \beta_0 + \beta_1 Time + \beta_2 Z + \beta_3 Post + \beta_4 T + \beta_5 (Time \times T) + \beta_6 (Post \times T) + v + u $$
介入 Post と 処置 T の交互作用項に加えて、時間 Time と 処置 T の交互作用も投入している。
$\beta_1 $ が統制群の処置前の傾きになり、$ \beta_5 $ が処置群と統制群の傾きの差になる(処置群の傾きは $\beta_1 + \beta_5 $で表される。
$ \beta_6 $ が処置の効果になる。
CITSにおける処置効果の推定:Baseline Nonlinear-Trend Model
これは上述のLinear-Trend Modelを非線形に拡張したモデルである。
モデル式は以下のようになる。
$$ Y = \sum{\beta Time} + \beta_{Post T} Post \times T + \sum{\beta S} + u $$
ここで、Sは処置群・統制群の群を指定している。これまでは T として処置群と統制群のみを区別していたが、処置群・統制群に含まれるクラスタ(例:学校)を指定している。
$ \beta_{Post T} $ が求めたい処置の効果になる。
この推定のために、より多くの介入前のデータが必要となるが、いくつあればよいかは決まっていない。
CITSにおける処置効果推定モデルの使い分け
それぞれのモデルはどんなときに使うのが良いか?
Baseline Mean Modelは、介入前のデータが変動なく平坦で、処置群と統制群が平行の場合に適切である。
Baseline Linear-Trend Modelは、介入前のデータにおいて処置群と統制群間で傾きが異なる場合が適切である。
Baseline Nonlinear-Trend Modelは、パターンが明らかでなく、解釈が難しい場合に適切である。
いずれの場合も、線形回帰モデルで解析すればよい。
※コラム:自己相関とは
時系列データでは、ある月の値が前の月の値に似る傾向がある。これを 自己相関 と呼ぶ。「昨日が雨なら今日も雨になりやすい」のと同じで、感染対策の状況や患者層は1か月で急に入れ替わらないため、今月の感染率は先月の感染率の影響を引きずる。
通常の線形回帰は「データ一つひとつが互いに独立」と仮定しているため、自己相関を無視すると、標準誤差を小さく見積もり、信頼区間が狭すぎたりP値が小さすぎたりする。線形回帰でモデルを組むこと自体はよいが、自己相関には別途対処しておきたい。具体的な方法は、次の章のStep 6で示す。
RでCITSを実行してみる:手指衛生キャンペーンの例
ここからは、冒頭の後輩の状況を模した疑似データで、CITSをRで実行してみる。使うパッケージは次の2つである。
ggplot2:グラフを描くnlme:gls()で、自己相関を考慮した回帰を行う
モデルの当てはめ自体は、Rに最初から入っている lm() だけでできる。以下の結果は、R 4.6.1 で実際に実行して確認したものである。乱数を使うため、set.seed() の値やRのバージョンが違うと数値は変わる。
Step 0:パッケージの準備
# install.packages(c("ggplot2", "nlme"))
library(ggplot2)
library(nlme)
Step 1:疑似データを作る
介入病院と比較病院の2病院について、月ごとの院内感染率(1,000患者日あたりの感染件数)を48か月分作る。25か月目から、介入病院だけで手指衛生キャンペーンが始まったとする。データは架空の病院の疑似データであり、実在の病院や施策の効果を示すものではない。
疑似データには、次の要素を仕込んでいる。
- 出発点の違い:介入病院は、もともと比較病院より感染率が1.0高い
- 介入前のトレンドの違い:比較病院は1か月あたり0.01ずつ、介入病院は0.03ずつ下がっている(傾きの差は −0.02)
- 全国通知(共介入):25か月目から、両病院とも 感染率が0.6下がる
- キャンペーンの効果:25か月目から、介入病院だけ さらに0.8下がる
- 自己相関のある誤差:前月の誤差の3割を引き継ぐノイズ(AR(1)、係数0.3)
つまり、正しく分析できれば、キャンペーンの効果として 約 −0.8 が推定されるはずである。
set.seed(2029)

n_month  <- 48
time     <- rep(1:n_month, times = 2)                  # 時間(1〜48か月目)
treat    <- rep(c(1, 0), each = n_month)               # 介入病院=1、比較病院=0
post     <- as.numeric(time >= 25)                     # 介入後(25か月目以降)=1
hospital <- factor(treat, levels = c(0, 1),
                   labels = c("Comparison", "Intervention"))

# 病院ごとに、自己相関のある誤差を作る(AR(1)、係数0.3)
noise <- c(as.numeric(arima.sim(model = list(ar = 0.3), n = n_month, sd = 0.25)),
           as.numeric(arima.sim(model = list(ar = 0.3), n = n_month, sd = 0.25)))

rate <- 5.0 +                  # 比較病院の出発点
        1.0 * treat +          # 介入病院はもともと1.0高い
       -0.01 * time +          # 比較病院の傾き(月あたり−0.01)
       -0.02 * time * treat +  # 介入病院はさらに月あたり−0.02(傾きの群間差)
       -0.6 * post +           # 全国通知(共介入):両病院とも0.6下がる
       -0.8 * post * treat +   # キャンペーンの効果:介入病院だけ0.8下がる
        noise
rate <- round(rate, 2)

d <- data.frame(hospital, treat, time, post, rate)
d[c(23:26, 71:74), ]
hospital treat time post rate
23 Intervention 1 23 0 5.14
24 Intervention 1 24 0 4.95
25 Intervention 1 25 1 3.65
26 Intervention 1 26 1 3.27
71 Comparison 0 23 0 4.50
72 Comparison 0 24 0 4.96
73 Comparison 0 25 1 4.50
74 Comparison 0 26 1 4.12データは「1行=1病院の1か月」の縦長の形にする。CITSで一番大事なのは、treat(処置群かどうか)と post(介入後かどうか)の2列を、0と1で正しく作ることである。この2列が、本文の式の T と $Post$ に当たる。
※コラム:ダミー変数は「テキトーなデータ」ではない
treatやpostのように、「当てはまれば1、当てはまらなければ0」に変換した変数を ダミー変数 と呼ぶ。名前に「ダミー」とつくので、テスト用に作ったテキトーな(任意の)データ(いわゆるダミーデータ)と混同されやすいが、まったくの別物である。ダミー変数の中身は、「介入病院か比較病院か」「介入の前か後か」という 実際の情報 を、回帰式に入れられるように0と1の数字に置き換えた、意味のあるデータ である。「ダミー」は「代役」という意味で、文字の情報の代わりに、数字が代役として式に入る、と考えるとよい。
なお、本記事で使っている「架空の数値で作ったデータ」の方は、混同を避けるために「疑似データ」と呼んでいる。
Step 2:グラフで眺める
分析の前に、必ずグラフでデータを眺める。
ggplot(d, aes(x = time, y = rate, colour = hospital)) +
  geom_point() +
  geom_line(alpha = 0.4) +
  geom_vline(xintercept = 24.5, linetype = "dashed") +
  labs(x = "Month", y = "Infections per 1,000 patient-days",
       colour = NULL, title = "Hand hygiene campaign (month 25)") +
  theme_bw() +
  theme(legend.position = "bottom")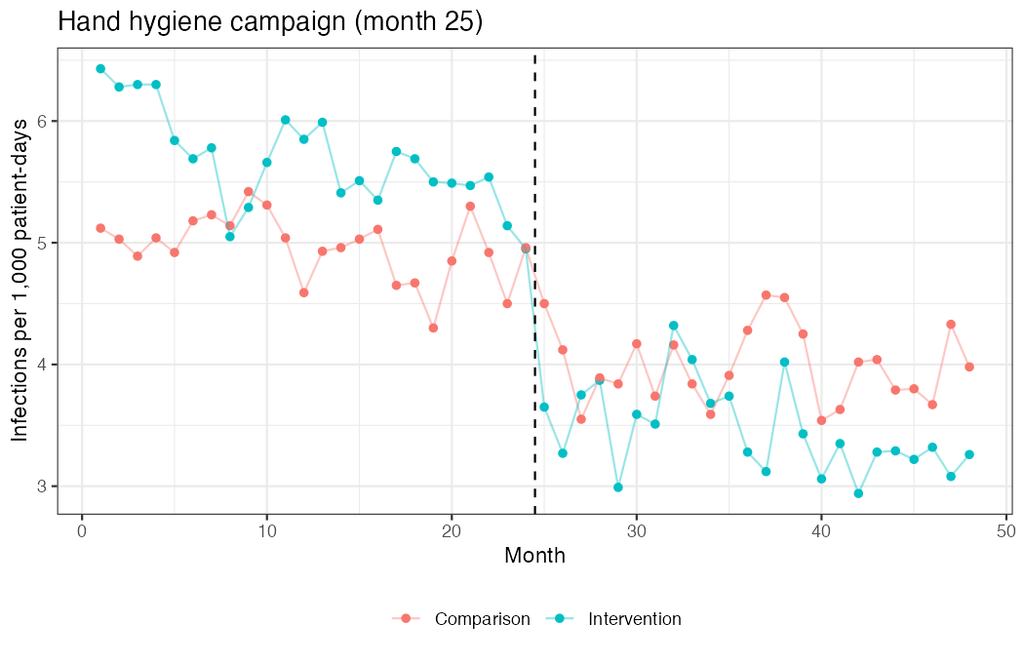
グラフのタイトルや軸ラベルは英語にしている。Macなどでは、フォントを指定せずに日本語を使うと文字が「□」(いわゆる豆腐)に化けることがあるためだ。
25か月目(点線)を境に、比較病院(Comparison)も 感染率が下がっている。これが全国通知(共介入)の影響である。介入病院(Intervention)は、それよりも大きく下がっているように見える。また、介入前の期間を見ると、介入病院の方が右下がりの傾きが急であることもわかる。
Step 3:Baseline Mean Model
まずは、本文の Baseline Mean Model を当てはめる。post * treat と書くと、post、treat、その交互作用項 post:treat の3つが自動でモデルに入る。
m_mean <- lm(rate ~ post * treat, data = d)
round(coef(summary(m_mean)), 3)
round(confint(m_mean)["post:treat", ], 2)
Estimate Std. Error t value Pr(>|t|)
(Intercept) 4.962 0.069 71.668 0
post -0.972 0.098 -9.928 0
treat 0.716 0.098 7.311 0
post:treat -1.245 0.138 -8.991 0
2.5 % 97.5 %
-1.52 -0.97 本文の式との対応は、post が 、treat が 、post:treat が である(今回は2病院だけなので、病院の特徴 は treat と区別できず、モデルに入れていない)。
キャンペーンの効果 は −1.25(95%信頼区間 −1.52〜−0.97)と推定された。仕込んだ効果は −0.8 なので、効果を大きく見積もりすぎている。
なぜだろうか。4つの平均を出してみると、仕組みがよくわかる。
aggregate(rate ~ hospital + post, data = d, FUN = mean) hospital post rate
1 Comparison 0 4.962083
2 Intervention 0 5.677917
3 Comparison 1 3.990000
4 Intervention 1 3.460833- 介入病院の変化:3.46 − 5.68 = −2.22
- 比較病院の変化:3.99 − 4.96 = −0.97(これが共介入の影響の見積もり)
- 差分の差分:−2.22 −(−0.97)= −1.25
は、まさにこの「差分の差分」である。比較病院の変化を差し引くことで、共介入の影響は取り除けている。しかし、介入病院は もともと比較病院より速いペースで下がっていた(傾きの差 −0.02/月)。Baseline Mean Modelはこの傾きの差を考慮しないため、もともとの下がりやすさまで、キャンペーンの効果に上乗せしてしまったのである。
上乗せされる量は、おおよそ計算できる。介入前24か月の真ん中(12.5か月目)と介入後24か月の真ん中(36.5か月目)は24か月離れているので、傾きの差 −0.02/月 × 24か月 = −0.48 が上乗せされる。真の効果 −0.8 に足すと −1.28 となり、推定値の −1.25 とほぼ一致する。本文の使い分けにあるとおり、Baseline Mean Modelは、介入前に両群が平坦で平行なときに向いた方法である。
Step 4:Baseline Linear-Trend Model
そこで、介入前の傾きの違いも考慮できる Baseline Linear-Trend Model を当てはめる。
m_lin <- lm(rate ~ time * treat + post * treat, data = d)
round(coef(summary(m_lin)), 3)
round(confint(m_lin), 3)
Estimate Std. Error t value Pr(>|t|)
(Intercept) 5.081 0.099 51.200 0.000
time -0.010 0.006 -1.526 0.131
treat 0.991 0.140 7.060 0.000
post -0.743 0.173 -4.291 0.000
time:treat -0.022 0.009 -2.489 0.015
treat:post -0.717 0.245 -2.927 0.004
2.5 % 97.5 %
(Intercept) 4.884 5.278
time -0.022 0.003
treat 0.712 1.270
post -1.087 -0.399
time:treat -0.040 -0.004
treat:post -1.204 -0.230(Pr(>|t|) の0.000は、小数第3位で丸めた結果であり、P < 0.001 という意味である。また、Rは交互作用項の名前を treat:post の順に表示するが、post:treat と同じものである)
本文の式との対応と、仕込んだ値との比較は次のとおりである。
| Rの係数 | 本文の式 | 意味 | 推定値 | 仕込んだ値 |
|---|---|---|---|---|
time | 統制群(比較病院)の傾き | −0.010 | −0.01 | |
treat | 処置群と統制群の出発点の差 | 0.99 | 1.0 | |
post | 両群に共通の、介入時点での段差(共介入の影響) | −0.74 | −0.6 | |
time:treat | 処置群と統制群の 傾きの差 | −0.022 | −0.02 | |
treat:post | キャンペーンの効果 | −0.72 | −0.8 |
キャンペーンの効果 は −0.72(95%信頼区間 −1.20〜−0.23)と推定され、仕込んだ −0.8 に近づいた。傾きの差 (−0.022)をモデルの中で別に推定したことで、「もともとの下がりやすさ」がキャンペーンの効果から切り離されたのである。
ただし、推定値がここまで真の値に近くなったのは、乱数の巡り合わせもある。本記事では説明しやすい乱数(set.seed(2029))を選んでいるが、set.seed() の値を変えて20通り試すと、 の推定値は −0.58〜−1.44 の範囲でばらついた。48か月×2病院のデータでは、この程度の不確かさがあるということである。1回の推定値だけを見るのではなく、信頼区間の幅もあわせて読むことが大切である。
この結果を、「キャンペーンがなかったら、介入病院の感染率はどうなっていたか」(反事実)と並べてグラフにすると、効果の意味がつかみやすい。
d$fit <- predict(m_lin)
d$cf  <- d$fit - coef(m_lin)["treat:post"] * d$post * d$treat   # β6の分だけを取り除く
ggplot(d, aes(x = time, colour = hospital)) +
  geom_point(aes(y = rate), alpha = 0.5) +
  geom_line(aes(y = fit), linewidth = 1) +
  geom_line(data = subset(d, treat == 1 & post == 1), aes(y = cf),
            linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = 24.5, linetype = "dotted") +
  labs(x = "Month", y = "Infections per 1,000 patient-days", colour = NULL,
       title = "Fitted lines (solid) and counterfactual without the campaign (dashed)") +
  theme_bw() +
  theme(legend.position = "bottom")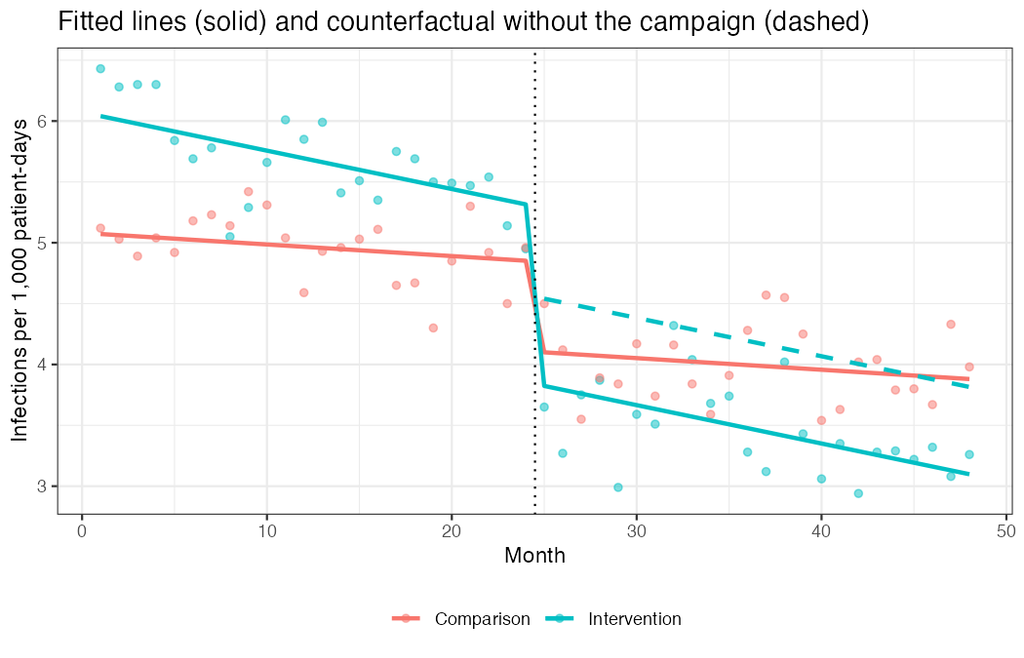
介入病院の破線が、「全国通知の影響は受けたが、キャンペーンはしなかった場合」の予測である。実線(実際の当てはめ)との間の縦の幅が、キャンペーンの効果 に当たる。
補足:このモデルは、キャンペーンの効果を「介入時点での段差」として推定している。介入後に傾きそのものが変わる効果も見たい場合は、Linden(2015)のように、介入後の経過時間と処置群の交互作用項を追加する。また、本文の Baseline Nonlinear-Trend Model は、
lm(rate ~ factor(time) + treat + treat:post, data = d)のように、時間を月ごとのダミー変数(factor(time))に置き換えて書ける。postは月ダミーの中に含まれてしまうため、単独では入れない(入れると係数がNAになる)。この形は、両群に 共通 の月ごとの変動を、直線に限らず柔軟に表すものであり、群間の傾きの差までは考慮しない。実際、今回の疑似データで実行すると効果は −1.25 となり、Baseline Mean Model と同じ値になった。介入前の傾きが群間で違うデータには向かない点に注意したい。さらに、感染率のような「率」や件数のデータは、ポアソン回帰などで分析されることも多い。本記事では、わかりやすさを優先して線形回帰で示している。
もう一つ、今回の例は介入病院・比較病院が1つずつである。この場合、本文の式の群内誤差 (病院ごとのばらつき)は推定できず、信頼区間には月ごとの揺らぎによる不確かさしか反映されない。実際の研究では、複数の病院(クラスタ)同士を比べ、病院ごとの違いを混合モデルなどで扱うことが多い。
Step 5:【ダメな例】介入病院だけで1群のITSを行う
ここで、比較病院のデータを使わずに、介入病院だけで1群のITSを行うとどうなるかを確かめておく。
m_its <- lm(rate ~ time + post, data = subset(d, treat == 1))
round(coef(summary(m_its)), 3)
round(confint(m_its)["post", ], 2)
Estimate Std. Error t value Pr(>|t|)
(Intercept) 6.072 0.103 58.720 0
time -0.032 0.007 -4.842 0
post -1.460 0.180 -8.092 0
2.5 % 97.5 %
-1.82 -1.10介入時点での段差は −1.46(95%信頼区間 −1.82〜−1.10)と推定された。これは、キャンペーンの効果(−0.8)と全国通知の影響(−0.6)を 足し合わせた値(−1.4)にほぼ一致する。1群だけのITSでは、介入前の傾きは考慮できても、同じ時期に起きた共介入の影響を、すべてキャンペーンの手柄にしてしまうのである。
3つの方法の推定値を並べると、違いがはっきりする。
| 方法 | キャンペーンの効果の推定値(95%信頼区間) | 何がずれの原因か |
|---|---|---|
| 1群のITS(介入病院だけ) | −1.46(−1.82〜−1.10) | 共介入の影響まで上乗せ |
| CITS:Baseline Mean Model | −1.25(−1.52〜−0.97) | 介入前の傾きの差を上乗せ |
| CITS:Baseline Linear-Trend Model | −0.72(−1.20〜−0.23) | 適切に推定できている |
| (仕込んだ真の値) | −0.8 |
Step 6:自己相関を考慮する(GLS+AR(1))
最後に、自己相関への対処である。まず、Step 4のモデルの残差について、病院ごとに「前の月との相関」(ラグ1の自己相関)を確認する。
round(acf(resid(m_lin)[d$treat == 1], plot = FALSE)$acf[2], 2)
round(acf(resid(m_lin)[d$treat == 0], plot = FALSE)$acf[2], 2)
[1] 0.26
[1] 0.32どちらの病院でも、残差に正の自己相関が残っている。そこで、nlme パッケージの gls() を使い、病院ごとに 前月の誤差を引き継ぐ構造(AR(1))を仮定して当てはめ直す。corAR1(form = ~ time | hospital) の | hospital が、「自己相関は同じ病院の中だけで考える」という指定である。
m_gls <- gls(rate ~ time * treat + post * treat, data = d,
             correlation = corAR1(form = ~ time | hospital), method = "REML")
round(summary(m_gls)$tTable, 3)
round(intervals(m_gls, which = "coef")$coef, 3)
coef(m_gls$modelStruct$corStruct, unconstrained = FALSE)   # AR(1)係数
Value Std.Error t-value p-value
(Intercept) 5.098 0.142 35.886 0.000
time -0.012 0.008 -1.374 0.173
treat 1.003 0.201 4.991 0.000
post -0.676 0.229 -2.949 0.004
time:treat -0.022 0.012 -1.859 0.066
treat:post -0.730 0.324 -2.251 0.027
lower est. upper
(Intercept) 4.816 5.098 5.380
time -0.028 -0.012 0.005
treat 0.604 1.003 1.402
post -1.132 -0.676 -0.221
time:treat -0.046 -0.022 0.002
treat:post -1.374 -0.730 -0.086
Phi
0.3715039 キャンペーンの効果 の推定値は −0.73 で、Step 4(−0.72)とほとんど変わらない。変わったのは 標準誤差 で、0.245から0.324に大きくなり、95%信頼区間も −1.37〜−0.09 と広がった。残差に正の自己相関があると、通常の線形回帰の標準誤差は小さめに出やすい。自己相関を無視したStep 4の信頼区間は、実際より狭すぎた(不確かさを小さく見積もりすぎていた)可能性が高い。推定されたAR(1)係数は0.37で、仕込んだ0.3に近い。
このように、自己相関は効果の推定値そのものよりも、どれだけ確かと言えるか(信頼区間・P値)に影響する。結果を報告するときは、自己相関を考慮したモデルの信頼区間を使いたい。
論文でそのまま使える英文テンプレート
以下の数値は、本記事の疑似データを実際に解析した結果である。自分のデータに使うときは、[ ]内を必ず自分の解析結果に置き換えてほしい。
Methods
We conducted a comparative interrupted time series (CITS) analysis to evaluate the effect of [a hand hygiene campaign] introduced in [month 25] at [the intervention hospital] on [monthly healthcare-associated infection rates per 1,000 patient-days]. [A neighbouring hospital that did not implement the campaign] served as the comparison series. Data covering [24] months before and [24] months after the introduction were analysed using a baseline linear-trend model, which included terms for time, group, the post-intervention period, the interaction between time and group (to allow for different pre-intervention trends), and the interaction between the post-intervention period and group, the coefficient of which represented the effect of the campaign. To account for autocorrelation, the model was fitted by generalized least squares with a first-order autoregressive error structure within each hospital, estimated by restricted maximum likelihood. All analyses were performed using R version [4.6.1] with the nlme package.
(和訳の要点:CITSデザインであること、介入と比較群、期間、Baseline Linear-Trend Modelの各項と効果を表す係数、病院ごとのAR(1)を仮定したGLS(REML)、使用ソフト)
Results
The estimated difference in pre-intervention slope between the intervention and comparison hospitals was [−0.022] per month (95% CI, [−0.046] to [0.002]). At the time of the campaign, the infection rate at the comparison hospital decreased by [0.68] per 1,000 patient-days (95% CI, [0.22] to [1.13]), suggesting a concurrent secular change. After accounting for this change and for the difference in pre-intervention trends, the campaign was associated with an additional reduction of [0.73] infections per 1,000 patient-days (95% CI, [0.09] to [1.37]) at the intervention hospital. The estimated first-order autocorrelation coefficient was [0.37].
査読者に「なぜ1群のITSではないのか」と聞かれたときの一文
Because [a national notice on infection control] was issued around the same time as the campaign, a single-group interrupted time series could not separate the effect of the campaign from that of this concurrent event; the comparison series allowed us to account for such co-interventions.
限界(Limitations)の記述例
Our analysis assumed that, in the absence of the campaign, the difference in trends between the two hospitals would have continued unchanged, and that the comparison hospital was affected by concurrent events in the same way as the intervention hospital. With only one hospital in each group, we could not account for hospital-level variation beyond these assumptions.
一括コピペ用Rスクリプト
# ============================================================
# 比較分割時系列(CITS)解析:手指衛生キャンペーンと院内感染率(疑似データ)
# ============================================================

# --- Step 0:パッケージ ---
# install.packages(c("ggplot2", "nlme"))
library(ggplot2)
library(nlme)

# --- Step 1:疑似データの作成(2病院 × 48か月)---
set.seed(2029)

n_month  <- 48
time     <- rep(1:n_month, times = 2)                  # 時間(1〜48か月目)
treat    <- rep(c(1, 0), each = n_month)               # 介入病院=1、比較病院=0
post     <- as.numeric(time >= 25)                     # 介入後(25か月目以降)=1
hospital <- factor(treat, levels = c(0, 1),
                   labels = c("Comparison", "Intervention"))

# 病院ごとに、自己相関のある誤差を作る(AR(1)、係数0.3)
noise <- c(as.numeric(arima.sim(model = list(ar = 0.3), n = n_month, sd = 0.25)),
           as.numeric(arima.sim(model = list(ar = 0.3), n = n_month, sd = 0.25)))

rate <- 5.0 +                  # 比較病院の出発点
        1.0 * treat +          # 介入病院はもともと1.0高い
       -0.01 * time +          # 比較病院の傾き(月あたり−0.01)
       -0.02 * time * treat +  # 介入病院はさらに月あたり−0.02(傾きの群間差)
       -0.6 * post +           # 全国通知(共介入):両病院とも0.6下がる
       -0.8 * post * treat +   # キャンペーンの効果:介入病院だけ0.8下がる
        noise
rate <- round(rate, 2)

d <- data.frame(hospital, treat, time, post, rate)
d[c(23:26, 71:74), ]

# --- Step 2:グラフで眺める ---
ggplot(d, aes(x = time, y = rate, colour = hospital)) +
  geom_point() +
  geom_line(alpha = 0.4) +
  geom_vline(xintercept = 24.5, linetype = "dashed") +
  labs(x = "Month", y = "Infections per 1,000 patient-days",
       colour = NULL, title = "Hand hygiene campaign (month 25)") +
  theme_bw() +
  theme(legend.position = "bottom")

# --- Step 3:Baseline Mean Model ---
m_mean <- lm(rate ~ post * treat, data = d)
round(coef(summary(m_mean)), 3)
round(confint(m_mean)["post:treat", ], 2)

aggregate(rate ~ hospital + post, data = d, FUN = mean)   # 4つの平均

# --- Step 4:Baseline Linear-Trend Model ---
m_lin <- lm(rate ~ time * treat + post * treat, data = d)
round(coef(summary(m_lin)), 3)
round(confint(m_lin), 3)

# 反事実(キャンペーンがなかった場合)の線を描く
d$fit <- predict(m_lin)
d$cf  <- d$fit - coef(m_lin)["treat:post"] * d$post * d$treat   # β6の分だけを取り除く
ggplot(d, aes(x = time, colour = hospital)) +
  geom_point(aes(y = rate), alpha = 0.5) +
  geom_line(aes(y = fit), linewidth = 1) +
  geom_line(data = subset(d, treat == 1 & post == 1), aes(y = cf),
            linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = 24.5, linetype = "dotted") +
  labs(x = "Month", y = "Infections per 1,000 patient-days", colour = NULL,
       title = "Fitted lines (solid) and counterfactual without the campaign (dashed)") +
  theme_bw() +
  theme(legend.position = "bottom")

# --- Step 5:【ダメな例】介入病院だけで1群のITSを行う ---
m_its <- lm(rate ~ time + post, data = subset(d, treat == 1))
round(coef(summary(m_its)), 3)
round(confint(m_its)["post", ], 2)

# --- Step 6:自己相関を考慮する(GLS+AR(1))---
# 残差のラグ1自己相関(病院ごと)
round(acf(resid(m_lin)[d$treat == 1], plot = FALSE)$acf[2], 2)
round(acf(resid(m_lin)[d$treat == 0], plot = FALSE)$acf[2], 2)

m_gls <- gls(rate ~ time * treat + post * treat, data = d,
             correlation = corAR1(form = ~ time | hospital), method = "REML")
round(summary(m_gls)$tTable, 3)
round(intervals(m_gls, which = "coef")$coef, 3)
coef(m_gls$modelStruct$corStruct, unconstrained = FALSE)   # AR(1)係数
まとめ
Comparative Interrupted Time Series CITS は、RCTが実施しにくい状況で、集団レベルで処置が施され、複数時点のデータが取得出来ていて、処置群・統制群ともに一貫してデータが取得出来ている状況において適切な方法である。
学校など施設単位の介入の効果を経年データを用いて解析する場面に適していると考えられる。
Rでは、lm() に treat(処置群)と post(介入後)の2つのダミー変数と、その交互作用項を入れるだけでCITSを実行できる。介入前に処置群と統制群の傾きが違う場合は、Baseline Mean Model(差分の差分法)では効果を見誤ることがあるため、Baseline Linear-Trend Modelで傾きの違いを考慮したい。また、時系列データでは自己相関が残りやすいため、gls() などで考慮したうえで、信頼区間を報告するとよい。
参考サイト(PDF)
https://cteresearchnetwork.org/sites/default/files/2020-11/CTERN-STI20-CITS-508.pdf
https://journals.sagepub.com/doi/pdf/10.1177/1536867X1501500208
http://lindenconsulting.org/documents/Weighted_TSA_Article.pdf
参考文献
- Somers MA, Zhu P, Jacob R, Bloom H. The Validity and Precision of the Comparative Interrupted Time Series Design and the Difference-in-Difference Design in Educational Evaluation. MDRC; 2013. https://www.mdrc.org/work/publications/validity-and-precision-comparative-interrupted-time-series-design-and-difference
- St.Clair T, Cook TD, Hallberg K. Examining the internal validity and statistical precision of the comparative interrupted time series design by comparison with a randomized experiment. American Journal of Evaluation. 2014;35(3):311–327. https://doi.org/10.1177/1098214014527337
- Lopez Bernal J, Cummins S, Gasparrini A. The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology. 2018;47(6):2082–2093. https://doi.org/10.1093/ije/dyy135
- Linden A. Conducting interrupted time-series analysis for single- and multiple-group comparisons. The Stata Journal. 2015;15(2):480–500. https://journals.sagepub.com/doi/abs/10.1177/1536867X1501500208
おすすめ書籍
CITSの土台にある「比較で因果に迫る」考え方を、やさしい入門書から本格的な教科書まで、段階的に学べる3冊を紹介する。
1. 伊藤公一朗『データ分析の力 因果関係に迫る思考法』(光文社新書) 数式をほとんど使わずに、ランダム化比較試験、回帰不連続デザイン、差分の差分法(DiD)などの考え方を、実際の政策評価の事例で解説している。本記事のコラムで紹介したDiDの発想を、まず直感的につかみたい人の最初の1冊に向いている。 👉 https://link.amazon/B09yXJk4Z
2. 安井翔太『効果検証入門〜正しい比較のための因果推論/計量経済学の基礎』(技術評論社) 回帰分析、傾向スコア、差分の差分法などによる効果検証を、Rのコードとともに学べる。本記事のように「lm() に交互作用項を入れて効果を推定する」流れを、ほかの手法とあわせて手を動かしながら身につけたい人に向いている。 👉 https://link.amazon/B0bvyObHM
3. Shadish WR, Cook TD, Campbell DT. Experimental and Quasi-Experimental Designs for Generalized Causal Inference(Houghton Mifflin) 準実験デザインの古典的な教科書である。分割時系列デザインに1章が割かれているほか、本記事のコラムで紹介した instrumentation(測定)や history(同時期の出来事)などの「妥当性への脅威」が体系的に整理されている。CITSの設計を本格的に学びたい人向けの1冊である(英語)。 👉 https://link.amazon/B0eZ5wTEZ

コメント