後輩:「先輩、市の消防局から月ごとの救急搬送件数のデータをもらいました。2018年1月から2025年12月までの96か月分です」
先輩:「いいデータだね。何を調べたいんだい?」
後輩:「この市では2022年1月に 救急安心センター事業(#7119) が始まりました。救急車を呼ぶか迷ったときに電話で相談できる窓口です。それで搬送が減ったかを調べたいんです。でも時系列の解析方法を調べると、Mann-Kendall検定、ADF検定、KPSS検定、ARIMA、ITS、CITS……と次々に出てきて、どれを使えばいいのかわからなくなってしまって」
先輩:「手法の名前から選ぼうとすると、みんなそこで迷うんだ。選ぶ順番が逆なんだよ。先に『何を知りたいか』を決める。そうすれば、使う手法はほぼ自動的に決まる」
後輩:「何を知りたいか……。#7119が始まった その時点を境に、搬送件数が変わったかどうかです」
先輩:「それなら答えは 分割時系列解析(Interrupted Time Series、ITS) だ。ただ、ほかの手法とどう違うのかもあわせて整理しておこう。次に別のデータを渡されたときに、もう迷わなくて済むからね」
時系列データの解析方法に悩む初学者は多い。教科書やWebの記事は手法ごとに書かれているのに、現場のデータは「どの手法を使えばいいか」という問いから始まるからである。
本記事は2部構成である。
- 前半:時系列解析の手法を「問い」で整理した 地図 を示す。統計ERで解説してきたMann-Kendall検定、ADF検定とKPSS検定、CITS(比較分割時系列)が、地図のどこに位置するのかがわかる
- 後半:地図の中から ITS を取り上げ、初学者がハマる5つの罠と、Rでの実装をStep by Stepで確認する
1. 時系列解析は「問い」で選ぶ:手法の地図
行き先を決めてから、乗る電車を選ぶ
大きな駅の路線図の前で、行き先を決めずに「どの電車に乗ろうか」と悩んでも答えは出ない。まず行き先を決める。そうすれば、乗るべき路線は自然に決まる。
時系列解析も同じである。手法の一覧を眺めて悩むより先に、自分のデータに投げかけたい問い をはっきりさせる。代表的な問いと手法の対応は、次のとおりである。
| 知りたいこと(問い) | 手法 | 解説記事 |
|---|---|---|
| 一貫して増えて(減って)いるか、どれくらいのペースか | Mann-Kendall検定+Sen’s slope | Mann-Kendall検定とSen’s slope |
| 回帰やARIMAの前提となる「定常性」を満たすか | ADF検定×KPSS検定 | ADF検定とKPSS検定の組み合わせ方 |
| ある時点の出来事(政策・介入)で、水準や傾きが変わったか | ITS(分割時系列解析) | 本記事 |
| その変化は、同じ時期の別の出来事のせいではないと言えるか | CITS(比較分割時系列解析) | Comparative Interrupted Time Series とは |
| 将来の値を予測したいか | ARIMAなど | Rで時系列データ分析を行う方法 |
問いの立て方で迷ったときは、次の順に自分に問いかけてみるとよい。
【出発点】まずグラフとコレログラムでデータの素顔を見る
    │
    ├─ Q1. 特定の時点に「出来事」(政策・介入・事故など)があったか?
    │     │
    │     ├─ Yes → Q2. 同じ時期に起きた別の出来事と切り分けたいか?
    │     │          │    また、介入を受けていない比較対象の系列はあるか?
    │     │          ├─ 対照系列あり → CITS
    │     │          └─ 対照系列なし → ITS(本記事)
    │     │
    │     └─ No → Q3. 知りたいのは「過去の傾向」か「将来の予測」か?
    │                ├─ 過去の傾向 → Mann-Kendall検定+Sen's slope
    │                └─ 将来の予測 → ARIMAなど
    │
    └─ どの道を選んでも:系列の性質を知るため、ADF×KPSSで定常性を確認しておくと安心
(ITSでは「介入前の期間だけ」で確認する → 第3章の罠⑤)ポイントは、これらの手法は二者択一ではない ということである。ADF×KPSSは、どの道を選んでも役に立つ「健康診断」のようなものだ。必須の手順ではないが、系列の性質(一定の坂を上っているのか、漂流しているのか)を知っておくと、モデルの選び方や結果の解釈で迷いにくくなる。ITSやMann-Kendall検定を使うときも、自己相関と季節性の確認は欠かせない。本記事の後半のRの実装でも、MK記事やADF-KPSS記事で使った道具が繰り返し登場する。
※コラム:なぜ普通のt検定や回帰ではダメなのか
t検定や通常の回帰は、「データ一つひとつが互いに独立である」ことを前提にしている。ところが時系列データは、たいてい「先月の状態を引きずる」。MK記事では、これを 仲良しグループが混ざった多数決 に喩えた。30人のクラスでも、いつも同じ意見を言う5人組が6つあれば、実質は6票分の意見しかない。それを30票として数えると、実態以上に自信満々な結論が出てしまう。
時系列データに普通の検定をそのまま使うと、同じことが起きる。標準誤差が小さく見積もられ、P値が小さく出すぎるのである。時系列専用の手法が必要なのは、このためである。
2. ITSとは:「介入がなかった世界」の延長線と比べる
ダイエットの効果を正しく測るには
ダイエットを始めた人が、「開始前の1年間の平均体重」と「開始後の1年間の平均体重」を比べて、「5kg減った、ダイエット成功!」と喜んでいるとしよう。
しかし、もしこの人が ダイエットを始める前から毎月0.3kgずつ減っていた としたらどうだろう。何もしなくても1年で3.6kg減っていたはずなので、ダイエットの本当の効果は5kgよりずっと小さい。逆に、開始前は毎月増えていた人なら、「前後で変わらない」ことが立派な効果かもしれない。
正しい比べ方は、「ダイエットを始めなかったら、体重はそれまでのペースでこう推移したはずだ」という延長線を引き、実際の体重と比べること である。この延長線を 反事実(counterfactual) と呼ぶ。
これがITSの考え方のすべてである。介入前のデータから「介入がなかった世界」の延長線を描き、介入後の実際のデータとのずれを介入効果とみなす。
※コラム:反事実(counterfactual)とは
「もし〜がなかったら、どうなっていたか」という、実際には観測できない仮想の世界のことである。因果推論では、介入の効果を「実際の世界」と「反事実の世界」の差として定義する。RCTでは、ランダムに割り付けた対照群が反事実の代わりを務める。ITSでは、介入前のトレンドの延長線 がその代わりを務める。だからITSでは、「介入前のトレンドが、介入がなければそのまま続いたはずだ」という仮定が結論の土台になる。
セグメント回帰:「段差」と「傾きの変化」を分けて測る
ITSの標準的な解析方法は、セグメント回帰(segmented regression) である(Wagner et al., 2002)。数式は1本だけ示す。
$$
Y_t = \beta_0 + \beta_1 \cdot \text{time}_t + \beta_2 \cdot \text{level}_t + \beta_3 \cdot \text{time\_after}_t + \varepsilon_t
$$
| 変数 | 意味 |
|---|---|
| $\text{time}_t$ | 観察開始からの経過時間(1, 2, 3, …) |
| $\text{level}_t$ | 介入前は0、介入後は1 |
| $\text{time\_after}_t$ | 介入後の経過時間(介入前は0、介入した月を0として 0, 1, 2, …) |
| 係数 | 意味 | ダイエットの例では |
|---|---|---|
| $\beta_1$ | 介入前の傾き(もともとのトレンド) | 開始前の毎月の体重の変化 |
| $\beta_2$ | 水準の変化:介入直後の段差 | 始めた直後にストンと落ちた分 |
| $\beta_3$ | 傾きの変化:介入前と比べて、傾きがどれだけ変わったか | 毎月の減り方が加速した分 |
効果を 「段差」と「傾きの変化」の2つに分けて 測れるのが、ITSの大きな強みである。#7119のような事業なら、始まった直後に搬送が減る(段差)だけでなく、市民に周知されるにつれて減り方が大きくなる(傾きの変化)ことも考えられる。
3. 初学者がハマるITSの5つの罠
ITSは強力な手法だが、落とし穴も多い。ここでは初学者が特にハマりやすい5つを挙げる。いずれも統計ERの既存記事とつながっている。
罠①:介入前後の平均を単純に比べる
ダイエットの例で見たとおりである。もともと増加傾向にある系列では、介入に効果があっても、介入後の平均の方が大きくなることがある。後半のStep 3では、この罠が実際に起きる様子をRで確かめる。
罠②:自己相関を無視する
コラムで述べた「仲良しグループの多数決」の問題である。自己相関を無視した通常の最小二乗法(OLS)では、標準誤差が小さくなりすぎ、信頼区間が狭くなりすぎる。Turner et al.(2021)のシミュレーション研究では、自己相関を考慮する方法を使っても自己相関の大きさは過小評価されがちで、その結果、信頼区間の被覆率が名目の95%を下回ることが示されている。同研究では、制限付き最尤法(REML) が自己相関を最も偏りなく推定し、12点以上の系列ではREMLが推奨されている。
→ MK記事の 罠①:自己相関 と同じ構図である。
罠③:季節性を調整しない
救急搬送は冬(感染症・心血管疾患・転倒)に多く、地域によっては夏(熱中症)にも増える(後半の疑似データでは、単純化のため冬のピークだけを入れている)。介入の直前が冬のピークで、直後が春の谷なら、季節の波だけで「介入後に減った」ように見えてしまう。月をカテゴリ変数として入れる(月ダミー)か、サイン・コサインの調和項を入れて調整する(Lopez Bernal et al., 2017)。
→ MK記事の 罠②:季節性 で紹介した「7月と1月で背比べをしない」と同じ発想である。
罠④:同じ時期に起きた別の出来事を見落とす
ITSの最大の弱点がこれである。ITSは1つの集団の中で前後を比べるので、介入とほぼ同時に起きた別の出来事(共介入) の影響を区別できない(Lopez Bernal et al., 2018)。例えば、#7119と同じ時期に感染症の流行が収まったり、近隣の病院が救急の受け入れ体制を変えたりすれば、その影響も「#7119の効果」に混ざってしまう。
対処法は、介入を受けていない比較対象の系列(対照系列)を加える ことである。例えば、#7119を導入していない近隣の市の搬送件数を並べて比べる。これが CITS(比較分割時系列解析) である。
→ CITSの記事 で、対照群の選び方とモデルの使い分けを解説している。
罠⑤:介入をまたいで定常性を検定する/介入前の時点が少なすぎる
回帰の前提を確かめるためにADF検定やKPSS検定を使うとき、介入をまたいだ系列全体 で検定してはいけない。介入による段差は、ADF検定から見ると「ショックが消えずに残った」ように見え、単位根と取り違えられやすいからである(Perron, 1989)。介入前の期間だけで 検定するのが安全である。
また、介入前の時点が少なすぎると、「介入前のトレンド」自体が不安定になり、反事実の延長線が信頼できなくなる。月次データなら、季節性を推定するためにも、介入前に少なくとも数年分のデータがあることが望ましい。
→ ADF-KPSS記事 のコラム「構造変化があると、判定を誤りやすい」で、ナイル川の流量データを使ってこの罠を実演している。
※コラム:件数データならポアソン回帰も
救急搬送「件数」のようなカウントデータでは、ポアソン回帰(過分散があれば準ポアソン回帰や負の二項回帰)を使うのが本来の形である。Lopez Bernal et al.(2017)のチュートリアルでも、準ポアソン回帰(quasi-Poisson)を使っている。人口を補正する場合は、人口の対数をオフセットとして入れれば「人口あたりの率」をモデル化できる。この場合、効果は「件数の差」ではなく 「率の比(何%変化したか)」 として表される。
本記事では、考え方をつかむことを優先して線形モデル(正規分布)で示す。1か月に1,000件前後と件数が十分に多い場合、線形モデルでも近い結果になることが多い。ただし、件数が少ない系列(例:月に数件〜数十件)では、ポアソン系のモデルを使うべきである。
4. 正攻法:文献で確認する標準的な手順
ITSの方法論は、医療政策・公衆衛生の分野で整備されてきた。初学者がまず押さえておきたい文献を挙げる。
- Wagner et al.(2002):医薬品の使用に関する政策・教育介入の評価に、セグメント回帰を体系的に適用した古典的な論文である。ITSを「準実験デザインの中で最も強力なアプローチ」と位置づけている。
- Lopez Bernal et al.(2017):公衆衛生介入のITSのチュートリアルである。イタリアの全国禁煙法(2005年1月施行)について、シチリア州の急性冠イベントのデータを例に、季節性の調整、自己相関の確認、効果の形(段差か傾きか)の事前設定までを解説している。データとRのコードも公開されている。なお、2020年に訂正(Corrigendum)が出され、モデルの定義とRのコードが修正されている。GitHubで公開されているのは訂正後のコードである。
- Kontopantelis et al.(2015, BMJ):ランダム化ができないときの準実験デザインとしてのITSについて、各モデリング方法の長所・短所・前提を実例とともに解説している。
- Turner et al.(2021):自己相関の扱い方(OLS、Newey-West、Prais-Winsten、REML、ARIMAなど)をシミュレーションで比較した研究である。
- Schaffer et al.(2021):セグメント回帰の代わりに ARIMAモデル でITSを行う方法のガイドである。自己相関や季節性をARIMAの枠組みで柔軟に表現でき、時系列の基礎記事で扱った
auto.arima()とも地続きである。本記事では、解釈のしやすさを優先してセグメント回帰を使う。
臨床・公衆衛生での応用例としては、Barone-Adesi et al.(2011) がある。チュートリアルの例と同じ禁煙法について、イタリア全国20州のデータを使い、施行前後の急性冠イベントによる入院率の変化をITSで評価している。
これらの文献を踏まえた標準的な手順は、次のとおりである。
- 介入時点と、想定する効果の形(段差・傾きの変化・移行期間)を、データを見る前に決める
- グラフを描く:トレンド、季節性、外れ値、介入前後の変化を目で確認する
- 介入前の期間で定常性を確認する(罠⑤)
- セグメント回帰を当てはめる:季節性を調整する(罠③)
- 残差の自己相関を確認し、考慮したモデルで推定する(罠②)
- 反事実と比べて、効果を具体的な数字で語る:「◯か月後に月あたり◯件(◯%)少ない」
- 共介入の可能性を検討する:必要なら対照系列を加える(罠④、CITS)
手順1が最初にあることに注意してほしい。データを見てから「段差だけのモデル」「傾きも入れたモデル」などを取っ替え引っ替えして、一番都合のよい結果を報告するのは、MK記事でも触れたP値ハッキングである。
5. Rで実装してみよう(Step by Step)
ここからは、冒頭の後輩のデータを模した疑似データで、ここまでの内容を確認していく。使うパッケージは次の4つである。
nlme:gls()で、自己相関(AR(1))を考慮した回帰を行うlmtest:dwtest()でDurbin-Watson検定、coeftest()で標準誤差を差し替えた係数の検定を行うsandwich:NeweyWest()で、自己相関に頑健な標準誤差を計算するtseries:ADF-KPSS記事と同じく、adf.test()とkpss.test()を使う
以下の結果は、R 4.6.1 で実際に実行して確認したものである。乱数を使うため、set.seed() の値やRのバージョンが違うと数値は変わる。
Step 0:パッケージの準備
# install.packages(c("nlme", "lmtest", "sandwich", "tseries"))
library(nlme)
library(lmtest)
library(sandwich)
library(tseries)
Step 1:疑似データを作る
ある市の月次の救急搬送件数(2018年1月〜2025年12月、96か月)を、次の要素を足し合わせて作る。データは架空の市の疑似データであり、実在の#7119事業の効果を示すものではない。
- 介入前のトレンド:1か月あたり3件ずつ増える(高齢化による増加を想定)
- 季節性:1月をピークに、冬は+60件、夏は−60件ほど上下する波
- 自己相関のある誤差:前月の誤差の5割を引き継ぐノイズ(AR(1)、係数0.5)
- #7119の効果(2022年1月から):水準が60件下がり(段差)、傾きが1か月あたり2件小さくなる(増加ペースが月3件から月1件に鈍る)
MK記事やADF-KPSS記事と同じく、罠②(自己相関)と罠③(季節性)が再現されるように、あえて仕込んでいる。
set.seed(7119)

n     <- 96
time  <- 1:n                              # 時間(1〜96か月目)
month <- rep(1:12, times = 8)             # 月(1〜12)
year  <- rep(2018:2025, each = 12)        # 年

level      <- as.numeric(time >= 49)      # 介入(2022年1月=49か月目以降が1)
time_after <- pmax(0, time - 49)          # 介入後の経過月数(2022年1月が0)

season <- 60 * cos(2 * pi * (month - 1) / 12)                            # 1月ピークの季節の波
noise  <- as.numeric(arima.sim(model = list(ar = 0.5), n = n, sd = 25))  # 自己相関のある誤差

calls <- round(1000 + 3 * time - 60 * level - 2 * time_after + season + noise)

d <- data.frame(year, month, time, level, time_after, calls)
calls_ts <- ts(calls, start = c(2018, 1), frequency = 12)ITSの解析で一番大事なのは、level と time_after の2列を正しく作ることである。介入の前後で、データは次のようになる。
   year month time level time_after calls
48 2021    12   48     0          0  1215
49 2022     1   49     1          0  1182
50 2022     2   50     1          1  1174
Step 2:介入線を入れた時系列グラフ
plot(calls_ts, type = "o", pch = 16, cex = 0.6,
     xlab = "Year", ylab = "Ambulance transports (per month)",
     main = "Monthly ambulance transports")
abline(v = 2022, col = "red", lty = 2)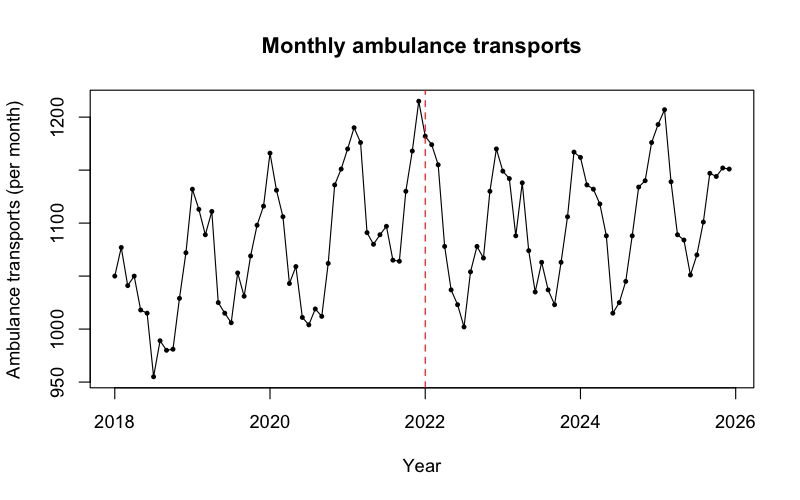
グラフのタイトルや軸ラベルは英語にしている。Macなどでは、フォントを指定せずに日本語を使うと文字が「□」(いわゆる豆腐)に化けることがあるためだ。
毎年冬に山、夏に谷が来る季節の波がはっきり見える。介入前(赤い点線の左側)は、その波全体が右肩上がりに増えている。介入後は、2022年の冬の山が2021年より低くなり、その後も増え方がゆるやかになっているように見える。ただし、目視だけでは、季節の波に埋もれた変化の大きさはわからない。
Step 3:【ダメな例】介入前後の平均を比べる
まず、罠①をわざと踏んでみる。介入前48か月と介入後48か月の平均を、t検定で比べる。
t.test(calls ~ level, data = d) Welch Two Sample t-test
data: calls by level
t = -2.5969, df = 92.523, p-value = 0.01094
...
sample estimates:
mean in group 0 mean in group 1
1073.958 1104.625介入前の平均は約1,074件、介入後の平均は約1,105件であった。#7119の導入後の方が、月あたり約31件多い という結果である(P = 0.011)。
「#7119を始めたら、かえって救急搬送が増えた」と報告してしまいそうになる。しかし疑似データには、#7119によって搬送が 減る 効果を入れてある。この逆転が起きたのは、もともとの増加傾向(月3件ずつ増える)を無視したからである。ダイエットの例とちょうど逆向きの失敗だ。
加えて、このt検定は自己相関も季節性も無視しているので、P値そのものも信用できない。
Step 4:介入前の期間だけで定常性を確認する(ADF×KPSS)
罠⑤に従い、介入前の48か月だけ を取り出して、ADF-KPSS記事と同じ手順で定常性を確認する。介入前は右肩上がりなので、どちらもトレンド項を入れた型で検定する(adf.test() は常にトレンド項入り、kpss.test() は null = "Trend" を指定)。
pre <- subset(d, level == 0)
adf.test(pre$calls)
kpss.test(pre$calls, null = "Trend")
Dickey-Fuller = -4.8327, Lag order = 3, p-value = 0.01
KPSS Trend = 0.034537, Truncation lag parameter = 3, p-value = 0.1ADF検定は単位根を棄却し(P ≤ 0.01。tseries は0.01未満のP値を0.01と表示する)、KPSS検定はトレンド定常を棄却しなかった(P ≥ 0.10)。ADF-KPSS記事の判定表に当てはめると、2人の裁判官の意見が「トレンド定常」で一致 する。介入前の系列を「直線トレンド+定常な揺らぎ」とみなしてセグメント回帰を行うことに、大きな問題はなさそうである。
注意:48点という系列は、単位根検定には短い部類である。実際、月ダミーで季節性を除いた残差で検定し直すと、ADF検定は単位根を棄却できず(P = 0.41)、KPSS検定も棄却しない「判断保留」になった。短い系列では、検定の結果だけで白黒をつけず、グラフやコレログラム、分野の知識と合わせて判断してほしい。
Step 5:セグメント回帰(OLS)
いよいよITSの本体である。第2章の式に、季節性を調整するための月ダミー(factor(month))を加えて、まずは通常の最小二乗法(OLS)で当てはめる。
m_ols <- lm(calls ~ time + level + time_after + factor(month), data = d)
round(coef(summary(m_ols))[2:4, ], 4)
Estimate Std. Error t value Pr(>|t|)
time 2.6339 0.2733 9.6361 0
level -56.5672 10.7990 -5.2382 0
time_after -1.6677 0.3803 -4.3852 0(Pr(>|t|) の0は、小数第4位で丸めた結果であり、いずれも P < 0.001 という意味である)
time(β1=介入前の傾き):月あたり約 +2.6件level(β2=水準の変化):介入直後に約 −57件 の段差time_after(β3=傾きの変化):傾きが月あたり約 −1.7件 小さくなった
Step 3とは違い、「#7119の導入後に搬送は減った」という、設定どおりの方向の結果になった。もともとの増加傾向を「介入前の傾き」として分けて推定したからである。
ただし、この標準誤差は、まだ罠②(自己相関)を無視したOLSのものである。
Step 6:残差の自己相関を確認する
OLSの残差に自己相関が残っていないかを、コレログラムで確認する。
acf(resid(m_ols), lag.max = 24,
    main = "Correlogram of residuals (segmented regression, OLS)")
round(acf(resid(m_ols), lag.max = 3, plot = FALSE)$acf[2:4], 2)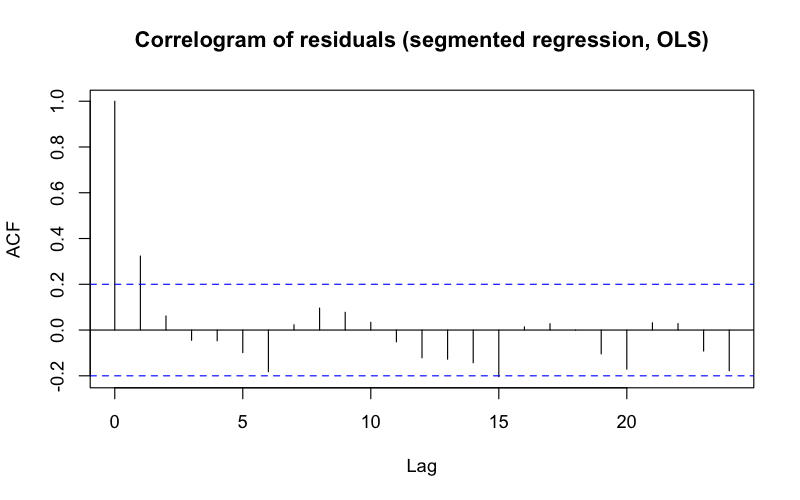
[1] 0.32 0.06 -0.04月ダミーを入れたので季節の波は消えているが、ラグ1に約0.32の自己相関 が残り、青い点線の範囲をはみ出している。ラグ2以降はほぼ0である。「前月のクセを1か月分だけ引きずる」という、AR(1)に近いパターンである。
Durbin-Watson検定でも確認しておく。
dwtest(m_ols)DW = 1.3165, p-value = 0.000246
alternative hypothesis: true autocorrelation is greater than 0DW統計量は、自己相関がなければ2に近く、正の自己相関があると2より小さくなる。ここでは1.32で、正の自己相関があると判定された(P < 0.001)。
注意:Turner et al.(2021)は、Durbin-Watson検定は 系列が長く、自己相関が大きい場合を除いて、自己相関の検出力が低い ことを示し、この検定に頼るべきではないとしている。「DW検定で有意でなかったから、自己相関はない」と判断するのは危険である。コレログラムとあわせて見て、迷ったら自己相関を考慮したモデルを使う方が安全である。
Step 7:自己相関を考慮したセグメント回帰(GLS+AR(1)、REML)
nlme パッケージの gls() で、誤差にAR(1)の自己相関を仮定したセグメント回帰を行う。correlation = corAR1(form = ~ time) が「前の月の誤差を引きずる」という指定であり、推定法には Turner et al.(2021)で推奨されているREMLを使う。
m_gls <- gls(calls ~ time + level + time_after + factor(month), data = d,
             correlation = corAR1(form = ~ time), method = "REML")
round(summary(m_gls)$tTable[2:4, ], 4)
round(intervals(m_gls, which = "coef")$coef[2:4, ], 2)
coef(m_gls$modelStruct$corStruct, unconstrained = FALSE)   # AR(1)係数
Value Std.Error t-value p-value
time 2.6825 0.3997 6.7117 0.0000
level -56.3415 15.3333 -3.6744 0.0004
time_after -1.7703 0.5695 -3.1083 0.0026
lower est. upper
time 1.89 2.68 3.48
level -86.85 -56.34 -25.83
time_after -2.90 -1.77 -0.64
Phi
0.3814738 OLS(Step 5)と比べてみよう。
| OLS:推定値(標準誤差) | GLS+AR(1):推定値(標準誤差) | 疑似データの真の値 | |
|---|---|---|---|
| 介入前の傾き β1 | 2.63(0.27) | 2.68(0.40) | 3 |
| 水準の変化 β2 | −56.6(10.8) | −56.3(15.3) | −60 |
| 傾きの変化 β3 | −1.67(0.38) | −1.77(0.57) | −2 |
推定値はほとんど変わらないが、標準誤差は1.4〜1.5倍に広がった。OLSは、「仲良しグループ」を独立な票として数えていたぶん、推定の確かさを過大に見積もっていたのである。
GLSの結果、水準の変化は −56.3件(95%信頼区間 −86.9〜−25.8)、傾きの変化は月あたり −1.77件(95%信頼区間 −2.90〜−0.64)と推定された。どちらの区間も0を含まない。
ここで、β3の読み方に注意してほしい。β3は 傾きの「変化」 であり、介入後の傾きそのものではない。介入後の傾きは β1 + β3 で求める。点推定値は足し算で出せるが、95%信頼区間には2つの係数の共分散も必要なので、vcov() を使って計算する。
# 介入後の傾き(β1 + β3)と95%信頼区間
b_gls  <- coef(m_gls)
w_post <- setNames(rep(0, length(b_gls)), names(b_gls))
w_post[c("time", "time_after")] <- 1
post_slope <- sum(w_post * b_gls)
post_se    <- sqrt(drop(t(w_post) %*% vcov(m_gls) %*% w_post))
round(c(slope = post_slope,
        lower = post_slope - 1.96 * post_se,
        upper = post_slope + 1.96 * post_se), 2)
slope lower upper
0.91 0.13 1.70介入後の傾きは β1 + β3 ≈ 2.68 − 1.77 = 月あたり約+0.9件(95%信頼区間 0.13〜1.70)である。つまり、#7119の導入後も搬送件数は 増え続けているが、増え方が月3件弱から月1件弱に鈍った というのが正しい解釈である。「導入後は毎月1.8件ずつ減っている」と読むのは誤りだ。
推定されたAR(1)係数(Phi)は0.38で、疑似データに仕込んだ真の値0.5より小さかった。乱数1回分の結果なので断定はできないが、Turner et al.(2021)が示した「自己相関はどの方法でも過小評価されがち」という報告と整合的である。GLSの信頼区間でさえ、実際にはやや狭すぎる可能性がある ことを頭に入れておきたい。
参考:Newey-West標準誤差
OLSの推定値はそのままに、標準誤差だけを自己相関に頑健なものに差し替える方法もある。経済学などでよく使われる Newey-West標準誤差 である。round(coeftest(m_ols, vcov = NeweyWest(m_ols, lag = 3, prewhite = FALSE))[2:4, ], 4) # Estimate Std. Error t value Pr(>|t|) # time 2.6339 0.2867 9.1878 0e+00 # level -56.5672 9.7766 -5.7860 0e+00 # time_after -1.6677 0.4533 -3.6794 4e-04このデータでは、水準の変化の標準誤差がOLSよりもむしろ小さくなった(10.8 → 9.8)。Newey-West標準誤差は大標本を前提とした方法であり、96点程度の系列では自己相関を十分に反映できないことがある。Turner et al.(2021)でも、12点以上の系列ではREMLが推奨されている。
Step 8:反事実と比べて、効果を具体的な数字で語る
最後に、ITSの核心である 反事実の線 を描く。level と time_after を0にしたデータで予測すれば、「#7119がなかった場合の延長線」が得られる。
cf <- d
cf$level      <- 0
cf$time_after <- 0
d$fit <- predict(m_gls)                  # モデルの当てはめ値
d$cf  <- predict(m_gls, newdata = cf)    # #7119がなかった場合の予測(反事実)

plot(d$time, d$calls, pch = 16, cex = 0.6, col = "grey40", xaxt = "n",
     xlab = "Year", ylab = "Ambulance transports (per month)",
     main = "Observed, fitted, and counterfactual",
     ylim = c(900, max(c(d$calls, d$cf))))
axis(1, at = seq(1, 96, by = 12), labels = 2018:2025)
lines(d$time, d$fit, col = "blue", lwd = 2)
lines(d$time[d$level == 1], d$cf[d$level == 1], col = "red", lwd = 2, lty = 2)
abline(v = 48.5, lty = 3)
legend("bottomright",
       c("Observed", "Fitted (GLS)", "Counterfactual (no #7119)"),
       col = c("grey40", "blue", "red"), pch = c(16, NA, NA),
       lty = c(NA, 1, 2), lwd = c(NA, 2, 2), bty = "n", cex = 0.85)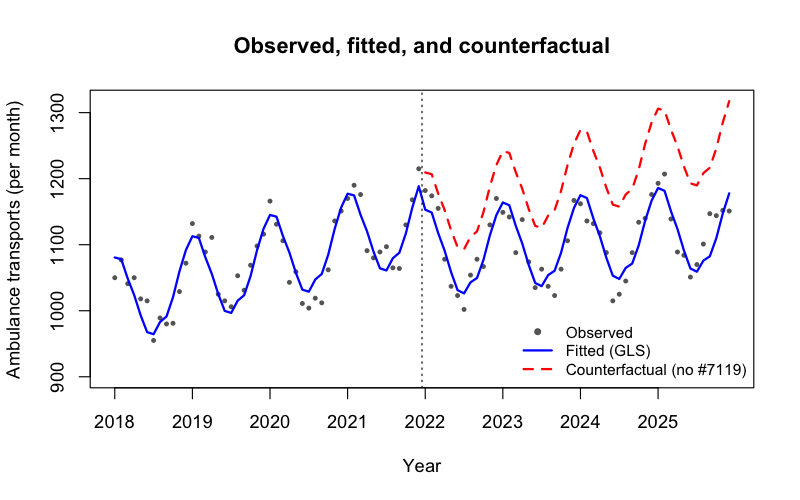
青い実線が実際のデータに当てはめたモデル、赤い点線が「#7119がなかった世界」の延長線である。2本の線の 隙間 が、#7119の効果の推定値である。介入直後の段差が、時間とともに開いていく様子がわかる。
隙間の大きさを数字で出すには、介入から k か月後の効果 β2 + β3 × k と、その95%信頼区間を計算する。反事実に対する相対変化もあわせて示す。
effect_at <- function(model, data, k) {
  b <- coef(model)
  V <- vcov(model)
  w <- setNames(rep(0, length(b)), names(b))
  w["level"] <- 1
  w["time_after"] <- k
  est <- sum(w * b)                          # β2 + β3 × k
  se  <- sqrt(drop(t(w) %*% V %*% w))        # その標準誤差
  row <- which(data$level == 1 & data$time_after == k)
  data.frame(month    = sprintf("%d-%02d", data$year[row], data$month[row]),
             effect   = round(est, 1),
             lower    = round(est - 1.96 * se, 1),
             upper    = round(est + 1.96 * se, 1),
             relative = paste0(round(100 * est / data$cf[row], 1), "%"))
}
do.call(rbind, lapply(c(0, 12, 23), function(k) effect_at(m_gls, d, k)))
month effect lower upper relative
1 2022-01 -56.3 -86.4 -26.3 -4.7%
2 2023-01 -77.6 -110.7 -44.5 -6.2%
3 2023-12 -97.1 -136.9 -57.2 -7.7%(信頼区間は正規近似(±1.96×標準誤差)で計算しているため、Step 7の intervals()(t分布に基づく)とはわずかに異なる)
注意:相対変化(%)の分母は、その月の反事実の値である。反事実には季節の波が含まれるので、同じ件数の差でも、分母が大きい冬の月では%が小さく、分母が小さい夏の月では%が大きくなる。%を報告するときは、どの月の値か を必ず添えてほしい。
これで、結果を現場の言葉に翻訳できる。
#7119の導入直後(2022年1月)、救急搬送件数は反事実と比べて月あたり約56件(約4.7%)少なかった。その差は時間とともに広がり、導入から24か月目(2023年12月)には月あたり約97件(95%信頼区間 57〜137件、約7.7%)少ないと推定された。
P値だけを報告するのではなく、「何件(何%)減ったか」を信頼区間とともに示す ことが大切である。P値は「偶然とは考えにくいか」を判断する材料にすぎず、効果の大きさを表すものではない。
注意:反事実の延長線は、「介入前のトレンドが、介入がなければそのまま続いた」という仮定に立っている。介入から時間がたつほど、この仮定は不確かになる。本記事で効果を示したのを24か月目までにとどめたのはそのためである。遠い将来まで延長線を伸ばして「5年後には◯件減った」と語るのは、慎重であるべきだ。
※コラム:ITSの結果を「因果」と呼んでよいか
今回の疑似データには #7119 以外の出来事を入れていないので、推定値は設定した効果に近くなった。しかし実際のデータでは、罠④の共介入を否定できない限り、「#7119によって減った」と断定するのは言い過ぎである。論文では「#7119の導入 と関連して 減少した(was associated with)」と書き、共介入の可能性を限界(Limitations)で議論するのが誠実である。対照系列を用意できるなら、CITSへ進むことで、この弱点を補強できる。
6. 論文でそのまま使える英文テンプレート
以下の数値は、本記事の疑似データを実際に解析した結果である。自分のデータに使うときは、[ ]内を必ず自分の解析結果に置き換えてほしい。
Methods
We conducted an interrupted time series analysis to evaluate changes in [monthly ambulance transports] associated with the introduction of [the emergency telephone consultation service (#7119)] in [January 2022]. Data from [January 2018] to [December 2025] ([48] months before and [48] months after the introduction) were analysed using segmented regression (Wagner et al., 2002), which included terms for the pre-intervention trend, the change in level immediately after the intervention, and the change in slope after the intervention. The expected form of the effect (a change in both level and slope) was specified a priori. Seasonality was adjusted for by including calendar month as a categorical variable. Stationarity of the pre-intervention series was assessed using the augmented Dickey–Fuller and Kwiatkowski–Phillips–Schmidt–Shin tests. Autocorrelation was assessed using the autocorrelation function of the residuals, and the final model was fitted by generalized least squares with a first-order autoregressive error structure, estimated by restricted maximum likelihood (Turner et al., 2021). Absolute and relative effects were estimated by comparing the fitted values with the counterfactual values predicted from the pre-intervention trend. All analyses were performed using R version [4.6.1] with the nlme package.
(和訳の要点:ITSデザインであること、期間と介入時点、セグメント回帰の3つの項、効果の形を事前に決めたこと、月ダミーによる季節性の調整、介入前の定常性の確認、残差の自己相関の確認とGLS+AR(1)(REML)、反事実との比較で効果を表したこと)
Results
Before the introduction of [#7119], [monthly ambulance transports] increased by [2.7] transports per month (95% CI, [1.9] to [3.5]). The residuals of the segmented regression showed positive first-order autocorrelation (lag-1 autocorrelation, [0.32]). After the introduction, there was an immediate decrease in level of [56.3] transports per month (95% CI, [25.8] to [86.9]) and a decrease in slope of [1.77] transports per month (95% CI, [0.64] to [2.90]), resulting in a post-intervention trend of [0.91] transports per month (95% CI, [0.13] to [1.70]). At [24] months after the introduction, the number of transports was estimated to be [97.1] per month (95% CI, [57.2] to [136.9]) lower than expected in the absence of the intervention, corresponding to a relative reduction of [7.7]%.
査読者に「なぜ前後比較ではなくITSなのか」と聞かれたときの一文
A simple before–after comparison would have been biased by the underlying increasing trend in ambulance transports; the interrupted time series design accounts for this pre-existing trend by using it to estimate the counterfactual.
限界(Limitations)の記述例
As with all single-series interrupted time series studies, we cannot exclude the possibility that other events occurring around the time of the intervention contributed to the observed changes.
まとめ
- 時系列解析で迷ったら、手法の名前からではなく「何を知りたいか」から選ぶ。
- 一貫して増えているか → Mann-Kendall検定+Sen’s slope
- 系列の性質を知る(どの道でも役立つ健康診断) → ADF検定×KPSS検定
- ある時点の出来事で変わったか → ITS(本記事)
- 同時期の別の出来事と切り分けたい → CITS
- 将来を予測したい → ARIMAなど
- ITSは、介入前のトレンドの延長線(反事実)と実際のデータを比べる手法である。セグメント回帰で、効果を 水準の変化(段差) と 傾きの変化 に分けて推定する。β3は傾きの「変化」であり、介入後の傾きは β1 + β3 で読む。
- 介入前後の平均を単純に比べると、もともとのトレンドのせいで 効果の向きさえ逆転する ことがある(Step 3)。
- 季節性は月ダミーなどで調整する。自己相関はコレログラムで確認し、GLS+AR(1)(REML) などで考慮する。Durbin-Watson検定だけに頼らない。
- 定常性は 介入前の期間だけで 確認する。
- 結果は 「何件(何%)減ったか」を信頼区間とともに 語る。共介入を否定できなければ、CITSで補強する。
一括コピペ用Rスクリプト
# ============================================================
# 分割時系列(ITS)解析:#7119導入前後の救急搬送件数(疑似データ)
# ============================================================

# --- パッケージ ---
# install.packages(c("nlme", "lmtest", "sandwich", "tseries"))
library(nlme)
library(lmtest)
library(sandwich)
library(tseries)

# --- Step 1:疑似データの作成(2018年1月〜2025年12月、96か月)---
set.seed(7119)

n     <- 96
time  <- 1:n                              # 時間(1〜96か月目)
month <- rep(1:12, times = 8)             # 月(1〜12)
year  <- rep(2018:2025, each = 12)        # 年

level      <- as.numeric(time >= 49)      # 介入(2022年1月=49か月目以降が1)
time_after <- pmax(0, time - 49)          # 介入後の経過月数(2022年1月が0)

season <- 60 * cos(2 * pi * (month - 1) / 12)                            # 1月ピークの季節の波
noise  <- as.numeric(arima.sim(model = list(ar = 0.5), n = n, sd = 25))  # 自己相関のある誤差

calls <- round(1000 + 3 * time - 60 * level - 2 * time_after + season + noise)

d <- data.frame(year, month, time, level, time_after, calls)
calls_ts <- ts(calls, start = c(2018, 1), frequency = 12)

# --- Step 2:介入線を入れた時系列グラフ ---
plot(calls_ts, type = "o", pch = 16, cex = 0.6,
     xlab = "Year", ylab = "Ambulance transports (per month)",
     main = "Monthly ambulance transports")
abline(v = 2022, col = "red", lty = 2)

# --- Step 3:【ダメな例】介入前後の平均を比べる ---
t.test(calls ~ level, data = d)

# --- Step 4:介入前の期間だけで定常性を確認(ADF×KPSS)---
pre <- subset(d, level == 0)
adf.test(pre$calls)
kpss.test(pre$calls, null = "Trend")

# --- Step 5:セグメント回帰(OLS、月ダミーで季節性を調整)---
m_ols <- lm(calls ~ time + level + time_after + factor(month), data = d)
round(coef(summary(m_ols))[2:4, ], 4)

# --- Step 6:残差の自己相関を確認 ---
acf(resid(m_ols), lag.max = 24,
    main = "Correlogram of residuals (segmented regression, OLS)")
round(acf(resid(m_ols), lag.max = 3, plot = FALSE)$acf[2:4], 2)
dwtest(m_ols)

# --- Step 7:自己相関を考慮したセグメント回帰(GLS、AR(1)、REML)---
m_gls <- gls(calls ~ time + level + time_after + factor(month), data = d,
             correlation = corAR1(form = ~ time), method = "REML")
round(summary(m_gls)$tTable[2:4, ], 4)
round(intervals(m_gls, which = "coef")$coef[2:4, ], 2)
coef(m_gls$modelStruct$corStruct, unconstrained = FALSE)   # AR(1)係数

# 介入後の傾き(β1 + β3)と95%信頼区間
b_gls  <- coef(m_gls)
w_post <- setNames(rep(0, length(b_gls)), names(b_gls))
w_post[c("time", "time_after")] <- 1
post_slope <- sum(w_post * b_gls)
post_se    <- sqrt(drop(t(w_post) %*% vcov(m_gls) %*% w_post))
round(c(slope = post_slope,
        lower = post_slope - 1.96 * post_se,
        upper = post_slope + 1.96 * post_se), 2)

# 参考:Newey-West標準誤差
round(coeftest(m_ols, vcov = NeweyWest(m_ols, lag = 3, prewhite = FALSE))[2:4, ], 4)

# --- Step 8:反事実と比べて効果を語る ---
cf <- d
cf$level      <- 0
cf$time_after <- 0
d$fit <- predict(m_gls)                  # モデルの当てはめ値
d$cf  <- predict(m_gls, newdata = cf)    # #7119がなかった場合の予測(反事実)

plot(d$time, d$calls, pch = 16, cex = 0.6, col = "grey40", xaxt = "n",
     xlab = "Year", ylab = "Ambulance transports (per month)",
     main = "Observed, fitted, and counterfactual",
     ylim = c(900, max(c(d$calls, d$cf))))
axis(1, at = seq(1, 96, by = 12), labels = 2018:2025)
lines(d$time, d$fit, col = "blue", lwd = 2)
lines(d$time[d$level == 1], d$cf[d$level == 1], col = "red", lwd = 2, lty = 2)
abline(v = 48.5, lty = 3)
legend("bottomright",
       c("Observed", "Fitted (GLS)", "Counterfactual (no #7119)"),
       col = c("grey40", "blue", "red"), pch = c(16, NA, NA),
       lty = c(NA, 1, 2), lwd = c(NA, 2, 2), bty = "n", cex = 0.85)

# 介入からkか月後の効果(β2 + β3 × k)と95%信頼区間、反事実に対する相対変化
effect_at <- function(model, data, k) {
  b <- coef(model)
  V <- vcov(model)
  w <- setNames(rep(0, length(b)), names(b))
  w["level"] <- 1
  w["time_after"] <- k
  est <- sum(w * b)
  se  <- sqrt(drop(t(w) %*% V %*% w))
  row <- which(data$level == 1 & data$time_after == k)
  data.frame(month    = sprintf("%d-%02d", data$year[row], data$month[row]),
             effect   = round(est, 1),
             lower    = round(est - 1.96 * se, 1),
             upper    = round(est + 1.96 * se, 1),
             relative = paste0(round(100 * est / data$cf[row], 1), "%"))
}
do.call(rbind, lapply(c(0, 12, 23), function(k) effect_at(m_gls, d, k)))
関連記事
- 時系列データの「増えている」をRで判定する方法|Mann-Kendall検定とSen’s slope
- 時系列データの定常性をRで判定する方法|ADF検定とKPSS検定の組み合わせ方
- Comparative Interrupted Time Series とは何か どんな時に使うのが良いか わかりやすく解説
- Rで時系列データ分析を行う方法
参考文献
- Wagner AK, Soumerai SB, Zhang F, Ross-Degnan D. Segmented regression analysis of interrupted time series studies in medication use research. Journal of Clinical Pharmacy and Therapeutics. 2002;27(4):299–309. https://doi.org/10.1046/j.1365-2710.2002.00430.x
- Lopez Bernal J, Cummins S, Gasparrini A. Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology. 2017;46(1):348–355. https://doi.org/10.1093/ije/dyw098 (Corrigendum: International Journal of Epidemiology. 2020;49(4):1414. https://doi.org/10.1093/ije/dyaa118 /データとRコード:https://github.com/gasparrini/2017_lopezbernal_IJE_codedata )
- Lopez Bernal J, Cummins S, Gasparrini A. The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology. 2018;47(6):2082–2093. https://doi.org/10.1093/ije/dyy135
- Kontopantelis E, Doran T, Springate DA, Buchan I, Reeves D. Regression based quasi-experimental approach when randomisation is not an option: interrupted time series analysis. BMJ. 2015;350:h2750. https://doi.org/10.1136/bmj.h2750
- Turner SL, Forbes AB, Karahalios A, Taljaard M, McKenzie JE. Evaluation of statistical methods used in the analysis of interrupted time series studies: a simulation study. BMC Medical Research Methodology. 2021;21:181. https://doi.org/10.1186/s12874-021-01364-0
- Barone-Adesi F, Gasparrini A, Vizzini L, Merletti F, Richiardi L. Effects of Italian smoking regulation on rates of hospital admission for acute coronary events: a country-wide study. PLoS One. 2011;6(3):e17419. https://doi.org/10.1371/journal.pone.0017419
- Schaffer AL, Dobbins TA, Pearson SA. Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: a guide for evaluating large-scale health interventions. BMC Medical Research Methodology. 2021;21:58. https://doi.org/10.1186/s12874-021-01235-8
- Perron P. The great crash, the oil price shock, and the unit root hypothesis. Econometrica. 1989;57(6):1361–1401. https://www.jstor.org/stable/1913712
おすすめ書籍
時系列解析の土台を固めたい人向けに、Rで学べる入門書と、無料で読める実践的な教科書を紹介する。
1. 馬場真哉『時系列分析と状態空間モデルの基礎:RとStanで学ぶ理論と実装』(プレアデス出版)
自己相関、定常性、ARIMAといった時系列分析の基本を、Rのコードとともに一から学べる。本記事で使った「コレログラム」「AR(1)」を、もう一歩深く理解したい人の最初の1冊に向いている。
👉 https://www.amazon.co.jp/dp/4903814874
2. Hyndman RJ, Athanasopoulos G. Forecasting: Principles and Practice, 3rd ed.(無料のWeb版)
季節性の扱い、回帰モデルの残差の自己相関、ARIMAを、実データで実践的に学べる教科書である。Web上で全文を無料で読める。ARIMAを使ったITS(Schaffer et al., 2021)に進みたい人の足がかりにもなる。
👉 https://otexts.com/fpp3/

コメント