「k-means法の使い方は分かったのですが、クラスタ数(k)をいくつに設定すればいいのか分からず、とりあえず3にしています……」
k-means法を学び始めたばかりの人から、こういう相談をよく受ける。関数の使い方自体は簡単なのに、肝心の「kをいくつにするか」という部分だけが、なんとなくの勘に頼りがちになってしまうのである。
実は、この「なんとなく」から抜け出すための、代表的な決め方がいくつか存在する。本記事では、k-means法そのものの考え方をざっくりおさらいしたうえで、クラスタ数kの決め方を3つ、できるだけ数式を使わずに比喩で解説する。
1. そもそもk-means法は何をしているのか
k-means法は、次の2つの動きを繰り返しているだけの、意外とシンプルな手法である。
- 各データ点を、一番近い「グループの中心」に割り当てる
- 割り当てが終わったら、そのグループの中心を、メンバーの平均位置に引っ越しさせる
これを、グループの中心がほとんど動かなくなるまで繰り返す。
比喩で言えば、新学期に「なんとなく近くにいる人同士」でグループを作り、いったん各グループの真ん中に立ってみて、「自分の一番近くにいる中心のグループに移動していいよ」ともう一度声をかけ直す、という作業を何度も繰り返して落ち着かせていくようなものである。最初はバラバラだった立ち位置も、繰り返すうちに自然と「近い者同士」のまとまりに収束していく。
ただし、この方法にはあらかじめ「グループをいくつ作るか(k)」を自分で決めて教えてあげる必要がある。ここで多くの初学者が悩むことになる。
2. クラスタ数kの決め方①:エルボー法(肘で見る方法)
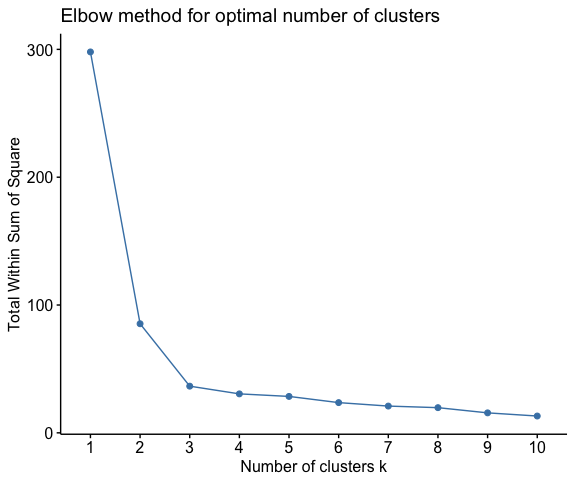
クラスタ数を増やせば増やすほど、各グループの「まとまりの良さ」(クラスタ内の分散の合計、WCSS:Within-Cluster Sum of Squares。各データ点が自分のグループの中心からどれだけ離れているかを、全データ分足し合わせたもので、値が小さいほど各グループがぎゅっとまとまっていることを意味する)はどんどん改善していく。しかし、その改善効果は、あるところから急に鈍くなる。
これは、ダイエットの体重減少カーブに似ている。最初の1週間は面白いように体重が落ちるが、途中からは同じ努力をしてもなかなか減らなくなる。この「効果が急に鈍くなる地点」こそが、ちょうどいい落としどころである。
kを横軸に、WCSSを縦軸にとってグラフを描くと、最初は右肩下がりに急降下し、あるところから傾きが緩やかになる。そのカーブの折れ曲がり(肘=エルボー)に当たるkを、目安として採用するのがエルボー法である。
※コラム:エルボー法は「目分量」であることに注意
エルボー法は直感的で分かりやすい一方、実際のデータでは肘がはっきり出ないことも多く、どこで折れ曲がっているかの判断が人によってブレやすいという弱点がある。2023年に発表された論文では、この「目視による肘の判断」に理論的な裏付けが乏しいことが指摘されている。エルボー法はあくまで最初のとっかかりとして使い、次に紹介する方法と組み合わせて判断するのが安全である。
3. クラスタ数kの決め方②:シルエット係数(居心地の良さで測る方法)
シルエット係数は、「自分が今いるグループの居心地の良さ」を数値化した指標だとイメージすると分かりやすい。
具体的には、各データ点について「同じグループのメンバーとの距離(近いほど良い)」と「一番近い別グループのメンバーとの距離(遠いほど良い)」を比べる。今のグループの方が明らかに居心地が良ければ、シルエット係数は1に近づき、逆に隣のグループの方がしっくりくるようなら、係数はマイナスに近づく。
この係数の平均値が最も高くなるkを選ぶ、というのがシルエット係数によるクラスタ数の決め方である。エルボー法と違い、「一番良いスコアのk」を機械的に選べる点が扱いやすい。
4. クラスタ数kの決め方③:ギャップ統計量(デタラメなデータと比べる方法)
ギャップ統計量は、少し変わった発想に基づいている。「本当に意味のあるグループ分けができているか」を確かめるために、あえて何の構造もない、デタラメに散らばっただけの偽データを用意し、それに対しても同じようにk-means法をかけてみる。
そのうえで、「本物のデータのまとまり具合」と「デタラメなデータのまとまり具合」を比較する。本物のデータの方がデタラメなデータよりも際立ってまとまりが良ければ、それは「本当に意味のあるクラスタ構造がある」証拠だと考えられる。このまとまりの差(ギャップ)が最大になるkを採用する。
比喩で言えば、「自分のクラスの団結力は本当に強いのか」を確かめるために、あえて全く無関係などこかの寄せ集めグループと比較してみる、というイメージである。差がはっきりしていれば、それは偶然ではなく本物のまとまりだと言える。
5. 【実践Rコード】k-means法とクラスタ数の決定をやってみる
factoextraパッケージのfviz_nbclust()関数を使うと、エルボー法・シルエット係数・ギャップ統計量のいずれも、同じ書き方でグラフ化できる。
Step 1:疑似データの作成と標準化
library(tidyverse)
library(factoextra)
library(cluster)

# 乱数シードの設定
set.seed(123)

# 疑似データの作成(2つの量的変数を持つ、3つの塊があるデータ)
df <- tibble(
  x = c(rnorm(50, mean = 0, sd = 1), rnorm(50, mean = 5, sd = 1), rnorm(50, mean = 2.5, sd = 1)),
  y = c(rnorm(50, mean = 0, sd = 1), rnorm(50, mean = 5, sd = 1), rnorm(50, mean = 6, sd = 1))
)

# k-means法はユークリッド距離に基づくため、変数の単位・スケールを揃える必要がある
# (体重kgと身長cmのように単位が違う変数を混ぜると、値の大きい変数に結果が引っ張られてしまう)
df_scaled <- scale(df)
Step 2:エルボー法でグラフ化
fviz_nbclust(df_scaled, kmeans, method = "wss") +
  labs(title = "Elbow method for optimal number of clusters")
Step 3:シルエット係数でグラフ化
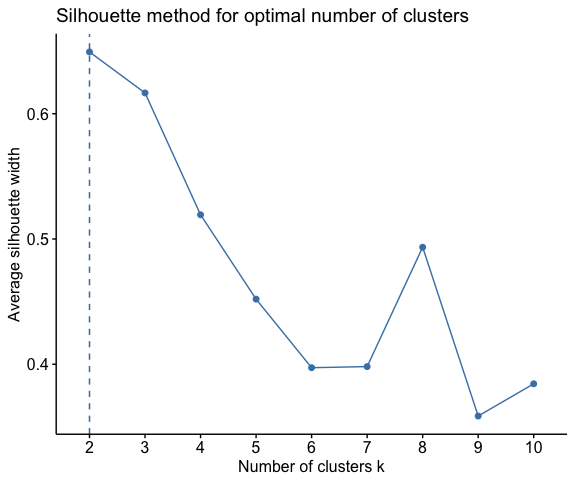
fviz_nbclust(df_scaled, kmeans, method = "silhouette") +
  labs(title = "Silhouette method for optimal number of clusters")
Step 4:ギャップ統計量でグラフ化
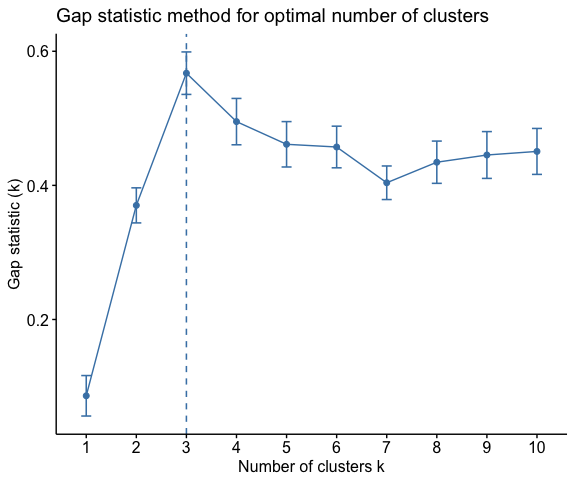
fviz_nbclust(df_scaled, kmeans, method = "gap_stat", nboot = 50) +
  labs(title = "Gap statistic method for optimal number of clusters")
Step 5:決定したkでk-means法を実行
実際に上記の3つのグラフを描いてみると、次のような結果になる。
- エルボー法:k=1→3にかけて急降下し、k=3以降は傾きが緩やかになる。肘はk=3付近にある。
- シルエット係数:平均シルエット幅はk=2で最大(約0.65)となり、k=3(約0.6)よりも高い。factoextraが自動でマークする最適点もk=2を指している。
- ギャップ統計量:k=3で明確なピークを迎えており、最適点もk=3を指している。
つまり、3つの方法が完全に一致するわけではなく、エルボー法とギャップ統計量はk=3を支持し、シルエット係数だけはk=2を最良と判定している。
このような食い違いが起きた理由は、疑似データの作り方に隠れている。3つの塊の中心は(0,0)・(5,5)・(2.5,6)であり、後者2つの中心間の距離は、1つ目の塊との距離に比べてかなり近い。そのため、隣接クラスタとの近さに敏感なシルエット係数は、この2つの塊をまとめて「大きな2つのグループ」と評価しがちになる一方、エルボー法やギャップ統計量は3つという細かい構造を検出できている、と考えられる。
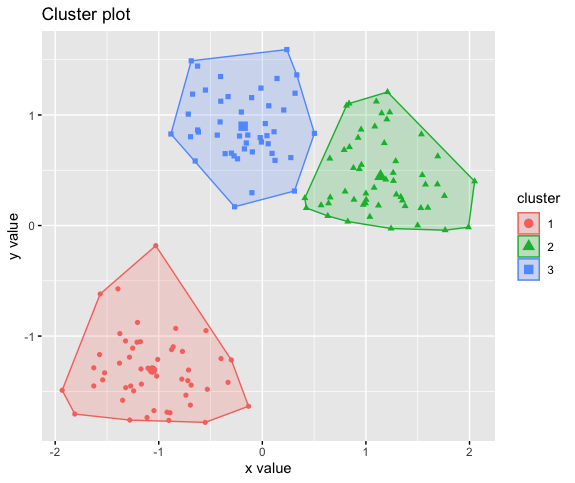
このように1つの方法だけでは判断が割れることがあるからこそ、複数の方法を突き合わせることに意味がある。今回は、3手法のうち2手法(エルボー法・ギャップ統計量)がk=3を支持していること、また疑似データがもともと3つの塊として作られていることを踏まえ、最終的にk=3を採用することとする。
# nstart = 25:初期のグループ分けをランダムに25パターン試し、
# 最もまとまりの良い結果を採用する(最初の立ち位置の運に左右されにくくする)
res_km <- kmeans(df_scaled, centers = 3, nstart = 25)

# 結果の可視化
fviz_cluster(res_km, data = df_scaled, geom = "point", ellipse.type = "convex")
6. 論文でそのまま使える英文テンプレート(Methods & Results)
Methods セクション英文テンプレート
“K-means clustering was performed after standardizing all variables. The optimal number of clusters was assessed using the elbow method, silhouette analysis, and the gap statistic, with the number of random starts set to 25 (nstart = 25) to reduce sensitivity to initial centroid selection.”
Results セクション英文テンプレート
“The elbow method and the gap statistic both indicated three clusters, whereas silhouette analysis indicated two clusters as the optimal solution. Given that two of the three methods converged on three clusters, k-means clustering with k = 3 was performed, yielding clusters that differed significantly in baseline characteristics.”
(上記のクラスタ数等の数値はあくまで記述例であり、実際の解析結果に置き換えて使用されたい。)
7. まとめ&一括コピペ用Rスクリプト
本記事のポイントおさらい
- k-means法は「割り当て」と「重心の引っ越し」を繰り返すだけのシンプルな手法:グループ数kだけは、あらかじめ自分で決めてあげる必要がある。
- エルボー法は直感的だが、肘の判断が目分量になりがち:まず試すには良いが、これだけで決め切らない方がよい。
- シルエット係数は「居心地の良さ」を数値化した指標:スコアが最も高いkを機械的に選べる。
- ギャップ統計量は「デタラメなデータ」と比較してクラスタ構造の妥当性を確かめる方法:機械的に最適なkを算出できる。
- 1つの方法を妄信せず、複数の方法を突き合わせて総合的に判断するのが安全:今回の例では、エルボー法とギャップ統計量はk=3を、シルエット係数はk=2を示すという食い違いが実際に起きた。こうしたときは、多数決や、データの背景知識も踏まえて最終判断を下すことになる。
一括実行用Rスクリプト
# ==============================================================================
# k-means法とクラスタ数決定(エルボー法・シルエット係数・ギャップ統計量)
# 一括実行スクリプト
# パッケージ: tidyverse, factoextra, cluster
# ==============================================================================

library(tidyverse)
library(factoextra)
library(cluster)

# 1. 疑似データの作成と標準化
set.seed(123)
df <- tibble(
  x = c(rnorm(50, mean = 0, sd = 1), rnorm(50, mean = 5, sd = 1), rnorm(50, mean = 2.5, sd = 1)),
  y = c(rnorm(50, mean = 0, sd = 1), rnorm(50, mean = 5, sd = 1), rnorm(50, mean = 6, sd = 1))
)
df_scaled <- scale(df)

# 2. クラスタ数の目安を3つの方法で確認
p_wss <- fviz_nbclust(df_scaled, kmeans, method = "wss") +
  labs(title = "Elbow method for optimal number of clusters")
p_sil <- fviz_nbclust(df_scaled, kmeans, method = "silhouette") +
  labs(title = "Silhouette method for optimal number of clusters")
p_gap <- fviz_nbclust(df_scaled, kmeans, method = "gap_stat", nboot = 50) +
  labs(title = "Gap statistic method for optimal number of clusters")

print(p_wss)
print(p_sil)
print(p_gap)

# 3. 決定したクラスタ数でk-means法を実行
res_km <- kmeans(df_scaled, centers = 3, nstart = 25)

# 4. 結果の可視化
p_cluster <- fviz_cluster(res_km, data = df_scaled, geom = "point", ellipse.type = "convex")
print(p_cluster)
参考文献
おすすめ書籍
Rで学ぶクラスタ解析(新納浩幸 著):k-means法や階層的クラスタリングなどの基本手法を、Rでの実装例とともに解説しており、本記事の内容とも一貫性がある。

コメント