前回の記事では、量的変数と質的変数が混在する患者データに対してFAMDで次元を縮約し、その主成分に対してHCPC(Hierarchical Clustering on Principal Components)で臨床表現型を同定するところまでを解説した。
「先生!HCPC(res_famd, nb.clust = -1)を実行したら、勝手にクラスタ数が3に決まったのですが、なぜ3なのか説明を求められて困っています……」
「別の研究では、症例数が数十万件あるデータでHCPCを実行したところ、いつまで経っても処理が終わらず、最終的にメモリエラーで落ちてしまいました。どうすればよいのでしょうか?」
前回、nb.clust = -1という一行で自動的にクラスタ数が決まる様子を紹介したが、その中身がブラックボックスのままでは、査読者からの「なぜその数なのか」という問いに答えられない。また、大規模な臨床データベースを扱う研究では、HCPCを愚直に実行するとメモリを使い果たしてしまうことがある。
本記事では、HCPCというブラックボックスを開け、その4段階のアルゴリズムを一つずつ確認したうえで、大規模データでハマりやすい罠とその回避策までを徹底解説する。
1. HCPCとは何か? hclust() との違い
Rで階層的クラスタリングと言えばhclust()関数を思い浮かべる人が多いだろう。hclust()は、与えられた変数をすべてそのまま抱えて距離行列を作り、併合を繰り返していく方法である。たとえるなら、荷物の中身を整理しないまま、必要な装備も不要な小物も渾然一体としてぎゅうぎゅうに詰め込んだ、パンパンのバックパックを背負って登山道を登るようなものである。背負っている本人にすら、バックパックの中で何がどれだけかさばっているのか把握できていない状態である。
これに対してHCPCは、その名の通り「主成分(Principal Components)に対して行う階層的クラスタリング」である。FAMDやPCA、MCA、MFAといった主成分法でいったんデータを縮約し、本当に必要な装備だけをコンパクトに整理し直してから登山を始める、というイメージを持つとわかりやすい。パンパンだったバックパックの中身を、かさばる無駄な荷物を減らして機能ごとに小さくまとめ直すことで、同じ登山道でも足取りが軽く、迷いにくくなる。
全変数を生のままhclust()に投入すると、変数間の相関や不要なノイズの影響をそのまま引きずってしまう。HCPCはその手前に「荷物を軽くする」ステップを挟むことで、より安定したクラスタリングを実現している。
※コラム:Ward法とは
HCPCの階層的クラスタリングでは、既定で「Ward法」という連結法が使われる。Ward法は、クラスタを併合するたびに「クラスタ内のばらつき(分散)がどれだけ増えるか」を基準に、その増加が最も小さくなるペアを併合していく方法である。主成分分析が「データの分散を軸として捉える」手法であることと相性がよいため、HCPCではWard法が標準採用されている。なお、
HCPC()は内部的にclusterパッケージのagnes()関数を用いてWard法を実装しており、標準のhclust(method = "ward.D2")とは実装上の細部(距離の更新式など)が異なる場合がある点には留意されたい。
2. HCPCの中身を開ける:4ステップのアルゴリズム
HCPCは、内部的に次の4つのステップを自動的に実行している。この4ステップを理解することが、nb.clust = -1というブラックボックスを開ける鍵になる。
Step① 主成分法の実行:データの型に応じてPCA・MCA・FAMD・MFAのいずれかを実行し、ncp個(既定5)の次元を残す。これが「ノイズ除去・荷物を軽くする」ステップである。
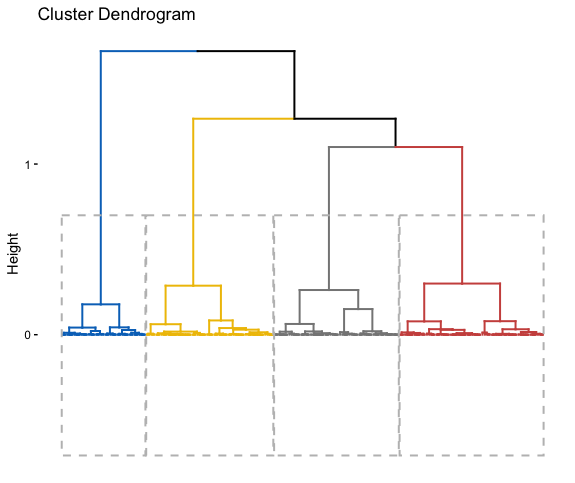
Step② 階層的クラスタリング:残した主成分に対し、Ward法(既定)で階層的クラスタリングを行い、樹形図(デンドログラム)を作る。
Step③ クラスタ数の決定:デンドログラムのどの高さで切るか(=いくつのクラスタに分けるか)を決めるステップである。各分割について「クラスタ内慣性(within-cluster inertia)」の合計を計算し、分割を1つ増やしたときに慣性がどれだけ相対的に減少するかを見る。この相対的な減少幅が最も大きくなる分割が、推奨されるクラスタ数として提案される。nb.clust = -1と指定したときに自動的に決まる数の正体は、これである。(なお、ここでは考え方を平易に説明しており、厳密な計算式についてはFactoMineRの公式実装・ドキュメントを参照されたい。)
Step④ k-meansによる再調整(consolidation):Step③で得られた初期の分割を出発点として、k-meansで各個体の所属を微調整する。既定ではconsol = TRUEになっているため、最終的な結果は「階層的クラスタリング単体の結果」と(わずかに)異なることがある。これは、階層的クラスタリングが一度併合したら後戻りできない性質を持つのに対し、k-meansによる再調整で個体を近い方のクラスタ中心に付け替え直しているためである。なお、この再調整にはiter.max(既定10回)という反復回数の上限が設定されており、k-meansが必ず収束することを保証した手続きではない点にも注意が必要である。
※コラム:「慣性(inertia)」とは
慣性は、統計学における「分散」を多次元に拡張した概念だと考えるとよい。1つの変数の散らばり具合を表すのが分散だとすれば、慣性は複数の主成分軸にまたがったデータ全体の散らばり具合を表す指標である。Step③でいう「クラスタ内慣性」とは、各クラスタの中で個体がどれだけ密集しているかを示しており、この値が小さいほど、まとまりのよいクラスタだと言える。
この4ステップを踏まえると、Step③が「なぜその数のクラスタになったのか」という疑問への回答であり、Step④が「なぜ結果が階層的クラスタリング単体と少しズレるのか」という疑問への回答である、ということになる。
3. 大規模データでハマる罠とkk引数による解決
臨床データベースの症例数が数十万件規模になると、HCPCを既定設定のまま実行すると深刻な問題が生じることがある。階層的クラスタリングは、原理上すべての個体間の距離行列を計算する必要があるため、個体数が$N$のとき、距離行列の要素数はおよそ$N(N-1)/2$個にもなる。症例数が数十万件規模になると、この行列だけで必要なメモリ量が数百GB〜数TB規模に膨れ上がり、メモリ不足でエラーが発生する。実際、Stack Overflow等のQ&Aサイトには、数十万行規模のデータでHCPCを実行しメモリエラーに直面したという利用者の体験談が投稿されている(これは査読付き文献ではなく、あくまで利用者による実体験の報告である点には留意されたい)。
比喩的に言えば、これは「全校生徒全員同士の距離を手作業で測ろうとする」ようなものである。生徒数が増えるほど、測るべき組み合わせの数は生徒数のおよそ2乗のペースで増えていく。
この問題への標準的な解決策が、kk引数である。kk引数を指定すると、HCPCは階層的クラスタリングを行う前に、まずk-meansでkk個の代表点(重み付きの点)を作る。そのうえで、階層的クラスタリングはこのkk個の代表点に対してのみ行われるため、距離行列のサイズが劇的に小さくなる。
# 症例数が非常に多いことを想定し、kk引数で事前にk-means集約を行う例
res_hcpc_big <- HCPC(res_famd, kk = 100, nb.clust = -1, graph = FALSE)
上記のようにkk = 100と指定すれば、まずk-meansで100個の代表点に集約したうえで階層的クラスタリングが行われるため、症例数が数十万件規模であっても現実的な時間・メモリで実行できる。なお、kkを指定した場合はconsolによるk-means再調整は行われない点には注意が必要である。
4. 【実践Rコード】FAMDの続きとしてのHCPC実装
前回のFAMD記事で作成したres_famd(FAMDの実行結果)をそのまま引き継ぐ形で、HCPCの中身を一つずつ確認しながら実装する。
Step 1:HCPCの実行とデンドログラムの確認
library(FactoMineR)
library(factoextra)

# HCPCの実行(クラスタ数は自動判定)
res_hcpc <- HCPC(res_famd, nb.clust = -1, consol = TRUE, graph = FALSE)

# デンドログラムの表示
fviz_dend(res_hcpc, show_labels = FALSE, palette = "jco", rect = TRUE)

# inertia gain(慣性の増分)のバープロットで、推奨カット位置を確認
plot(res_hcpc, choice = "bar")
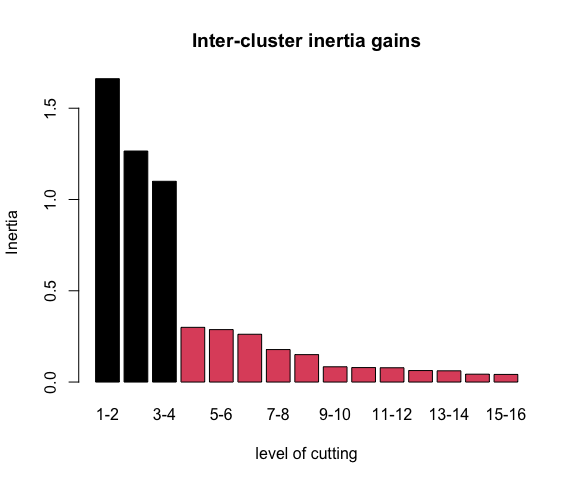
fviz_dend()のデンドログラムと、plot(res_hcpc, choice = "bar")のバープロットを見比べることで、「なぜこの数のクラスタが推奨されたのか」を視覚的に確認できる。バープロットで急激に高さが落ち込む直前の本数が、Step③で説明した「慣性の相対的な減少幅が最大になる分割」に対応している。
Step 2:クラスタ布置の可視化
# 個体(患者)をクラスタごとに色分けして布置を確認
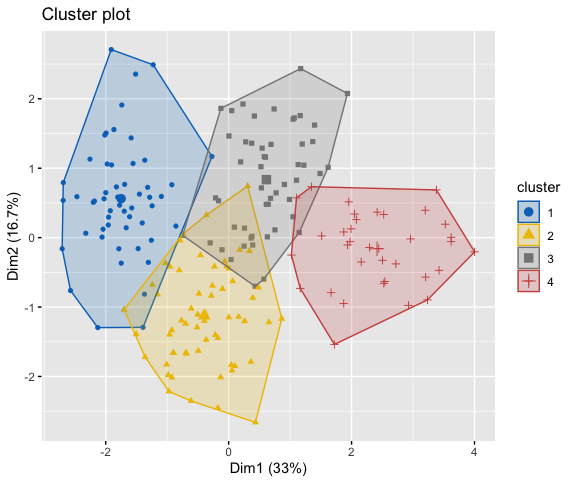
fviz_cluster(res_hcpc, geom = "point", palette = "jco", ellipse.type = "convex")
Step 3:desc.var(catdes)によるクラスタの特徴づけ
クラスタリングして終わりではなく、「そのクラスタが臨床的に何を意味するか」を記述することが、論文としての価値を持たせる上で欠かせない。
# 各クラスタを特徴づける変数の確認
res_hcpc$desc.var

# 各クラスタの主成分軸上での特徴づけ
res_hcpc$desc.axes

# 各クラスタの典型的な個体(パラゴン)の確認
res_hcpc$desc.ind$para
res_hcpc$desc.varは、内部的にcatdes()関数を用いて、量的変数についてはクラスタ間の平均値の検定を、質的変数についてはカテゴリの出現頻度の検定を自動的に行い、統計的に有意にそのクラスタを特徴づけている変数を一覧にしてくれる。ただし、これは変数の数だけ検定を同時に繰り返す多重検定であり、変数の数が多いほど偶然有意になる変数が紛れ込むリスク(第一種の過誤の増大)が高まる。論文で結果を報告する際は、この点に触れたうえで、必要に応じて多重比較の調整や、臨床的な意味づけとの整合性の確認を行うべきである。
結果の読み取り
実際に上記のコードを実行すると、4つのクラスタが得られる(結果表示は省略)。
カテゴリ変数(NYHA)とクラスタの対応:クラスタとNYHA分類の間には統計学的に有意な関連が見られ(P = 2.1×10⁻¹²³)、クラスタ1〜4はそれぞれNYHA I〜IVにCla/Mod・Mod/Claともに100%という形でほぼ完全に一致していた。今回はNYHA自体を重症度の潜在変数から直接生成した疑似データのため、実データでここまで綺麗に一致することは通常ない。この結果は、HCPCが重症度という軸に沿って患者を適切に分離できているかのサニティチェックとして読むのがよい。
量的変数によるクラスタの特徴づけ:クラスタを最も強く判別するのはBNP(Eta2 = 0.68)、次いでBMI(0.33)、年齢(0.08)であった。クラスタ別に見ると、クラスタ1(NYHA I)はBNPが有意に低く(99.4)BMIが有意に高い(29.3)、クラスタ2(NYHA II)はBNPのみ有意に低い(205.9)、クラスタ3(NYHA III)はBNPには有意差がなく年齢が有意に高くBMIが有意に低い、クラスタ4(NYHA IV)はBNPが有意に高く(564.9)年齢も高くBMIが低い、という特徴が見られた。全体としては、BNP上昇・体重減少・高齢化という臨床的に解釈しやすい重症度勾配がうかがえるが、クラスタ3ではBNPが有意な判別変数になっていない点には留意されたい。
主成分軸とパラゴン:res_hcpc$desc.axesではDim.3(Eta2 = 0.89)とDim.1(0.86)がクラスタ分離に最も強く寄与していた。またres_hcpc$desc.ind$paraは各クラスタの重心に最も近い個体(パラゴン)を示しており、その患者IDを実際のカルテと突き合わせれば、代表症例として症例提示に活用できる。
Step 4:k-means再調整による再割当割合の算出
「Results」セクションで報告する「k-means再調整によって階層的クラスタリングの初期分割から再割当された個体の割合」は、consol = TRUE(再調整あり)とconsol = FALSE(再調整なし、階層的クラスタリング単体の結果)を別々に実行し、両者の所属クラスタを比較することで算出できる。
# 再調整あり(既定)
res_hcpc_consol <- HCPC(res_famd, nb.clust = -1, consol = TRUE, graph = FALSE)

# 再調整なし(階層的クラスタリング単体の結果)
res_hcpc_raw <- HCPC(res_famd, nb.clust = -1, consol = FALSE, graph = FALSE)

# 両者の所属クラスタを比較し、再割当された個体の割合を算出
reassigned <- res_hcpc_consol$data.clust$clust != res_hcpc_raw$data.clust$clust
reassign_rate <- mean(reassigned) * 100
cat(sprintf("k-means再調整による再割当率: %.1f%%\n", reassign_rate))
補足:大規模データを想定したkk引数の使用例
kk = 100 という引数を足すことで、事前にk-meansで100個の代表点に集約してから木(デンドログラム)を構築するため、大規模データでも計算負荷を抑えられる。
# 症例数が非常に多い場合を想定したHCPC(kk引数で事前集約)
res_hcpc_big <- HCPC(res_famd, kk = 100, nb.clust = -1, consol = FALSE, graph = FALSE)
5. 論文でそのまま使える英文テンプレート(Methods & Results)
Methods セクション英文テンプレート
“Hierarchical clustering on principal components (HCPC) was performed using Ward’s criterion on the retained FAMD dimensions. The number of clusters was determined based on the relative loss of within-cluster inertia, and the initial partition was subsequently refined using k-means consolidation. Clusters were characterized using quantitative and categorical variable description (catdes).”
Results セクション英文テンプレート
“HCPC identified four clusters based on the maximal relative loss of within-cluster inertia. Following k-means consolidation, none of individuals were reassigned from their initial hierarchical cluster assignment. The resulting clusters differed significantly in baseline age, BMI, BNP levels, and NYHA functional class distribution (P < 0.001).”
(上記のクラスタ数・再割当割合・P値等の数値はあくまで記述例であり、実際の解析結果に置き換えて使用されたい。)
6. まとめ&一括コピペ用Rスクリプト
本記事のポイントおさらい
- HCPCは「主成分に対して行う階層的クラスタリング」:生データのまま
hclust()にかけるのではなく、FAMD/PCAでノイズを落としてから階層的クラスタリングを行う点が本質的な違いである。 nb.clust = -1の正体は「慣性の相対的な減少幅が最大になる分割」の自動検出:ブラックボックスではなく、明確な統計的基準に基づいている。- 最終結果が階層的クラスタリング単体とズレるのは、k-meansによる再調整(
consol)のため:階層的クラスタリングの初期分割を、k-meansで後から微調整している。 - 大規模データでは
kk引数による事前集約が有効:階層的クラスタリングの前にk-meansで代表点を作ることで、距離行列の肥大化によるメモリエラーを回避できる。
一括実行用Rスクリプト
# ==============================================================================
# HCPC(階層的クラスタリング・オン・プリンシパルコンポーネンツ)一括実行スクリプト
# 前提:前回のFAMD記事の res_famd がすでに作成済みであること
# パッケージ: FactoMineR, factoextra
# ==============================================================================

library(FactoMineR)
library(factoextra)

# 1. HCPCの実行(クラスタ数は自動判定、k-means再調整あり)
cat("\n--- HCPC 実行 ---\n")
res_hcpc <- HCPC(res_famd, nb.clust = -1, consol = TRUE, graph = FALSE)

# 2. デンドログラムと inertia gain バープロットの表示
p_dend <- fviz_dend(res_hcpc, show_labels = FALSE, palette = "jco", rect = TRUE)
print(p_dend)
plot(res_hcpc, choice = "bar")

# 3. クラスタ布置の可視化
p_cluster <- fviz_cluster(res_hcpc, geom = "point", palette = "jco", ellipse.type = "convex")
print(p_cluster)

# 4. クラスタの特徴づけ
cat("\n--- クラスタ特徴量の確認 ---\n")
print(res_hcpc$desc.var)
print(res_hcpc$desc.axes)

# 5. 大規模データを想定した kk 引数による事前集約(症例数が非常に多い場合)
res_hcpc_big <- HCPC(res_famd, kk = 100, nb.clust = -1, consol = FALSE, graph = FALSE)
おすすめ書籍
Rで学ぶクラスタ解析(新納浩幸 著):階層的クラスタリングやk-means法などの基本手法に加え、高次元データの次元圧縮手法も扱っており、本記事のテーマと相性がよい。

コメント