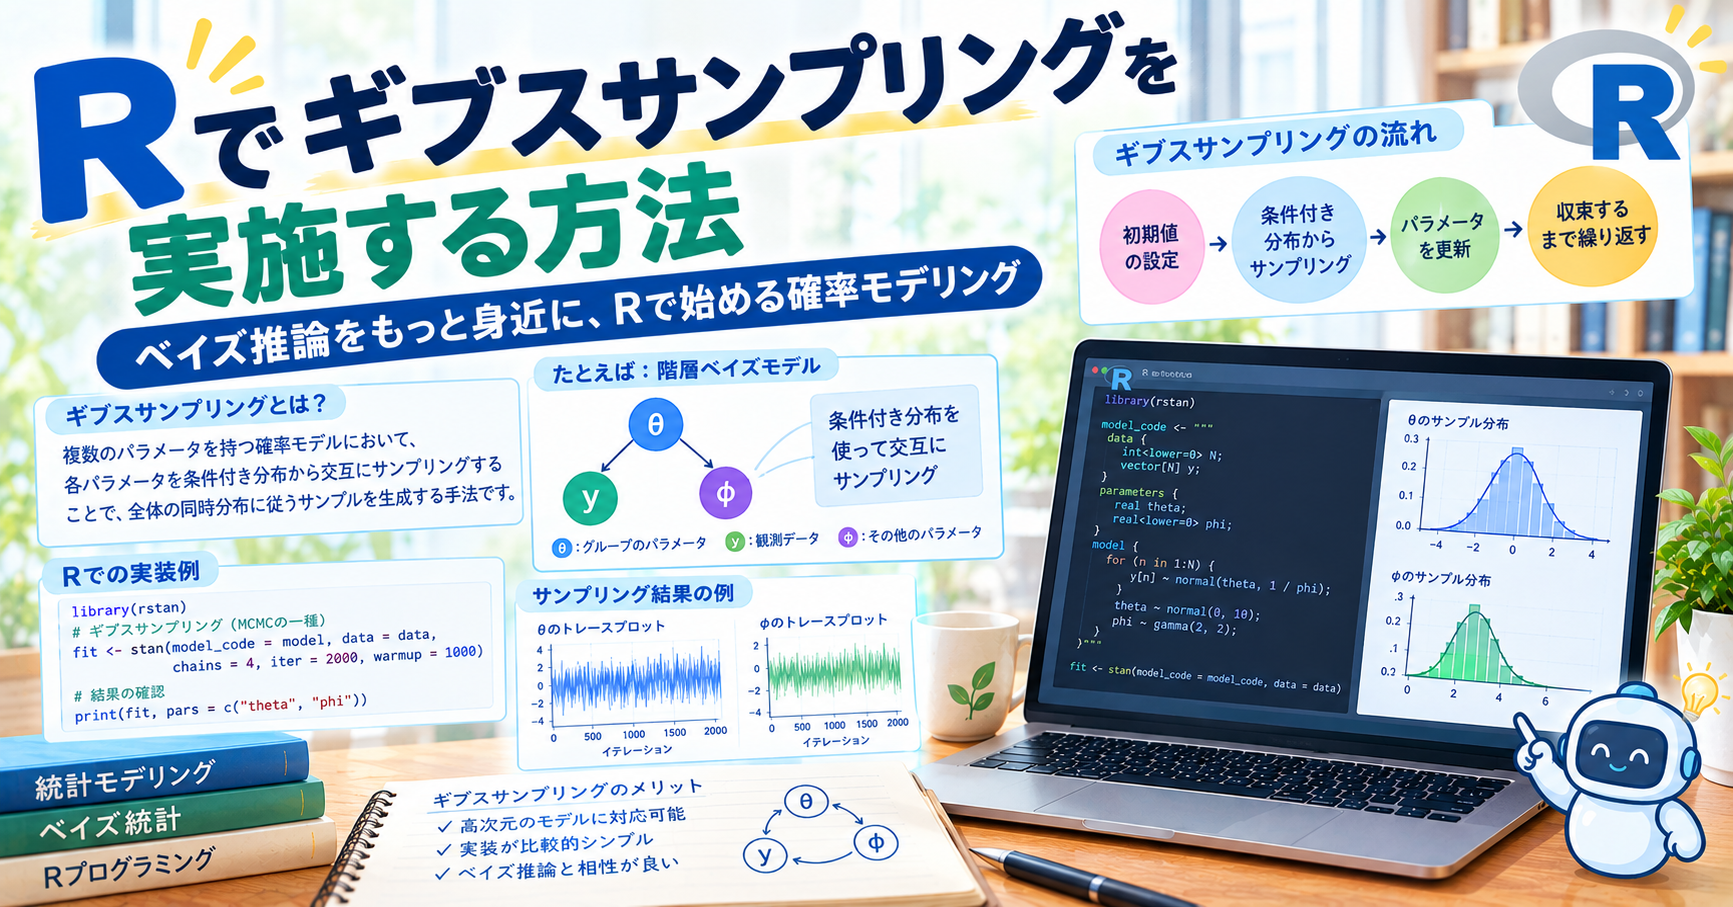
ギブスサンプリングは、MCMC(マルコフ連鎖モンテカルロ法)の一つである。知りたい値が2つ以上あるとき(今回は平均μと分散σ²)、「ほかの値を今の値に固定したときの分布(条件付き分布)」から、1つずつ順番にサンプリングすることを繰り返す。
μを今の値に固定して、σ²を条件付き分布から1つ引く。
引いたσ²に固定して、μを条件付き分布から1つ引く。
1と2を何万回も繰り返す。
繰り返すうちに、(μ, σ²) の組は、2つ同時の事後分布からのサンプルとみなせるようになる(Geman & Geman, 1984; Gelfand & Smith, 1990)。
例えるなら、2人の容疑者の居場所を同時に絞り込むのが難しいとき、「Aの居場所を仮に決めてBを探し、見つかったBの居場所をもとにAを探し直す」ことを繰り返すようなものである。
※コラム:条件付き分布とは? ほかの値をある値に決めたとき、残りの値がどう分布するかを表したもの。今回の例では、σ²を決めればμの分布は正規分布に、μを決めればσ²の分布は逆ガンマ分布になり、どちらもRの関数で簡単に引ける。これがギブスサンプリングを使える条件である。
ギブスサンプリング用のデータの用意
heikinという名前のデータを入力する。
heikin <- c(6.0,10.0,7.6,3.5,1.4,2.5,5.6,3.0,2.2,5.0,
3.3,7.6,5.8,6.7,2.8,4.8,6.3,5.3,5.4,3.3,
3.4,3.8,3.3,5.7,6.3,8.4,4.6,2.8,7.9,8.9)
mean1 <- mean(heikin)
n <- length(heikin)
mean(heikin)
var(heikin)
heikinデータの平均、分散、サンプルサイズは、以下の通り。
> mean(heikin)
[1] 5.106667
> var(heikin)
[1] 4.766161
> length(heikin)
[1] 30
ギブスサンプリングを行うためのパッケージをインストールする
psclパッケージをインストールする。一回だけ。
install.packages("pscl")
psclパッケージを、呼び出す。
library(pscl)
ギブスサンプリングの事前分布の図示
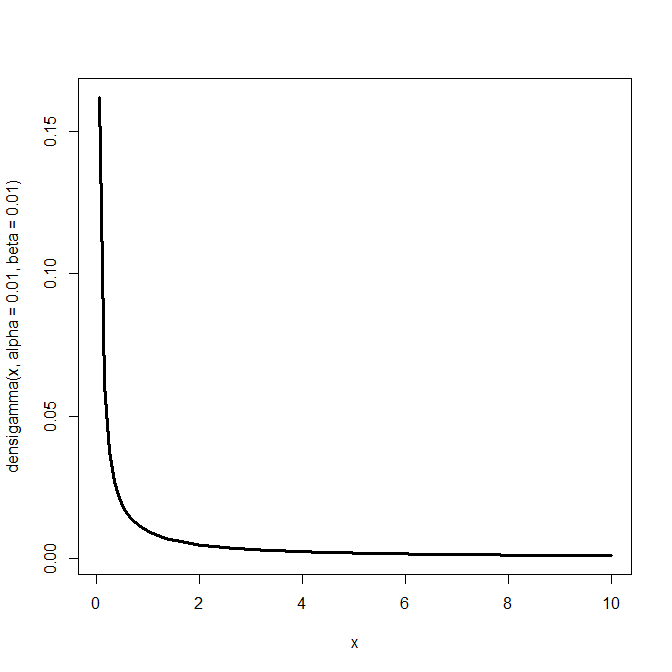
0.05から10まで、0.05刻みの変数xを作る。
alpha=0.01, beta=0.01の逆ガンマ分布を描く。
これが事前分布。
x <- seq(0.05,10,0.05)
curve(densigamma(x,alpha=0.01, beta=0.01),from=0.05,to=10,lwd=3)
ギブスサンプリングのための条件設定
ここで条件設定。
n0 <- 2*0.01
n0S0 <- 2*0.01
S0 <- n0S0/n0
mu0 <- 5
m0 <- 1/4
m1 <- m0+n
n1 <- n0+n
mu1 <- (n*mean1+m0*mu0)/(m0+n)
Q <- sum((heikin-mean1)^2)
n1S1 <- n0S0+Q+m0*n/(m0+n)*(mean1-mu0)^2
μの事前分布は「平均5のあたりだろう」という見立てだが、その重み m0 = 1/4 は、データ0.25個ぶんにすぎない。σ²の事前分布(逆ガンマ分布、alpha = beta = 0.01)も、上記の図のとおりほとんど平らで、情報をほぼ持たない。今回はデータが30個あるので、結果はほとんどデータで決まる。
ただし、データが少ないときや、階層モデルの分散に使うときは、この逆ガンマ分布(0.01, 0.01)が結果に強く影響することが知られている(Gelman, 2006)。事前分布を変えて結果が変わらないか確かめておきたい(感度分析)。
サンプリングのための関数を準備する
分散の事後分布から母分散 $ \sigma^2 $ をサンプリングする関数。
my.sigma2 <- function(mu){
sigma2 <- rigamma(1, alpha=(n1+1)/2, beta=(n1S1+m1*(mu-mu1)^2)/2)
return(sigma2)
}
平均の事後分布から母平均をサンプリングする関数。
my.mu <- function(sigma2){
mu <- rnorm(1, mean=mu1, sd=sqrt(sigma2/m1))
return(mu)
}
モンテカルロ法によるシミュレーション
モンテカルロ シミュレーションを実行する。
my.montecarlo <- function(n_iter){
  set.seed(20110608)
  mu <- 5
  new.mu <- 5
  sigma2 <- 4
  for (i in 1:n_iter){
    new.sigma2 <- my.sigma2(new.mu)
    sigma2 <- sigma2 + new.sigma2
    new.mu <- my.mu(new.sigma2)
    mu <- mu + new.mu
  }
  list("mu"=mu/n_iter, "sigma2"=sigma2/n_iter)
}

my.montecarlo(100000)
10万回サンプリングした結果は以下の通り。
> my.montecarlo(100000)
$`mu`
[1] 5.102863
$sigma2
[1] 4.936363
サンプルを保存するスクリプトを追加してみる。参考書籍の内容ではないが、参考まで。
# ギブスサンプリング(サンプルを保存する版)
my.gibbs <- function(n_iter){
  set.seed(20110608)
  mu_samples <- numeric(n_iter)
  sigma2_samples <- numeric(n_iter)
  mu <- 5 # μの初期値
  for (i in 1:n_iter){
    sigma2 <- my.sigma2(mu) # μを固定して、σ²を引く
    mu <- my.mu(sigma2)     # 引いたσ²を固定して、μを引く
    mu_samples[i] <- mu
    sigma2_samples[i] <- sigma2
  }
  data.frame(mu = mu_samples, sigma2 = sigma2_samples)
}

gibbs_result <- my.gibbs(100000)

# 最初の1000回は、初期値の影響を除くため捨てる(バーンイン)
post <- gibbs_result[-(1:1000), ]

# 事後平均と95%信用区間
colMeans(post)
apply(post, 2, quantile, probs = c(0.025, 0.975))
> # 事後平均と95%信用区間
> colMeans(post)
      mu   sigma2
5.102915 4.936861
> apply(post, 2, quantile, probs = c(0.025, 0.975))
            mu   sigma2
2.5%  4.302879 2.937716
97.5% 5.898537 8.257014
参考までに、同じデータで頻度論の95%信頼区間(t分布)を計算すると、μは約4.29〜5.92で、ギブスサンプリングの95%信用区間(約4.30〜5.90)とほぼ同じになる。事前分布の情報がほとんどないためである。ただし、数値が似ていても意味は別物である。信頼区間は「同じ手順を何度も繰り返せば、そのうち約95%の区間が真の平均を含む」という手順の性質を、信用区間は「今のデータと事前分布のもとで、真の平均がこの範囲にある確率が95%」という確信度を表す。
> # 95%信頼区間(t分布)
> t.test(heikin)$conf.int
[1] 4.291464 5.921870
ギブスサンプリングで得られた事後分布の図示
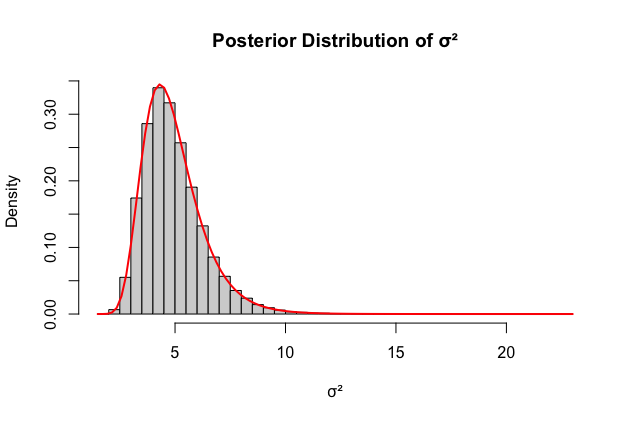
ギブスサンプリングで得られた (μ, σ²) のサンプルを、そのままヒストグラムにすれば、それが事後分布の姿である。式で事後分布を書けなくても、サンプルさえあれば分布の形がわかる。これがMCMCの強みである。
# 事後分布の図示(サンプルのヒストグラム)
# 理論的な事後分布(赤線)を重ねて、サンプリングが正しいことを確かめる
# μの事後分布:自由度 n1、中心 mu1、尺度 sqrt(n1S1/(n1*m1)) の t 分布
hist(post$mu, breaks = 50, freq = FALSE, main = "Posterior Distribution of μ", xlab = "μ")
s_mu <- sqrt(n1S1 / (n1 * m1))
curve(dt((x - mu1) / s_mu, df = n1) / s_mu, add = TRUE, col = "red", lwd = 2)

# σ²の事後分布:形 n1/2、尺度 n1S1/2 の逆ガンマ分布
hist(post$sigma2, breaks = 50, freq = FALSE, main = "Posterior Distribution of σ²", xlab = "σ²")
curve(densigamma(x, alpha = n1/2, beta = n1S1/2), add = TRUE, col = "red", lwd = 2)

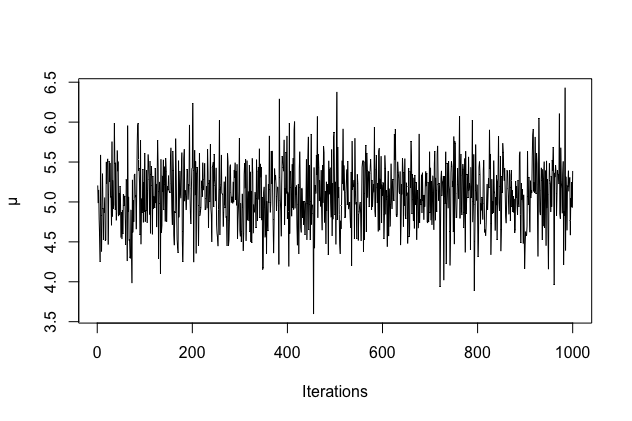
# トレースプロット(最初の1000回)
plot(gibbs_result$mu[1:1000], type = "l", xlab = "Iterations", ylab = "μ")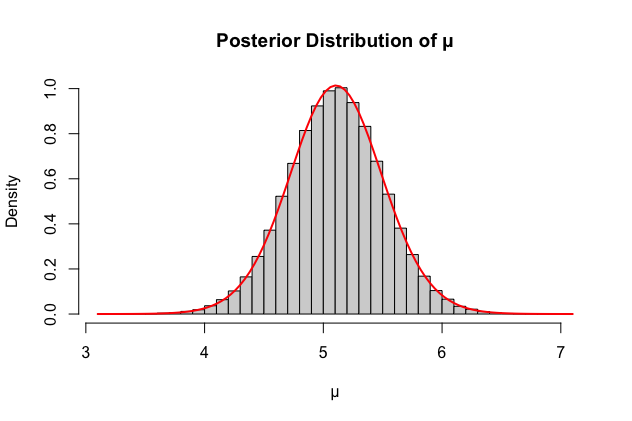
まとめ
ギブスサンプリングは、平均と分散のように知りたい値が複数あるとき、片方を固定してもう片方を条件付き分布から引く、という手順を交互に繰り返す方法である。参考書籍の例をRで再現し、保存したサンプルから事後分布の形と95%信用区間を読み取った。理論式の曲線ともよく一致することを確かめた。
参考書籍
参考文献
Geman S, Geman D. Stochastic relaxation, Gibbs distributions, and the Bayesian restoration of images. IEEE Trans Pattern Anal Mach Intell. 1984;6:721-741. https://ieeexplore.ieee.org/abstract/document/4767596
Gelfand AE, Smith AFM. Sampling-based approaches to calculating marginal densities. J Am Stat Assoc. 1990;85(410):398-409. https://www.tandfonline.com/doi/abs/10.1080/01621459.1990.10476213
Gelman A. Prior distributions for variance parameters in hierarchical models (comment on article by Browne and Draper). Bayesian Analysis. 2006;1(3). https://doi.org/10.1214/06-BA117A

コメント