研究者: 同じBCGワクチンのデータで、
metaforとmetaの両方でメタ回帰をしてみたんです。そうしたら、異質性 $\tau^2$ が 0.0504 と 0.3378 で全然違う結果になって……。metaのメタ回帰は $\tau^2$ を推定し直していない、ということでしょうか?
統計ER: 実はそれ、メタ回帰が実行されていないんです。
metabin()にmodsを書いても、エラーも警告も出ずに無視されてしまいます。metareg()で正しく実行すると、metaforと小数点以下まで同じ結果になりますよ。
メタアナリシスを行うRパッケージとして、meta と metafor は広く使われている。両方を試した人の中には、メタ回帰の結果(標準誤差や $\tau^2$)が食い違って戸惑った経験がある人もいるだろう。
先に結論を述べる。meta の metareg() は、内部で metafor の rma.uni() を呼び出している。したがって、効果量の定義・$\tau^2$ の推定法・検定法の3つが揃っていれば、両者の結果は完全に一致する。結果が違うときは「計算方法の違い」ではなく「設定(またはコード)の違い」を疑えばよい。
本記事はやや細かい話題であるが、両パッケージを行き来する人がつまずきやすい点を、実際にRで答え合わせしながら整理する。
メタ回帰と「2種類の $\tau^2$」
メタ回帰(meta-regression)は、研究ごとの効果量が研究の特性(共変量)によってどう変わるかを調べる手法である。例えば、BCGワクチンの効果が、研究が行われた地域の緯度によって違うかを調べたい、というような場合に用いる。変量効果メタ回帰(混合効果モデル)は次の式で表される。
$$y_i = \beta_0 + \beta_1 x_i + u_i + \varepsilon_i, \qquad u_i \sim N(0, \tau^2), \quad \varepsilon_i \sim N(0, v_i)$$
- $y_i$:研究 $i$ の効果量(ここでは対数オッズ比)、$v_i$:その分散(研究内のばらつき)
- $x_i$:研究の特性(共変量)。ここでは緯度の絶対値
ablat - $\tau^2$:共変量で説明しきれずに残った研究間のばらつき(残差の異質性)
ポイントは、共変量を入れる前と後で $\tau^2$ の意味が変わることである。共変量なしの変量効果モデルの $\tau^2$ は「研究間のばらつき全体」、メタ回帰の $\tau^2$ は「共変量で説明できなかった残りのばらつき」を表す。メタ回帰では、回帰係数とこの残差 $\tau^2$ が同時に推定される。これは metafor でも meta でも同じである。
※コラム:$\tau^2$ が 0.3378 から 0.0504 に減るということ
研究間のばらつきを「教室の騒がしさ」に喩えると、共変量なしの $\tau^2$ は教室全体の騒がしさである。緯度という共変量を入れるのは「窓際の席ほど騒がしい」という法則を見つけるようなもので、その法則で説明できる分を差し引いた残りの騒がしさが残差 $\tau^2$ になる。BCGデータでは $\tau^2$ が 0.3378 から 0.0504 に減り、$(0.3378 – 0.0504)/0.3378 \approx 85\%$ が緯度で説明された。これがmetaforの出力にある $R^2 = 85.06\%$ である。
Step 1:metafor でメタ回帰(rma.uni())
例として、metafor に付属する(正確には metadat パッケージに収録された)BCGワクチンの13研究のデータ dat.bcg を使う(Colditz et al., 1994)。tpos/tneg はワクチン群の結核発症あり/なし、cpos/cneg は対照群の発症あり/なし、ablat は研究地域の緯度の絶対値である。
metafor では、まず escalc() で研究ごとの効果量(対数オッズ比 yi)とその分散(vi)を計算し、rma.uni()(rma() でも同じ)の mods 引数に共変量を指定する。
library(metafor)   # metadat(dat.bcg を含む)も自動で読み込まれる
library(meta)

data(dat.bcg)

dat4metafor <- escalc(measure = "OR", ai = tpos, bi = tneg,
                      ci = cpos, di = cneg, data = dat.bcg,
                      slab = paste0(author, ", ", year))

res_metafor <- rma.uni(yi = yi, vi = vi, data = dat4metafor)
print(res_metafor)
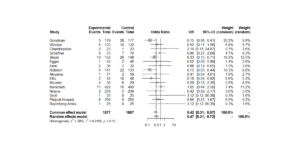
forest(res_metafor, transf = exp)

res_metafor_ablat <- rma.uni(yi = yi, vi = vi, mods = ~ ablat,
                             data = dat4metafor)
print(res_metafor_ablat)
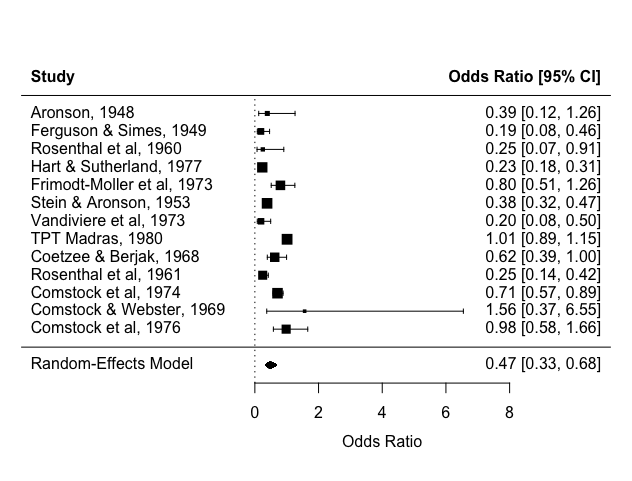
共変量なしのメタアナリシス(フォレストプロット):
メタ回帰の結果:
Mixed-Effects Model (k = 13; tau^2 estimator: REML)

tau^2 (estimated amount of residual heterogeneity):     0.0504 (SE = 0.0449)
tau (square root of estimated tau^2 value):             0.2246
I^2 (residual heterogeneity / unaccounted variability): 57.39%
H^2 (unaccounted variability / sampling variability):   2.35
R^2 (amount of heterogeneity accounted for):            85.06%

Test for Residual Heterogeneity:
QE(df = 11) = 25.0954, p-val = 0.0088

Test of Moderators (coefficient 2):
QM(df = 1) = 25.2424, p-val < .0001

Model Results:

         estimate      se     zval    pval    ci.lb    ci.ub
intrcpt    0.3010  0.2146   1.4025  0.1608  -0.1197   0.7217
ablat     -0.0315  0.0063  -5.0242  <.0001  -0.0438  -0.0192  ***

---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
緯度が1度高くなるごとに対数オッズ比が 0.0315 小さくなる(オッズ比にすると $\exp(-0.0315) \approx 0.97$ 倍)、つまり高緯度の地域ほどワクチンの効果が大きいという結果である。残差の $\tau^2$ は 0.0504 で、共変量なしのモデルの 0.3378 から大きく減っている。
Step 2:meta でメタ回帰(metabin() → metareg())
meta では、まず metabin() などでメタアナリシスを行い、その結果オブジェクトを metareg() に渡してメタ回帰を行う。ここに、冒頭の研究者がはまった落とし穴がある。
落とし穴:metabin() に mods を書いても無視される
metafor の感覚で、metabin() に mods = ~ ablat を書いてみる。
res_meta <- metabin(event.e = tpos, n.e = tpos + tneg,
                    event.c = cpos, n.c = cpos + cneg,
                    data = dat.bcg, sm = "OR",
                    common = FALSE, random = TRUE,
                    studlab = paste0(author, ", ", year))
print(res_meta)
forest(res_meta)

# 落とし穴:metabin() に mods を渡しても、エラーも警告も出ずに無視される
res_meta_mods <- metabin(event.e = tpos, n.e = tpos + tneg,
                         event.c = cpos, n.c = cpos + cneg,
                         data = dat.bcg, sm = "OR", mods = ~ ablat,
                         common = FALSE, random = TRUE,
                         studlab = paste0(author, ", ", year))
all.equal(res_meta_mods$TE.random, res_meta$TE.random)  # TRUE:中身は同じ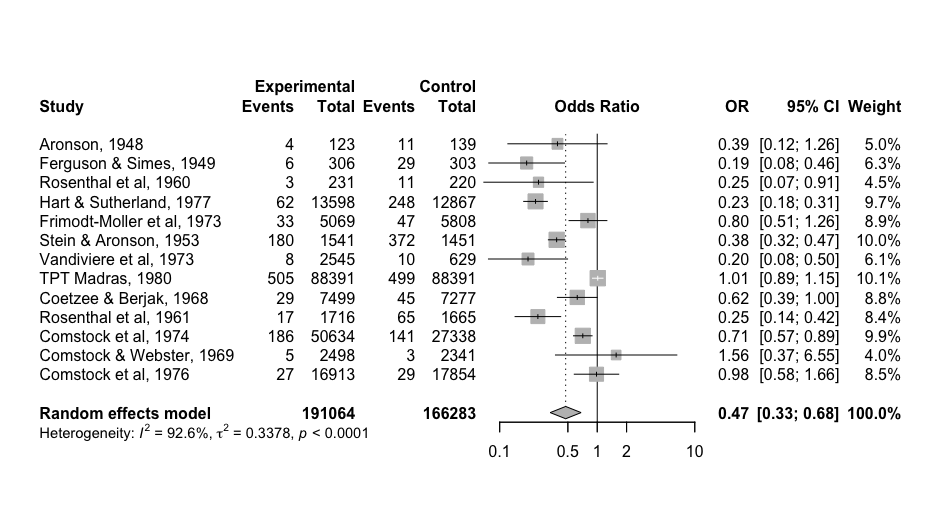
res_meta_mods を表示すると、次のように共変量なしの変量効果モデルの結果がそのまま表示される。
Number of studies: k = 13
Number of observations: o = 357347 (o.e = 191064, o.c = 166283)
Number of events: e = 2575

                         OR           95% CI     z  p-value
Random effects model 0.4746 [0.3296; 0.6835] -4.01 < 0.0001

Quantifying heterogeneity (with 95% CIs):
 tau^2 = 0.3378 [0.1302; 1.1812]; tau = 0.5812 [0.3608; 1.0868]
 I^2 = 92.6% [89.2%; 95.0%]; H = 3.69 [3.04; 4.47]

Test of heterogeneity:
      Q d.f.  p-value
 163.16   12 < 0.0001

Details of meta-analysis methods:
- Inverse variance method
- Restricted maximum-likelihood estimator for tau^2
- Q-Profile method for confidence interval of tau^2 and tau
- Calculation of I^2 based on Q
ここに表示されている $\tau^2 = 0.3378$ は、共変量なしの「研究間のばらつき全体」である。これを metafor のメタ回帰の残差 $\tau^2 = 0.0504$ と比べると、「meta は $\tau^2$ を推定し直していない」ように見えてしまう。しかし実際には、比べているものが「メタ回帰前」と「メタ回帰後」で違うだけである。
※コラム:なぜエラーにならないのか
metabin()には、古い引数名を受け止めるための...引数がある。知らない引数(ここではmods)はこの「何でも入る受け皿」に吸い込まれ、使われないまま捨てられる。宛名の書き間違いの郵便物が、差し戻されずに保管庫へ回されるようなものだ。Rの関数では珍しくない挙動なので、「エラーが出なかった=意図どおり動いた」とは限らないことを覚えておきたい。
正しくは metareg() を使う
res_meta_ablat <- metareg(res_meta, ~ ablat)
print(res_meta_ablat)
Mixed-Effects Model (k = 13; tau^2 estimator: REML)
tau^2 (estimated amount of residual heterogeneity): 0.0504 (SE = 0.0449)
tau (square root of estimated tau^2 value): 0.2246
I^2 (residual heterogeneity / unaccounted variability): 57.39%
H^2 (unaccounted variability / sampling variability): 2.35
R^2 (amount of heterogeneity accounted for): 85.06%
Test for Residual Heterogeneity:
QE(df = 11) = 25.0954, p-val = 0.0088
Test of Moderators (coefficient 2):
QM(df = 1) = 25.2424, p-val < .0001
Model Results:
estimate se zval pval ci.lb ci.ub
intrcpt 0.3010 0.2146 1.4025 0.1608 -0.1197 0.7217
ablat -0.0315 0.0063 -5.0242 <.0001 -0.0438 -0.0192 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Step 1 の metafor の出力と見比べてほしい。回帰係数、標準誤差、残差 $\tau^2$、$R^2$ まですべて同じである。出力の見た目まで同じなのには理由がある。
Step 3:metareg() の中身は metafor だった
class(res_meta_ablat)

# 研究ごとの効果量(対数OR)と分散は escalc() と同じ
all.equal(res_meta$TE, as.numeric(dat4metafor$yi))
all.equal(res_meta$seTE^2, as.numeric(dat4metafor$vi))

# 2つのモデルを並べて比べる関数
compare_fit <- function(fit_meta, fit_metafor) {
  data.frame(term        = names(coef(fit_metafor)),
             est_meta    = round(coef(fit_meta), 4),
             est_metafor = round(coef(fit_metafor), 4),
             se_meta     = round(fit_meta$se, 4),
             se_metafor  = round(fit_metafor$se, 4),
             tau2_meta   = round(fit_meta$tau2, 4),
             tau2_metafor = round(fit_metafor$tau2, 4),
             row.names = NULL)
}
compare_fit(res_meta_ablat, res_metafor_ablat)
> class(res_meta_ablat)
[1] "metareg" "rma.uni" "rma"
> all.equal(res_meta$TE, as.numeric(dat4metafor$yi))
[1] TRUE
> all.equal(res_meta$seTE^2, as.numeric(dat4metafor$vi))
[1] TRUE
> compare_fit(res_meta_ablat, res_metafor_ablat)
term est_meta est_metafor se_meta se_metafor tau2_meta tau2_metafor
1 intrcpt 0.3010 0.3010 0.2146 0.2146 0.0504 0.0504
2 ablat -0.0315 -0.0315 0.0063 0.0063 0.0504 0.0504metareg() の結果のクラスは "metareg" "rma.uni" "rma"、つまり metafor の rma.uni オブジェクトそのものである。metareg() は、metabin() が計算した研究ごとの効果量 TE と標準誤差 seTE を取り出し、次の設定で metafor::rma.uni() を呼び出している。
- 効果量:
yi = TE、sei = seTE(metabin()で計算したもの) - $\tau^2$ の推定法:
method =メタアナリシスで使ったmethod.tau(既定値は REML) - 検定法:メタアナリシスで Hartung-Knapp 法(
method.random.ci = "HK")を使っていればtest = "knha"、そうでなければtest = "z"
喩えるなら、meta と metafor は同じエンジンを積んだ2台の車である。meta はダッシュボード(フォレストプロットや出力の見やすさ)を整えた車で、メタ回帰の場面ではボンネットの中で metafor のエンジンが回っている。エンジンが同じなので、同じ燃料(効果量)を入れ、同じ走行モード($\tau^2$ の推定法と検定法)を選べば、走りは完全に同じになる。
Step 4:それでも標準誤差が違うときのチェックリスト
逆に言えば、両者の結果が違うときは、燃料か走行モードのどこかがずれている。よくある「ずれ」は次のとおりである。
| チェック項目 | meta 側の設定 | metafor 側の設定 | ずれると変わるもの |
|---|---|---|---|
| $\tau^2$ の推定法 | method.tau(version 5.0以降の既定値は REML、4.x以前は DL) | method(既定値は REML) | $\tau^2$、係数、SE |
| 検定法 | method.random.ci = "HK" なら Knapp-Hartung | test = "knha"(既定値は "z") | SE、検定統計量(z か t か)、CI |
| 効果量の定義 | sm、method("Peto" など) | escalc() の measure | 効果量そのもの → すべて |
| ゼロセルの連続補正 | incr、method.incr | escalc() の add、to | ゼロセルを含む研究の効果量(既定値どうしなら同じ) |
| モデルの種類 | method = "GLMM" なら内部で rma.glmm() | rma.uni() と rma.glmm() は別モデル | すべて(比べる相手を rma.glmm() にする) |
上の3つを実際に確かめてみる。いずれも、片方だけ設定を変えると結果がずれ、両方を揃えると一致する。
(a) $\tau^2$ の推定法:DL と REML
res_meta_dl <- update(res_meta, method.tau = "DL")
metareg(res_meta_dl, ~ ablat)$se        # meta (DL)
res_metafor_ablat$se                    # metafor (REML) … ずれる
compare_fit(metareg(res_meta_dl, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4metafor,
                    method = "DL"))     # 揃えれば一致
> metareg(res_meta_dl, ~ ablat)$se # meta (DL)
[1] 0.210875146 0.006172559
> res_metafor_ablat$se # metafor (REML) … ずれる
[1] 0.214648582 0.006276366
> compare_fit(metareg(res_meta_dl, ~ ablat), ...
term est_meta est_metafor se_meta se_metafor tau2_meta tau2_metafor
1 intrcpt 0.3030 0.3030 0.2109 0.2109 0.048 0.048
2 ablat -0.0316 -0.0316 0.0062 0.0062 0.048 0.048meta は version 5.0(2021年)で $\tau^2$ の既定の推定法を DerSimonian-Laird(DL)法から REML に変更した。古い meta を使っている場合や、settings.meta("RevMan5") のように DL を使う設定を読み込んでいる場合は、metafor(既定値は REML)と結果がずれる。
(b) 検定法:Knapp-Hartung 法
res_meta_hk <- update(res_meta, method.random.ci = "HK")
metareg(res_meta_hk, ~ ablat)
compare_fit(metareg(res_meta_hk, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4metafor,
                    test = "knha"))     # 揃えれば一致
Test of Moderators (coefficient 2):
F(df1 = 1, df2 = 11) = 17.5958, p-val = 0.0015
Model Results:
estimate se tval df pval ci.lb ci.ub
intrcpt 0.3010 0.2571 1.1709 11 0.2664 -0.2648 0.8669
ablat -0.0315 0.0075 -4.1947 11 0.0015 -0.0481 -0.0150 **
term est_meta est_metafor se_meta se_metafor tau2_meta tau2_metafor
1 intrcpt 0.3010 0.3010 0.2571 0.2571 0.0504 0.0504
2 ablat -0.0315 -0.0315 0.0075 0.0075 0.0504 0.0504Knapp-Hartung 法では、$\tau^2$ も係数も変わらないが、標準誤差が残差のばらつきに応じて調整され(ここでは 0.0063 → 0.0075)、z分布の代わりに自由度 $k – p = 11$ のt分布で検定・信頼区間を計算する。研究数が少ないメタ回帰で、通常の z 検定が有意になりすぎる問題への対処として提案された方法である(Knapp & Hartung, 2003)。meta でメタアナリシスを HK 法で行っていると、metareg() も自動で HK 法になる点に注意したい(metareg(..., hakn = FALSE) で z 検定に戻せる)。
(c) 効果量の定義:Peto 法のオッズ比
res_meta_peto <- update(res_meta, method = "Peto")
dat4peto <- escalc(measure = "PETO", ai = tpos, n1i = tpos + tneg,
                   ci = cpos, n2i = cpos + cneg, data = dat.bcg)
compare_fit(metareg(res_meta_peto, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4peto))
term est_meta est_metafor se_meta se_metafor tau2_meta tau2_metafor
1 intrcpt 0.2769 0.2769 0.1494 0.1494 0.0173 0.0173
2 ablat -0.0289 -0.0289 0.0043 0.0043 0.0173 0.0173metabin() で method = "Peto" を指定すると、研究ごとの効果量が Peto 法の対数オッズ比になる。これは escalc(measure = "OR") の通常の対数オッズ比とは別物なので、ablat の係数(−0.0289)も標準誤差(0.0043)も Step 1 とは違う値になる。metafor 側も measure = "PETO" にすれば一致する。料理に喩えれば、同じレシピでも計量カップが違えば味が変わる、ということである。
※コラム:
settings.meta()のプリセットにも注意metaには、ガイドラインや雑誌に合わせて既定値をまとめて切り替えるsettings.meta()がある。例えばsettings.meta("RevMan5")は $\tau^2$ に DL 法、settings.meta("IQWiG6")は Paule-Mandel 法と HK 法を使う設定になる(meta 8.5-0 で確認)。スクリプトの冒頭やプロファイルでプリセットを読み込んでいると、本人が意識しないうちにmetaforと設定がずれることがある。settings.meta("reset")で既定値に戻せる。
細かい違い:$I^2$ が 92.6% と 92.07% になる理由
メタ回帰ではないが、共変量なしのモデルでも両者の出力には小さな違いがある。$\tau^2 = 0.3378$ は同じなのに、$I^2$ は meta で 92.6%、metafor で 92.07% と表示される。これは $I^2$ の計算式が違うためである。
meta:$Q$ 統計量から計算する $I^2 = (Q – \mathrm{df})/Q = (163.16 – 12)/163.16 \approx 92.6\%$(出力の “Calculation of I^2 based on Q”)metafor:推定した $\tau^2$ から計算する $I^2 = \hat{\tau}^2 / (\hat{\tau}^2 + \tilde{v})$($\tilde{v}$ は研究内分散の「典型値」)
2つの式は DL 法では一致するが、REML などほかの推定法では少しずれる(Higgins & Thompson, 2002)。なお、metareg() の出力に出る残差の $I^2$(57.39%)は metafor が計算したものなので、メタ回帰の部分では両者は一致する。
Step 5:結果を図で確認する(バブルプロット)
メタ回帰の結果は、横軸に共変量、縦軸に効果量をとり、各研究を重みに比例した大きさの円で描くバブルプロットで確認するとよい。meta では bubble()、metafor では regplot() で描ける。
bubble(res_meta_ablat)                  # meta
regplot(res_metafor_ablat, transf = exp, # metafor
        xlab = "Absolute latitude", ylab = "Odds ratio")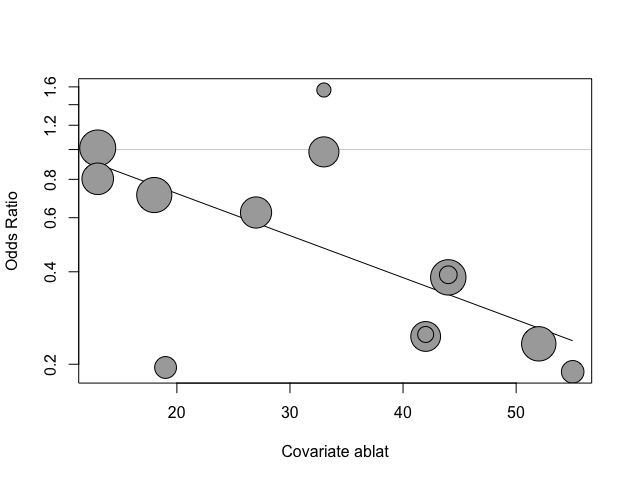
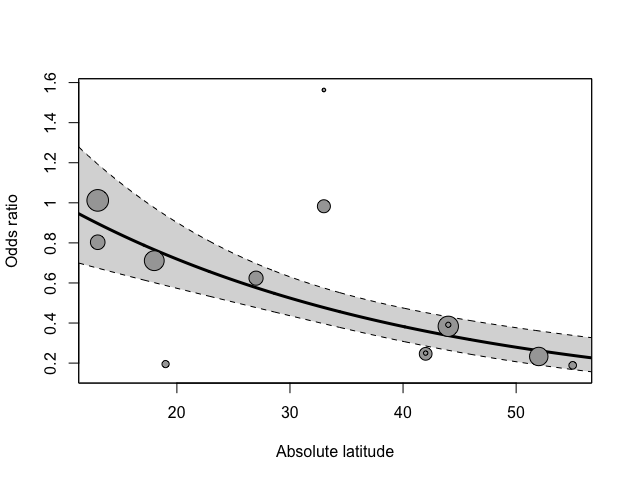
緯度が高い研究ほどオッズ比が小さい(ワクチンの効果が大きい)傾向が見て取れる。一方で、研究数は13しかなく、同じ緯度の研究も少ない。直線の当てはまりを鵜呑みにせず、個々の研究の位置も合わせて確認したい。
2つの図の回帰線は、見た目は違うが同じ結果である。meta の bubble() は縦軸を対数目盛りで描くため、対数オッズ比の回帰式がそのまま直線になる。metafor の regplot(transf = exp) は推定値をオッズ比に戻して通常の目盛りで描くため、同じ回帰式が曲線(指数関数)になる。灰色の帯は回帰線の95%信頼区間である。円の大きさはどちらも研究の重みを表すが、大きさの決め方が違うため、図同士で円の大きさは比べられない。なお、metafor の transf = exp を削除すれば、Y軸が meta と同じく対数オッズ比となり、回帰線も直線になる。
どちらを使うべきか?
ここまで見てきたとおり、標準的な変量効果メタ回帰であれば、meta と metafor のどちらを使っても結果は同じである。したがって、「どちらが正しいか」ではなく、作業の流れに合うほうを選べばよい。
meta:metabin()→forest()→metareg()→bubble()と、メタアナリシスの流れの中でそのままメタ回帰まで進められる。論文用のフォレストプロットを細かく整えたい場合にも便利であるmetafor:rma.mv()による多変量・多階層モデル、permutest()による並べ替え検定、anova()による係数の検定など、メタ回帰を深掘りする道具がそろっている。metareg()の結果はrma.uniオブジェクトなので、これらの多くはmetaで作った結果にもそのまま使える
どちらを使う場合も、論文の Methods には「$\tau^2$ の推定法」と「検定法(z 検定か Knapp-Hartung 法か)」を明記しておくと、読者が結果を再現しやすい。また、メタ回帰そのものの注意点として、研究数が少ないと検出力が低く偶然の関連も出やすいこと、研究単位の関連は個々の患者レベルの関連を意味しないこと(生態学的バイアス)、共変量は事前に決めておくべきことも押さえておきたい(Thompson & Higgins, 2002)。
論文でそのまま使える英文テンプレート
以下の数値は、本記事の BCG データで実際にRを実行して得た結果である。自分のデータに使う場合は、推定法・検定法と数値を差し替えること。
Methods:
To explore sources of between-study heterogeneity, we performed a random-effects meta-regression with absolute latitude as a study-level covariate. Log odds ratios and their sampling variances were calculated for each study, and the residual between-study variance (τ²) was estimated using the restricted maximum likelihood method. Analyses were conducted with the meta (version 8.5-0) and metafor (version 5.0-1) packages in R (version 4.5.3).
(日本語訳)研究間の異質性の要因を探索するため、緯度の絶対値を研究レベルの共変量とする変量効果メタ回帰を行った。各研究の対数オッズ比とその標本分散を算出し、残差の研究間分散(τ²)は制限付き最尤法で推定した。解析には R(version 4.5.3)の meta パッケージ(version 8.5-0)および metafor パッケージ(version 5.0-1)を用いた。
Knapp-Hartung 法を使った場合は、次の一文を加える:“The Knapp–Hartung method was used to calculate standard errors, confidence intervals, and P values of the regression coefficients.”(回帰係数の標準誤差・信頼区間・P値の計算には Knapp-Hartung 法を用いた。)
Results:
In the meta-regression, higher absolute latitude was associated with a lower odds ratio for tuberculosis (regression coefficient for log odds ratio, −0.032 per degree; 95% CI, −0.044 to −0.019; P < 0.001). Absolute latitude accounted for 85% of the between-study heterogeneity (residual τ² = 0.050, compared with τ² = 0.338 without the covariate).
(日本語訳)メタ回帰では、緯度の絶対値が高いほど結核のオッズ比が低かった(対数オッズ比に対する回帰係数:1度あたり −0.032、95%信頼区間 −0.044〜−0.019、P < 0.001)。緯度の絶対値は研究間の異質性の85%を説明した(残差 τ² = 0.050、共変量なしでは τ² = 0.338)。
まとめ
metaのmetareg()は、内部でmetaforのrma.uni()を呼び出している。残差 $\tau^2$ もメタ回帰の中で推定し直される- 効果量の定義・$\tau^2$ の推定法・検定法が揃っていれば、両者の結果は完全に一致する
metabin()にmodsを書いても、エラーも警告も出ずに無視される。メタ回帰は必ずmetareg()で行う- 結果がずれたら、
method.tau(DL か REML か)、method.random.ci(HK か)、sm・method(Peto など)、settings.meta()のプリセットを確認する
2つのパッケージの結果が食い違うと、つい「計算方法が根本的に違うのでは」と考えたくなる。しかし多くの場合、原因はもっと手前の設定にある。同じエンジンの車なら、まず走行モードのスイッチを確認する、という順番で考えるとよい。
一括コピペ用Rスクリプト
動作確認環境:R 4.5.3、meta 8.5-0、metafor 5.0-1、metadat 1.6-0
# ============================================================
# meta と metafor のメタ回帰を比較する(BCGワクチンデータ)
# ============================================================
library(metafor)   # metadat(dat.bcg を含む)も自動で読み込まれる
library(meta)

data(dat.bcg)

# ---- Step 1:metafor でメタ回帰 ----------------------------
dat4metafor <- escalc(measure = "OR", ai = tpos, bi = tneg,
                      ci = cpos, di = cneg, data = dat.bcg,
                      slab = paste0(author, ", ", year))

res_metafor <- rma.uni(yi = yi, vi = vi, data = dat4metafor)
print(res_metafor)
forest(res_metafor, transf = exp)

res_metafor_ablat <- rma.uni(yi = yi, vi = vi, mods = ~ ablat,
                             data = dat4metafor)
print(res_metafor_ablat)

# ---- Step 2:meta でメタ回帰(metabin → metareg) ----------
res_meta <- metabin(event.e = tpos, n.e = tpos + tneg,
                    event.c = cpos, n.c = cpos + cneg,
                    data = dat.bcg, sm = "OR",
                    common = FALSE, random = TRUE,
                    studlab = paste0(author, ", ", year))
print(res_meta)
forest(res_meta)

# 落とし穴:metabin() に mods を渡しても、エラーも警告も出ずに無視される
res_meta_mods <- metabin(event.e = tpos, n.e = tpos + tneg,
                         event.c = cpos, n.c = cpos + cneg,
                         data = dat.bcg, sm = "OR", mods = ~ ablat,
                         common = FALSE, random = TRUE,
                         studlab = paste0(author, ", ", year))
all.equal(res_meta_mods$TE.random, res_meta$TE.random)  # TRUE:中身は同じ

# 正しくは metareg() を使う
res_meta_ablat <- metareg(res_meta, ~ ablat)
print(res_meta_ablat)

# ---- Step 3:中身を確かめる --------------------------------
class(res_meta_ablat)   # "metareg" "rma.uni" "rma"

# 研究ごとの効果量(対数OR)と分散は escalc() と同じ
all.equal(res_meta$TE, as.numeric(dat4metafor$yi))
all.equal(res_meta$seTE^2, as.numeric(dat4metafor$vi))

# 2つのモデルを並べて比べる関数
compare_fit <- function(fit_meta, fit_metafor) {
  data.frame(term        = names(coef(fit_metafor)),
             est_meta    = round(coef(fit_meta), 4),
             est_metafor = round(coef(fit_metafor), 4),
             se_meta     = round(fit_meta$se, 4),
             se_metafor  = round(fit_metafor$se, 4),
             tau2_meta   = round(fit_meta$tau2, 4),
             tau2_metafor = round(fit_metafor$tau2, 4),
             row.names = NULL)
}
compare_fit(res_meta_ablat, res_metafor_ablat)

# ---- Step 4:設定がずれると SE がずれる --------------------
# (a) tau^2 の推定法:meta 4.x 以前の既定値は DerSimonian-Laird
res_meta_dl <- update(res_meta, method.tau = "DL")
metareg(res_meta_dl, ~ ablat)$se        # meta (DL)
res_metafor_ablat$se                    # metafor (REML) … ずれる
compare_fit(metareg(res_meta_dl, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4metafor,
                    method = "DL"))     # 揃えれば一致

# (b) Knapp-Hartung 法:meta 側で HK を選ぶと metareg も test = "knha" になる
res_meta_hk <- update(res_meta, method.random.ci = "HK")
compare_fit(metareg(res_meta_hk, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4metafor,
                    test = "knha"))     # 揃えれば一致

# (c) 効果量の定義:Peto 法のオッズ比は escalc(measure = "OR") と別物
res_meta_peto <- update(res_meta, method = "Peto")
dat4peto <- escalc(measure = "PETO", ai = tpos, n1i = tpos + tneg,
                   ci = cpos, n2i = cpos + cneg, data = dat.bcg)
compare_fit(metareg(res_meta_peto, ~ ablat),
            rma.uni(yi, vi, mods = ~ ablat, data = dat4peto))

# ---- Step 5:結果を図で確認する ----------------------------
bubble(res_meta_ablat)                  # meta
regplot(res_metafor_ablat, transf = exp, # metafor
        xlab = "Absolute latitude", ylab = "Odds ratio")
おすすめ書籍
- 丹後俊郎『新版 メタ・アナリシス入門―エビデンスの統合をめざす統計手法―』(医学統計学シリーズ)朝倉書店, 2016. 変量効果モデル、異質性、メタ回帰の考え方を医学統計の立場から体系的に学べる日本語の定番書。 Amazonで見る
- 山田剛史・井上俊哉『メタ分析入門―心理・教育研究の系統的レビューのために―』東京大学出版会, 2012. 効果量の考え方から異質性、調整変数の分析まで、心理・教育研究の文脈で丁寧に解説した入門書。医療以外の分野でメタ分析を行う人にもすすめやすい。 Amazonで見る
- Schwarzer G, Carpenter JR, Rücker G. Meta-Analysis with R (Use R!). Springer; 2015.
metaパッケージの開発者による解説書。刊行時点のmeta(version 4.x)は $\tau^2$ の既定値が DL 法なので、本記事の「設定のずれ」を意識しながら読むとよい。 Amazonで見る - Harrer M, Cuijpers P, Furukawa TA, Ebert DD. Doing Meta-Analysis with R: A Hands-On Guide. Chapman & Hall/CRC; 2021.
metaとmetaforの両方を使い、メタ回帰まで手を動かしながら学べる実践書。Web版(bookdown)も公開されている。 Amazonで見る
参考文献
- Balduzzi S, Rücker G, Schwarzer G. How to perform a meta-analysis with R: a practical tutorial. Evidence-Based Mental Health. 2019;22(4):153–160. https://doi.org/10.1136/ebmental-2019-300117
- Viechtbauer W. Conducting meta-analyses in R with the metafor package. Journal of Statistical Software. 2010;36(3):1–48. https://cran.r-project.org/web/packages/metafor/vignettes/metafor.pdf
- Colditz GA, Brewer TF, Berkey CS, et al. Efficacy of BCG vaccine in the prevention of tuberculosis: meta-analysis of the published literature. JAMA. 1994;271(9):698–702. https://doi.org/10.1001/jama.1994.03510330076038
- Knapp G, Hartung J. Improved tests for a random effects meta-regression with a single covariate. Statistics in Medicine. 2003;22(17):2693–2710. https://doi.org/10.1002/sim.1482
- Thompson SG, Higgins JPT. How should meta-regression analyses be undertaken and interpreted? Statistics in Medicine. 2002;21(11):1559–1573. https://doi.org/10.1002/sim.1187
- Higgins JPT, Thompson SG. Quantifying heterogeneity in a meta-analysis. Statistics in Medicine. 2002;21(11):1539–1558. https://doi.org/10.1002/sim.1186

コメント