「先生、目的変数をShapiro-Wilk検定にかけたら、P値が0.001未満でした。説明変数もほとんど正規分布ではありません。重回帰分析は諦めるしかないでしょうか…」
統計の相談を受けていると、こうした声を本当によく聞く。ここで、結論から述べておく。
絶望する必要はない。 線形回帰で正規性が関わるのは、目的変数でも説明変数でもなく「誤差」である。しかもその正規性は、回帰係数の推定そのものには不要で、P値や信頼区間を正確にするための条件である。大標本であれば、多少崩れていても結果への影響は小さい。
本記事では、この誤解の正体を整理し、「何を確認すればよいのか」「論文や査読にどう書けばよいのか」まで、初心者の方に向けて順に説明する。
なお、仮定の全体像を先に知りたい方は、次の記事も参考にしてほしい。
1. デマの正体:なぜ「全部が正規分布」だと思い込んでしまうのか
この誤解が広まる理由は、主に二つあると考えられる。
- t検定やANOVAのイメージが持ち込まれている。 基礎で最初に学ぶ検定で「正規分布」という言葉が繰り返し出てくるため、「統計手法=データが正規分布であることが必要」という印象が刷り込まれやすい。
- 入門書の例題が、きれいな釣鐘型ばかりである。 理解しやすさのために選ばれた例が、いつの間にか「満たすべきルール」に見えてしまう。
これは初心者だけの問題ではない。臨床心理学の12誌を調べた系統的レビュー(Ernst & Albers, 2017)では、回帰分析を用いた論文の4%で、変数そのものの正規性が必要な仮定だと誤って扱われていた。
見逃してはならないのは、これらが査読を通過して出版された論文だという点である。つまり、その分野の専門家であるはずの査読者が、この誤りを指摘できていない(あるいは気づいていない)。これは重大な問題であり、査読者の統計知識の不足が、論文の質を下げている一因となっている可能性がある。筆者の実感としても、この誤解を含め、見当違いな指摘をしてくる査読者は決して少なくない。だからこそ、正しい理解を自分の側が身につけておくことが、論文を守る力になる。
※コラム:たとえ話「料理人の腕前を、食材の形で採点しない」
回帰モデルを「料理人」、データを「食材」にたとえてみよう。料理人の腕前(モデルの妥当性)を見るときに確認するのは、食材の形(目的変数や説明変数の分布)ではなく、「味見をしたときに残るズレ(誤差)」である。食材が不ぞろいでも、ズレが小さく偏りがなければ、料理は成立する。
2. 正規性が関わるのは「誤差」だけ
線形回帰モデルは、次のように書ける。
$$Y = \beta_0 + \beta_1 X_1 + \cdots + \beta_k X_k + \varepsilon$$
ここで $\varepsilon$ が誤差であり、「説明変数で説明しきれなかった、予測のはずれ幅」を表している。標準的な線形回帰で正規性が登場するのは、この $\varepsilon$ についてである。
目的変数が正規分布でなくてもよい理由
目的変数の分布は、「説明変数による違い」と「誤差」が混ざったものである。たとえば、体重を性別(男性/女性)で説明するモデルを考えてみよう。男女を合わせた体重の分布は、二つの山を持つ形になることがある。しかし、男女それぞれの中で誤差が整っていれば、モデルとしては問題がない。目的変数全体の見た目が釣鐘型でないことは、それだけでは異常ではない。
説明変数が正規分布でなくてもよい理由
説明変数は、モデルの中では「与えられた値」として扱われる。説明変数の値を決まったものとして(条件付きで)考えるため、その分布の形は問われない。その最も分かりやすい証拠が、ダミー変数(ゼロ1変数)である。「男性=1、女性=0」のような0/1の変数は、正規分布とは似ても似つかないが、回帰分析には当たり前のように使われている。
ただし、説明変数に極端な外れ値があると、その1点が回帰直線を大きく引っ張る(影響点になる)ことがある。これは「正規性」の問題ではなく「外れ値」の問題として、別に確認しておく。
※コラム:誤差と残差の違い
「誤差」は、母集団における本当のはずれ幅で、私たちには直接見えない。「残差」は、手元のデータにモデルを当てはめたあとに残る、実際の「実測値-予測値」である。仮定を確認するときは、見えない誤差の代わりに残差を使って確認する。
3. その正規性も、推定には必須ではない:Gauss–Markov と大標本
実は、誤差の正規性でさえ、回帰係数を推定するだけなら必須の条件ではない。ただし、臨床研究ではP値や信頼区間を報告するのが通常であるため、残差がおおむね正規分布とみなせるかは、原則として確認しておくべき項目である。この「確認しておくべき」と「崩れたら終わり」は、全く別の話である。
点推定には正規性は不要
最小二乗法による回帰係数の推定値は、誤差の平均がゼロで、無相関で、分散が一定であれば、不偏で、線形不偏推定量の中で最も分散が小さいことが、Gauss–Markovの定理として知られている。この定理に、正規性は含まれていない。
正規性が効いてくるのは「P値と信頼区間」
正規性が役に立つのは、小さな標本でP値や信頼区間を正確に計算したい場面である。Schmidt & Finan(2018)も、正規性の違反は点推定にバイアスをもたらさず、標準誤差・信頼区間・P値に関わると整理している。さらに、標本が大きい場合(例として、変数1つあたり観測数が10を超える場合)には、違反が結果に目立った影響を与えないことが多いという。
大標本で影響が小さくなる背景には、中心極限定理がある。また、Lumleyら(2002)は、線形回帰が正規分布する目的変数にしか使えないという考えは広く信じられているが誤りであること、大標本では分布によらず妥当であることをシミュレーションで示している。
ただし同じ論文は、線形回帰の主な限界は分布の問題ではなく、「平均の差を推定することが、本当に知りたい問いに答えているか」にあると述べている。たとえば医療費のように極端に歪んだ指標では、平均が目的に合っているかを、一度考えておきたい。
※コラム:中心極限定理を一言で
「サイコロ1個の目の分布は平らだが、たくさん振って平均を取ると、釣鐘型に近づく」という現象のこと。回帰係数の推定値も、データを積み重ねた「平均のようなもの」なので、標本が大きければ、元の分布が多少歪んでいても、推定値のばらつき方は釣鐘型に近づく。
ただし「いつでも無視してよい」わけではない
次のような場合は、慎重に確認したほうがよい。
- 標本が小さい(P値や信頼区間の精度が落ちやすい)
- 残差の分布が極端に歪んでいる、または外れ値が目立つ
- 個々の予測値の「予測区間」を出したい(予測区間は、1人ひとりの誤差の分布の形に直接依存するため、中心極限定理の恩恵を受けにくい)
4. 正規性より先に確認したいこと
正規性に悩む前に、次の点を確認するほうが、結果への影響は大きいことが多い。
| 確認する項目 | 見るもの |
|---|---|
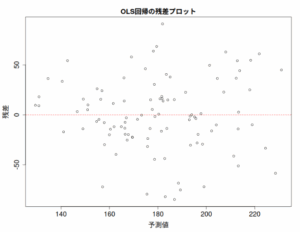
| 線形性 | 残差と予測値の散布図に、曲がった傾向がないか |
| 等分散性 | 予測値が大きくなるほど、残差のばらつきが広がっていないか |
| 独立性 | 同じ人の繰り返し測定や、時系列の並びなど、データ同士がつながっていないか |
| 外れ値・影響点 | 1点だけで結果が大きく変わっていないか |
Lumleyらも、目的変数の正規性よりも、分散が一定かどうかのほうが重要であると指摘している。
正規性を見る場合は、検定よりも、残差のQ-Qプロット(点が斜めの直線にほぼ沿っているか)を主に使うのがよい。Shapiro-Wilk検定のような検定は、標本が大きいと、実務上は問題にならない小さなズレでもP値が小さくなり、標本が小さいとズレを見逃しやすい、という性質がある。そのため、検定の結果だけで判断しないほうがよい。検定を使いすぎる問題については、こちらを参照してほしい。
5. やってはいけない対処:「正規にするため」の安易な変換
「Shapiro-Wilk検定でP値が小さかったから、とりあえず目的変数を対数変換しよう」という対処は、実は危うい。
Schmidt & Finan(2018)は、正規性を満たすために行われる目的変数の恣意的な変換こそが、点推定にバイアスをもたらしうると指摘している。さらに、変換すると、回帰係数の意味も変わってしまう。たとえば対数変換後の係数は、「1単位増えると何ポイント変わるか」ではなく、「おおよそ何%変わるか」のような解釈になる。また、変換後の尺度で推定した値を元の単位に戻すと、平均値とは別の量(幾何平均や中央値に近いもの)を見ていることになる。
対数変換そのものが悪いわけではない。「関係をうまく表現するために変換する」のはよいが、「正規分布に見せかけるために変換する」のは避けたい。
※コラム:たとえ話「見栄えのために、体温計の目盛りを書き換えない」
体温計の見た目を整えようとして目盛りを勝手に書き換えたら、測っている意味が変わってしまう。目的変数を「正規に見えるように」ゆがめる変換も、同じように、数値の意味を変えてしまう。
6. 論文・査読での書き方(英文例)
以下は記述例である。具体的な数値や結果の記述は、実際のデータの確認結果に置き換えて使ってほしい。
Methods(例)
Model assumptions of the multiple linear regression were evaluated using the residuals. Linearity and homoscedasticity were assessed by plotting the residuals against the fitted values, and normality of the residuals was assessed using a normal quantile–quantile (Q–Q) plot. The outcome variable was not transformed solely to achieve normality. Influential observations were examined using [Cook’s distance / leverage].
査読者に「目的変数が正規分布していない」と指摘されたときの返答(例)
We thank the reviewer for this comment. In linear regression, the normality assumption concerns the error term (assessed using the residuals), not the marginal distribution of the outcome or the explanatory variables. We therefore examined the residuals using a Q–Q plot, which showed [no marked deviation from normality / describe findings]. In addition, given the sample size (n = [XXX]), inference on the regression coefficients is expected to be robust to moderate departures from normality (Lumley et al., 2002; Schmidt & Finan, 2018).
※補足:marginal distribution(周辺分布)とは
説明変数で説明したり、グループに区切ったりせず、ありのままの目的変数だけを見たときの分布のことである。たとえば、男女を区別せずに体重全体のヒストグラムを描いたとき、その形が周辺分布にあたる。線形回帰で問われるのは、この「ありのままの形」ではなく、説明変数で説明したあとに残る誤差の形である。
返答のポイントは、次の3つである。
- 正規性の対象は「誤差(残差)」であることを、冷静に説明する。
- 実際に残差を確認したことを示す。
- 標本サイズと、先行する文献を根拠として添える。
まとめ
- 線形回帰で正規性が関わるのは、目的変数でも説明変数でもなく、誤差(残差)である。
- その正規性は、点推定には不要で、P値や信頼区間に関わる。残差は原則として確認しておくが、大標本では多少崩れても影響は小さくなることが多い。
- 正規性に悩む前に、線形性・等分散性・独立性・外れ値を確認する。
- 「正規にするための変換」は、むしろバイアスのもとになりうる。
Shapiro-Wilk検定でP値が小さくなっても、そこで分析を諦める必要はない。まず、残差を見るところから始めてみてほしい。
参考文献
- Lumley T, Diehr P, Emerson S, Chen L. The importance of the normality assumption in large public health data sets. Annu Rev Public Health. 2002;23:151-169. doi:10.1146/annurev.publhealth.23.100901.140546
- Schmidt AF, Finan C. Linear regression and the normality assumption. J Clin Epidemiol. 2018;98:146-151. doi:10.1016/j.jclinepi.2017.12.006
- Ernst AF, Albers CJ. Regression assumptions in clinical psychology research practice—a systematic review of common misconceptions. PeerJ. 2017;5:e3323. doi:10.7717/peerj.3323
おすすめ書籍(英語に抵抗がない方向け)
回帰分析を、実際のデータの問題を解くための道具として解説した定評のある教科書である。Gelman先生らは、回帰の仮定の中で、誤差の正規性の重要度は最も低いという立場を取っている(旧版 Data Analysis Using Regression and Multilevel/Hierarchical Models でも同様である)。「変数が正規分布でなければならない」という誤解を解くうえで、頼りになる一冊である。
ただし、読む際に2点だけ注意してほしい。
- 英語で約550ページあり、初心者がいきなり通読する本ではない。仮定の章(Chapter 11)など、必要な章を拾い読みする使い方がよい。
- 同書は、正規性の重要度を低く位置づける立場である。本記事は「P値や信頼区間を報告する臨床研究では、残差は原則として確認しておく」という立場であり、強調点が少し異なる。この違いを知ったうえで読むと、理解が深まる。

コメント