若手医師:先生、例のコホート研究なんですが、重症度スコアと年齢で調整したら、ハザード比が1.38、95%信頼区間が0.94〜2.02になりました。p = 0.096です。Discussionには「曝露とイベントとの間に関連は認められなかった」と書けばいいですよね?
統計家:ちょっと待とう。点推定は1.38、つまりイベントのリスクがおよそ4割増えるという推定だね。それを「関連なし」とまとめてしまうのは、ずいぶんもったいない。
若手医師:でも、95%信頼区間が1をまたいでいますし……。
統計家:そのとおり。では聞くけど、このデータはHR = 1(関連なし)とHR = 2(リスク2倍)の、どちらと「より相性がいい」と思う?
若手医師:え……区間の端っこ同士なので、どっちも同じくらい……ですか?
統計家:いい勘だ。実はp値で見ると、HR = 1のp値が0.096、HR = 2のp値が0.056で、ほとんど差がない。「関連なし」と書くなら、ほぼ同じ根拠で「リスクは約2倍」と書いてもおかしくないくらいなんだよ。今日はそれを1枚の絵で見てみよう。p値関数という道具だ。
臨床研究の現場では、p値と95%信頼区間(95%CI)が「有意か、非有意か」という2択の判定に使われがちである。しかしp値もCIも、本来はもっと豊かな連続的な情報を持っている。p値関数(P-value function)は、その情報を捨てずに1枚の曲線として描く方法である。
1. p値関数とは何か
1-1. p値は「帰無仮説ひとつ」に対する答えにすぎない
通常のp値は、「もし真のハザード比が1(効果なし)だとしたら、今回のデータ(またはそれ以上に極端なデータ)はどれくらい珍しいか」を表す数字である。
ここで大事なのは、問いを立てる相手は「HR = 1」でなくてもよいという点だ。「もし真のHRが1.2だったら?」「1.5だったら?」「2.0だったら?」と、同じ計算はどの値に対してもできる。帰無仮説の「1」は、数ある候補のひとつにすぎない。
1-2. すべての候補についてp値を計算してつなぐと「山」になる
横軸にハザード比の候補値、縦軸にその候補値を検定したときのp値をとり、点をつなぐ。すると、点推定値を山頂(p = 1)とする、なだらかな山の形の曲線が現れる。これがp値関数である。
推定値が正規分布で近似できるとき(ハザード比なら対数スケールで考える)、候補値 θ に対するp値は次の式で表される。
$$
p(\theta) = 2\left(1 – \Phi\left(\frac{|\hat{\beta} – \log\theta|}{SE}\right)\right)
$$
ここで $\hat{\beta}$ は対数ハザード比の推定値、$SE$ はその標準誤差、$\Phi$ は標準正規分布の累積分布関数である。式を覚える必要はない。「推定値から遠い候補ほど、p値が小さくなる」ことだけ押さえておけばよい。なお、この式は「対数ハザード比の推定値が正規分布に従う」という近似(Wald近似)にもとづいている。イベント数が少ないと近似が粗くなり、尤度比検定やプロファイル尤度にもとづく区間とずれることがある。
この山は、登山地図の等高線にたとえると分かりやすい。
- 山を p = 0.05 の高さで水平に輪切りにしたとき、切り口の幅がそのまま 95%CI になる
- p = 0.20 の高さで切れば 80%CI、p = 0.50 の高さで切れば 50%CI になる
- 山頂は点推定値である
つまり、論文に載っている95%CIは「山のある1本の等高線」だけを書き写したものであり、p値は「HR = 1という地点の標高」だけを読み上げたものである。p値関数は、その山全体の地形図を見せてくれる。
※コラム:S値(surprisal)とコイン投げ
p値の大小は直感的に捉えにくい。そこでRafi & Greenland (2020) は、p値を $s = -\log_2 p$ と変換したS値を勧めている。単位はビットで、「公平なコインを投げて、表が s 回続けて出る」のと同じくらいの意外さを表す。たとえば p = 0.05 は約4.3ビットで、表が4回続く程度の意外さにすぎない。p = 0.096 なら約3.4ビット、つまり表が3回ちょっと続く程度である。4回連続で表が出たからといって「このコインは絶対にイカサマだ」と言い切る人はいないだろう。p = 0.05 という境界線の重みは、その程度のものである。
1-3. 山の「形」が語ること
p値関数を描くと、次の2つが一目で分かる。
- 山頂の位置:データが最もよく両立する効果の大きさ(点推定値)
- 山の幅(裾の広がり):推定の精度。サンプルサイズやイベント数が少ないほど、山は低く裾広がりになる
そして「HR = 1におけるp値」は、この山の一地点の標高にすぎない。山頂がHR = 1.4付近にあり、裾が広いために、たまたまHR = 1の地点の標高が0.05を少し上回っている。それが「有意差なし」の正体であることが多い。
※コラム:p値関数は「真の値の確率分布」ではない
山の形をしているので、ベイズ統計の事後分布のように「HR = 1.4である確率が一番高い」と読みたくなる。しかしp値関数の高さは「その値が真である確率」ではない。「その値を仮定したとき、観察されたデータがどれくらい意外でないか」、つまりデータとの両立性(compatibility)を表している。また、この曲線は「統計モデルの仮定(比例ハザード性、交絡の調整が十分であること、など)がすべて正しい」という前提のうえで描かれている。未調整の交絡やバイアスがあれば、山ごと横にずれる可能性がある点に注意したい。
※コラム:何百回も「検定」しているのに、多重検定の補正はいらないの?
p値関数は、HR = 0.8、0.9、1.0、1.1……と無数の値でp値を計算する。そのため「検定を何度も繰り返しているのだから、多重検定の補正が必要では?」と思うかもしれない。しかし補正は不要である。多重検定の問題は、たくさんの検定の中から「有意になったもの」を選び出して結論にするときに起こる。p値関数は、1つの推定値(点推定値と標準誤差)がもつ情報を、あらゆる候補値に対して描き出しているだけで、何かを選んでいるわけではない。95%CIを計算するときに多重性の補正をしないのと同じことである。もちろん、アウトカムや部分集団を何十通りも解析し、その中から都合のよいp値関数だけを示せば、通常の多重性の問題がそのまま生じる。
※コラム:検証試験のp値と、観察研究のp値は役割がちがう
「p値はもう使うな」という主張を聞いて、「ではRCTの主要評価項目のp値も意味がないのか」と考える人がいる。これは誤解である。
検証的な臨床試験では、仮説・主要評価項目・有意水準・サンプルサイズを事前に決め、計画どおりに1回だけ検定する。ここでのp値は、「この治療を承認する/しない」という意思決定の道具である。第一種の過誤(効かない治療を効くと判断する誤り)の確率を5%以下に抑える、という約束を守るための仕組みであり、その役割は今も変わらない。
一方、観察研究や探索的な解析の主な目的は、「関連がどれくらいの大きさか」を推定することである。事前に決めた判定ルールもなく、交絡やバイアスの影響も受ける。ここでp値を0.05で切って「関連あり/なし」を決めても、得られるものは少ない。主役は点推定値と信頼区間、つまりp値関数が描き出す山全体である。
本記事で扱った「有意差なし=関連なし」の誤読は、主に後者の観察研究や探索的な解析で起こる問題である。p値関数は、検証試験の判定を置き換えるものではない。推定が主役となる場面で、p値の「正しい居場所」を示してくれる道具と考えるとよい。
2. 正攻法:p値関数は論文でどう使われてきたか
p値関数は新しいアイデアではない。その考え方は、Birnbaum (1961) が Journal of the American Statistical Association で示した confidence curve にまでさかのぼる。疫学の分野では、Poole (1987) が American Journal of Public Health で「信頼区間の先へ(Beyond the confidence interval)」と題して紹介し、広めた。同じ年の続報のタイトルは「Confidence intervals exclude nothing(信頼区間は何も除外しない)」で、95%CIの外側の値も「否定された」わけではないことを強調している。
その後、Bender, Berg & Zeeb (2005) が Biometrical Journal に医学研究向けのチュートリアルを発表した。さらに Infanger & Schmidt-Trucksäss (2019) は Statistics in Medicine で、p値関数を「研究結果を示し、定量的な推論を促すための、十分に活用されていない方法」と位置づけ、Rパッケージ pvaluefunctions とともに臨床研究での利用を勧めている。
実例:「関連なし」と結論された研究を描き直す
Rafi & Greenland (2020) は、JAMA に掲載された Brown ら (2017) のコホート研究を例に取り上げている。妊娠中のセロトニン作動性抗うつ薬の使用と、子の自閉スペクトラム症との関連を調べた研究である。
- 通常の調整:HR 1.59(95%CI 1.17〜2.17)
- 高次元傾向スコア(HDPS)による調整:HR 1.61(95%CI 0.997〜2.59)
著者らは、HDPSを用いた解析で95%CIがわずかに1をまたいだこと、兄弟比較の解析(HR 1.60、95%CI 0.69〜3.74)でも有意な関連がみられなかったことなどから、「関連は認められなかった」と結論した。これまで報告されてきた関連は、適応による交絡(抗うつ薬を必要とする母親側の要因)で説明できる可能性がある、という主張である。
しかしHDPS解析の結果をp値関数で描き直すと、HR = 1におけるp値は約0.05(S値で約4.3ビット)にすぎない。一方、点推定値であるHR 1.6付近ではp値がほぼ1である。Rafi & Greenland は、このデータはリスクの大幅な上昇とも十分に両立しており、「関連なし」と結論するのは自らのデータの読み違いだと指摘している。(本記事の後半で、この曲線をRで実際に描き直してみる。)
ただし、p値関数で描き直しても、適応による交絡があるかどうかという問いには答えられない。p値関数は「モデルの仮定が正しければ」という前提のうえで描かれるからである。p値関数が浮かび上がらせるのは、「HR = 1.6という推定値を、有意でないという理由だけで『関連なし』と言い切ってよいのか」という、結論の言葉づかいの問題である。
Rafi & Greenland は、こうした誤読を防ぐために、「信頼区間(confidence interval)」を「両立区間(compatibility interval)」と読み替えることも提案している。95%CIは「真の値が95%の確率で入る範囲」ではなく、「データと(モデルの仮定のもとで)よく両立する値の範囲」だからである。
3. Rで描くp値関数:Step by Step
ここからは疑似データを使い、冒頭の会話の状況を再現する。ポイントは次の比較である。
- 研究A:大規模コホート(n = 4,000)
- 研究B:小規模コホート(n = 800)
- どちらも真のHRは1.4という同じ仕組みでデータを作る
Step 1:疑似データを作る(交絡ありのコホート)
観測できない「重症度」が、曝露の受けやすさとイベントの起こりやすさの両方に影響する設定にする。解析では、重症度そのものではなく、誤差を含む「重症度スコア」と年齢で調整する。
# install.packages(c("survival", "pvaluefunctions"))
library(survival)
library(pvaluefunctions)

make_cohort <- function(n) {
  severity  <- rnorm(n)                          # 潜在的な重症度(観測できない)
  sev_score <- severity + rnorm(n, sd = 0.5)     # 重症度スコア(観測できる代理指標)
  age       <- round(65 + 2.4 * severity + rnorm(n, sd = 8))
  exposed   <- rbinom(n, 1, plogis(-1 + 0.8 * severity))     # 重症ほど曝露されやすい
  rate      <- 0.03 * exp(log(1.4) * exposed + 0.6 * severity) # 真のHR = 1.4
  t_event   <- rexp(n, rate)
  time      <- pmin(t_event, 5)                  # 5年で打ち切り
  event     <- as.integer(t_event <= 5)
  data.frame(exposed, sev_score, age, time, event)
}

set.seed(42)
studyA <- make_cohort(4000)   # 大規模コホート
studyB <- make_cohort(800)    # 小規模コホート

fitA <- coxph(Surv(time, event) ~ exposed + sev_score + age, data = studyA)
fitB <- coxph(Surv(time, event) ~ exposed + sev_score + age, data = studyB)

bA  <- coef(fitA)["exposed"];  seA <- sqrt(vcov(fitA)["exposed", "exposed"])
bB  <- coef(fitB)["exposed"];  seB <- sqrt(vcov(fitB)["exposed", "exposed"])

c(events_A = sum(studyA$event), events_B = sum(studyB$event))
round(rbind(
  StudyA = c(HR = exp(bA), lower = exp(bA - 1.96 * seA), upper = exp(bA + 1.96 * seA),
             P = 2 * pnorm(-abs(bA / seA))),
  StudyB = c(HR = exp(bB), lower = exp(bB - 1.96 * seB), upper = exp(bB + 1.96 * seB),
             P = 2 * pnorm(-abs(bB / seB)))
), 3)筆者の環境(R、set.seed(42))で実行した結果は次のとおりである。
| イベント数 | HR | 95%CI | p値 | |
|---|---|---|---|---|
| 研究A(n = 4,000) | 699 | 1.34 | 1.15〜1.57 | < 0.001 |
| 研究B(n = 800) | 118 | 1.38 | 0.94〜2.02 | 0.096 |
点推定値はほぼ同じなのに、研究Aは「有意」、研究Bは「有意差なし」になった。研究Bこそ、冒頭で若手医師が「関連なし」と書こうとしていた結果である。
(なお、データ生成に使った真のHRは1.4だが、推定値は1.4ちょうどにはならない。重症度スコアには測定誤差があり、交絡を完全には取り除けないからである。筆者が n = 200,000 で同じ設定を試したところ、重症度スコアで調整したHRは約1.54と、残余交絡によって上向きにずれた。今回の研究A・Bの推定値が1.4を下回っているのは、主に乱数のばらつきによるものである。)
※コラム:交絡と非collapsibilityは別物
交絡は、曝露とアウトカムの両方に関連する因子によって推定値がゆがむ現象で、交絡因子との関連の向きしだいで、推定値は上にも下にもずれる。これとは別に、オッズ比やハザード比には非collapsibilityという性質がある。交絡がまったくないランダム化比較試験でも、強い予後因子で調整するかしないかでオッズ比やハザード比の値が変わり、調整しないほうが1に近い値になる(Greenland, Robins & Pearl, 1999)。リスク比やリスク差には、この性質はない。非collapsibilityによるずれは、アウトカムがまれなときはごく小さい。本記事の疑似データでも、交絡のない設定で重症度を調整するとHR 1.39、調整しないとHR 1.38で、差はわずかだった(n = 200,000 で筆者が確認)。「調整前後でHRが変わった=交絡があった」とは限らない、という点は覚えておきたい。
Step 2:base R でp値関数を自作する
まずはパッケージを使わず、1-2の式をそのまま関数にして描いてみる。仕組みを理解するにはこれが一番の近道である。
pfun <- function(hr, est, se) 2 * pnorm(-abs(log(hr) - est) / se)

hr_grid <- exp(seq(log(0.6), log(3), length.out = 1000))

plot(hr_grid, pfun(hr_grid, bB, seB), type = "l", lwd = 2, log = "x",
     xlab = "Hazard ratio (log scale)", ylab = "P-value",
     main = "P-value function (Study B)")
abline(h = c(0.05, 0.20), lty = 2, col = "grey40")   # 95%CI と 80%CI の「等高線」
abline(v = 1, lty = 3)
text(0.65, c(0.08, 0.23), c("95% CI", "80% CI"), adj = 0, col = "grey40")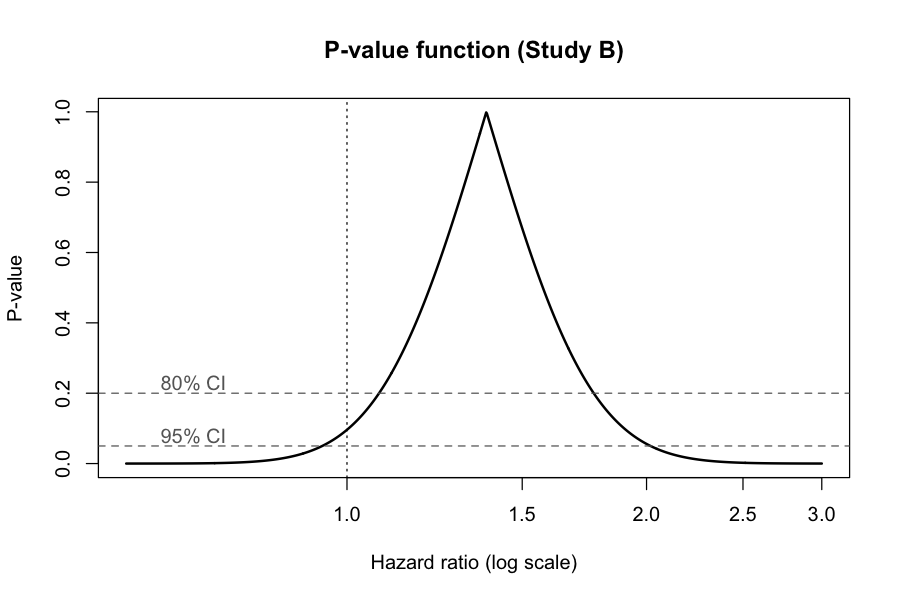
山頂はHR 1.38にある。p = 0.05 の破線と曲線が交わる2点が95%CI(0.94〜2.02)、p = 0.20 の破線との交点が80%CI(1.08〜1.77)である。HR = 1の縦の点線と曲線が交わる高さが、通常報告されるp値(0.096)にあたる。
冒頭の会話で触れたように、pfun(2, bB, seB) を計算すると、HR = 2におけるp値は約0.056になる。研究Bのデータは、HR = 1とHR = 2のどちらとも、同じくらい「そこそこ両立」しているのである。
※コラム:counternull値
点推定値をはさんで帰無値(HR = 1)の「反対側」にあり、帰無値とまったく同じp値をもつ値を counternull値 という(Rosenthal & Rubin, 1994)。対数スケールで左右対称なら、counternull = 点推定値² / 帰無値 で求まり、研究Bでは 1.38² ≈ 1.91 である。「HR = 1と言い張れるなら、同じ強さの根拠でHR = 1.9とも言い張れる」という、有意差なしの結果を読むときの良い歯止めになる。conf_dist()ではplot_counternull = TRUEで図示できる。
Step 3:pvaluefunctions で研究AとBを重ね描きする
pvaluefunctions::conf_dist() を使うと、推定値と標準誤差を渡すだけで、きれいなp値関数が描ける。Cox回帰の場合は type = "coxreg" とし、trans = "exp" でハザード比のスケールに戻す。null_values や xlim は対数スケールで指定する点に注意したい。
res_AB <- conf_dist(
  estimate    = c(bA, bB),
  stderr      = c(seA, seB),
  type        = "coxreg",
  plot_type   = "p_val",
  est_names   = c("Study A (n = 4000)", "Study B (n = 800)"),
  conf_level  = c(0.95, 0.80),
  null_values = log(1),              # 帰無値は対数スケールで指定
  trans       = "exp",
  alternative = "two_sided",
  xlab        = "Hazard ratio",
  xlim        = log(c(0.7, 2.5)),    # 軸の範囲も対数スケールで指定
  together    = TRUE,
  x_scale     = "logarithm",
  plot        = TRUE
)
res_AB$conf_frame    # 各信頼水準の信頼区間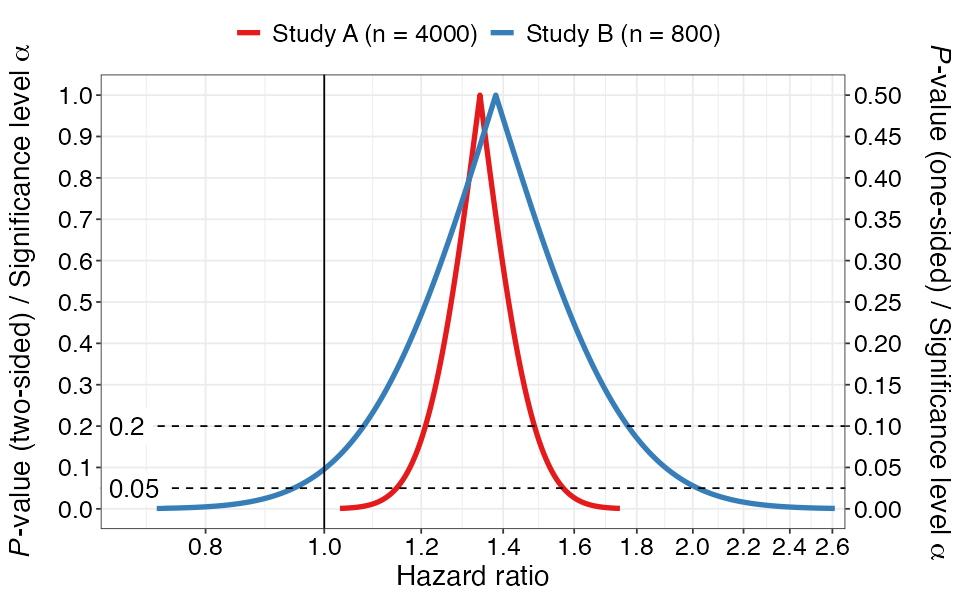
2つの山を見比べると、次のことが分かる。
- 山頂の位置はほぼ同じ(HR 1.34と1.38)。どちらの研究も「リスクがおよそ3〜4割増える」という方向を指している
- 違うのは山の幅である。研究Aはイベント数が多いので山が細く鋭い。研究Bは裾が広く、HR = 1の地点でもまだ曲線が0.05より上にある
研究Bの「有意差なし」は、研究Aと矛盾する結果ではない。同じ方向を指しているが、精度が足りないだけである。p値だけを並べて「研究Aでは関連あり、研究Bでは関連なし。結果は一貫しなかった」と書いてしまうと、この事実を見落とすことになる。
なお、右側の縦軸は片側p値の目盛りである(両側p値のちょうど半分)。
S値の曲線も、plot_type = "s_val" とするだけで描ける。
res_S <- conf_dist(
  estimate = c(bA, bB), stderr = c(seA, seB), type = "coxreg",
  plot_type = "s_val", est_names = c("Study A", "Study B"),
  null_values = log(1), trans = "exp", alternative = "two_sided",
  xlab = "Hazard ratio", xlim = log(c(0.7, 2.5)),
  together = TRUE, x_scale = "logarithm", plot = TRUE
)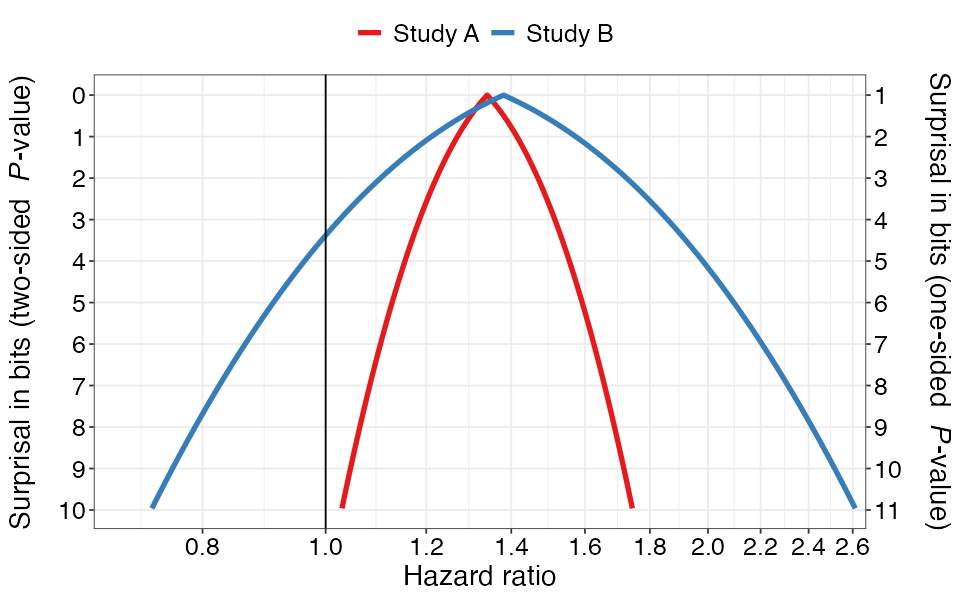
S値の曲線は、p値関数を上下ひっくり返したような谷の形になる(縦軸は下に行くほど意外さが大きい)。研究BではHR = 1におけるS値が約3.4ビットで、表が3回ちょっと続く程度の意外さにすぎないことが読み取れる。研究AではHR = 1のS値が約12ビットで、図の範囲外に出ている。
Step 4:既存論文の数値からp値関数を描き直す
p値関数は、手元に生データがなくても描ける。論文に載っている点推定値と95%CIさえあれば、標準誤差を逆算できるからである。ここでは2章で紹介した Brown ら (2017) のHDPS解析の結果を描き直してみる。
hr <- 1.61; lower <- 0.997; upper <- 2.59
b_pub  <- log(hr)
se_pub <- (log(upper) - log(lower)) / (2 * qnorm(0.975))   # 95%CIからSEを逆算
c(SE = se_pub, P_at_HR1 = 2 * pnorm(-abs(b_pub / se_pub)),
  S_at_HR1 = -log2(2 * pnorm(-abs(b_pub / se_pub))))

res_pub <- conf_dist(
  estimate = b_pub, stderr = se_pub, type = "general_z",
  plot_type = "p_val", est_names = "Brown et al. (2017), HDPS",
  conf_level = c(0.95, 0.80, 0.50), null_values = log(1),
  trans = "exp", alternative = "two_sided",
  xlab = "Hazard ratio", xlim = log(c(0.7, 4)),
  x_scale = "logarithm", plot = TRUE
)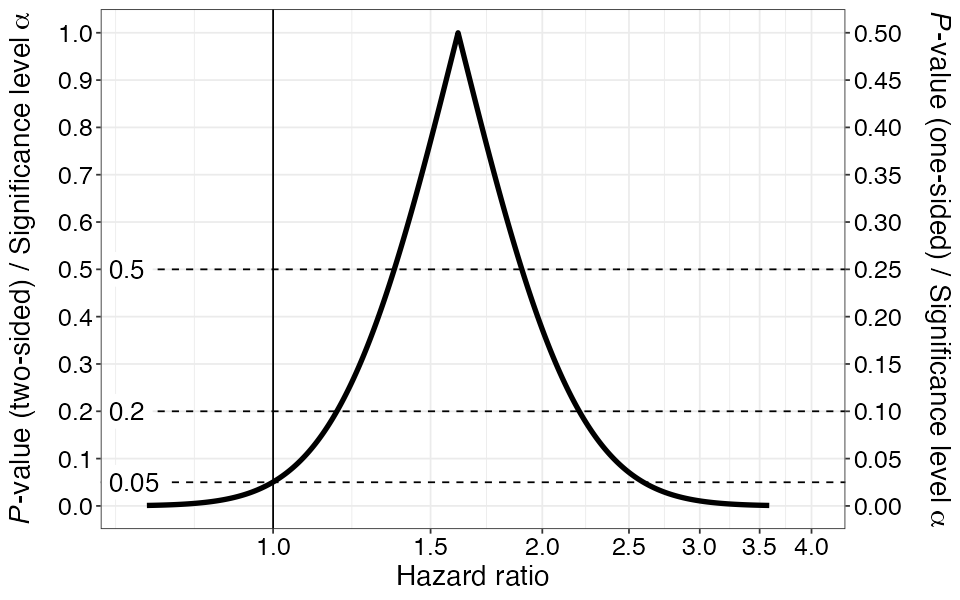
逆算したSEは約0.244で、HR = 1におけるp値は約0.051(S値で約4.3ビット)となり、Rafi & Greenland (2020) の値と一致する。一方、HR = 2におけるp値は約0.37であり、このデータは「関連なし(HR = 1)」よりも「リスク2倍(HR = 2)」のほうとよく両立していることが分かる。
なお、論文中のCIは丸められた値なので、逆算で再構成した95%CI(0.999〜2.59)は論文の値(0.997〜2.59)とわずかにずれる。あくまで近似的な再構成である点に注意したい。
この方法は、先行研究の「有意差なし」を読み直すときにも、自分の研究のDiscussionで先行研究と比較するときにも、そのまま使える。
4. 論文でそのまま使える英文テンプレート
以下の英文に含まれる数値は、本記事の疑似データ(研究B)に基づく記述例である。実際の論文では、ご自身の解析結果に置き換えて使ってほしい。
Methods
In addition to point estimates and 95% confidence intervals, we constructed P-value functions (also known as confidence curves or compatibility curves) for the main hazard ratio estimates, which display the two-sided P-values for all possible values of the hazard ratio rather than for the null hypothesis alone (Poole, 1987; Infanger & Schmidt-Trucksäss, 2019). P-value functions were computed from the estimated log hazard ratios and their standard errors using the R package pvaluefunctions (version 1.7.0).
(Methods:主要なハザード比の推定値について、点推定値と95%信頼区間に加えてp値関数〔confidence curve、compatibility curve とも呼ばれる〕を作成した。p値関数は、帰無仮説だけでなく、ハザード比のあらゆる値に対する両側p値を示すものである。p値関数は、推定された対数ハザード比とその標準誤差から、Rパッケージ pvaluefunctions〔バージョン1.7.0〕を用いて算出した。)
Results
The adjusted hazard ratio for the exposure was 1.38 (95% CI, 0.94 to 2.02; P = 0.096). As shown by the P-value function (Figure X), the data were most compatible with a hazard ratio of approximately 1.4, and the P-value for a hazard ratio of 2.0 (P = 0.056) was similar to that for the null hypothesis of no association.
(Results:曝露の調整ハザード比は1.38〔95%CI 0.94〜2.02、P = 0.096〕であった。p値関数〔図X〕に示すとおり、データが最もよく両立したのはハザード比約1.4であり、ハザード比2.0に対するP値〔P = 0.056〕は、関連なしという帰無仮説に対するP値と同程度であった。)
Discussion
Although the confidence interval included the null value, our results should not be interpreted as evidence of no association. The estimate was imprecise, and the data were compatible with hazard ratios ranging from a slight decrease to a twofold increase in risk (95% CI, 0.94 to 2.02). Larger studies are needed to estimate the magnitude of the association more precisely.
(Discussion:信頼区間は帰無値を含んでいたが、この結果を「関連がない」ことの根拠と解釈すべきではない。推定は不精確であり、データはリスクのわずかな低下から2倍の上昇までのハザード比と両立していた〔95%CI 0.94〜2.02〕。関連の大きさをより精確に推定するには、より大規模な研究が必要である。)
5. まとめ
- p値は「HR = 1」という一地点の標高、95%CIは「p = 0.05」という1本の等高線にすぎない
- p値関数は、あらゆる効果量の候補に対するp値をつないだ曲線で、推定結果の地形図全体を見せてくれる
- 山頂の位置は効果の大きさ、山の幅は推定の精度を表す。「有意差なし」の多くは「山頂は1から離れているが、裾が広い」状態である
- p値関数の高さは「真である確率」ではなく、モデルの仮定のもとでのデータとの両立性である
- 論文の点推定値と95%CIさえあれば、先行研究の結果も描き直せる
一括コピペ用Rスクリプト
# install.packages(c("survival", "pvaluefunctions"))
library(survival)
library(pvaluefunctions)

## Step 1: 疑似データの生成 ---------------------------------------------
make_cohort <- function(n) {
  severity  <- rnorm(n)                          # 潜在的な重症度(観測できない)
  sev_score <- severity + rnorm(n, sd = 0.5)     # 重症度スコア(観測できる代理指標)
  age       <- round(65 + 2.4 * severity + rnorm(n, sd = 8))
  exposed   <- rbinom(n, 1, plogis(-1 + 0.8 * severity))     # 重症ほど曝露されやすい
  rate      <- 0.03 * exp(log(1.4) * exposed + 0.6 * severity) # 真のHR = 1.4
  t_event   <- rexp(n, rate)
  time      <- pmin(t_event, 5)                  # 5年で打ち切り
  event     <- as.integer(t_event <= 5)
  data.frame(exposed, sev_score, age, time, event)
}

set.seed(42)
studyA <- make_cohort(4000)   # 大規模コホート
studyB <- make_cohort(800)    # 小規模コホート

fitA <- coxph(Surv(time, event) ~ exposed + sev_score + age, data = studyA)
fitB <- coxph(Surv(time, event) ~ exposed + sev_score + age, data = studyB)

bA  <- coef(fitA)["exposed"];  seA <- sqrt(vcov(fitA)["exposed", "exposed"])
bB  <- coef(fitB)["exposed"];  seB <- sqrt(vcov(fitB)["exposed", "exposed"])

c(events_A = sum(studyA$event), events_B = sum(studyB$event))
round(rbind(
  StudyA = c(HR = exp(bA), lower = exp(bA - 1.96 * seA), upper = exp(bA + 1.96 * seA),
             P = 2 * pnorm(-abs(bA / seA))),
  StudyB = c(HR = exp(bB), lower = exp(bB - 1.96 * seB), upper = exp(bB + 1.96 * seB),
             P = 2 * pnorm(-abs(bB / seB)))
), 3)

## Step 2: base R でp値関数を自作する -----------------------------------
pfun <- function(hr, est, se) 2 * pnorm(-abs(log(hr) - est) / se)

hr_grid <- exp(seq(log(0.6), log(3), length.out = 1000))

plot(hr_grid, pfun(hr_grid, bB, seB), type = "l", lwd = 2, log = "x",
     xlab = "Hazard ratio (log scale)", ylab = "P-value",
     main = "P-value function (Study B)")
abline(h = c(0.05, 0.20), lty = 2, col = "grey40")   # 95%CI と 80%CI の「等高線」
abline(v = 1, lty = 3)
text(0.65, c(0.08, 0.23), c("95% CI", "80% CI"), adj = 0, col = "grey40")

pfun(2, bB, seB)   # HR = 2 に対するp値

## Step 3: pvaluefunctions で描く(研究A・Bの重ね描き) -----------------
res_AB <- conf_dist(
  estimate    = c(bA, bB),
  stderr      = c(seA, seB),
  type        = "coxreg",
  plot_type   = "p_val",
  est_names   = c("Study A (n = 4000)", "Study B (n = 800)"),
  conf_level  = c(0.95, 0.80),
  null_values = log(1),              # 帰無値は対数スケールで指定
  trans       = "exp",
  alternative = "two_sided",
  xlab        = "Hazard ratio",
  xlim        = log(c(0.7, 2.5)),    # 軸の範囲も対数スケールで指定
  together    = TRUE,
  x_scale     = "logarithm",
  plot        = TRUE
)
res_AB$conf_frame    # 各信頼水準の信頼区間

# S値(surprisal)の曲線
res_S <- conf_dist(
  estimate = c(bA, bB), stderr = c(seA, seB), type = "coxreg",
  plot_type = "s_val", est_names = c("Study A", "Study B"),
  null_values = log(1), trans = "exp", alternative = "two_sided",
  xlab = "Hazard ratio", xlim = log(c(0.7, 2.5)),
  together = TRUE, x_scale = "logarithm", plot = TRUE
)

## Step 4: 既存論文の数値から描き直す(Brown et al. 2017, HDPS解析) ----
hr <- 1.61; lower <- 0.997; upper <- 2.59
b_pub  <- log(hr)
se_pub <- (log(upper) - log(lower)) / (2 * qnorm(0.975))   # 95%CIからSEを逆算
c(SE = se_pub, P_at_HR1 = 2 * pnorm(-abs(b_pub / se_pub)),
  S_at_HR1 = -log2(2 * pnorm(-abs(b_pub / se_pub))))

res_pub <- conf_dist(
  estimate = b_pub, stderr = se_pub, type = "general_z",
  plot_type = "p_val", est_names = "Brown et al. (2017), HDPS",
  conf_level = c(0.95, 0.80, 0.50), null_values = log(1),
  trans = "exp", alternative = "two_sided",
  xlab = "Hazard ratio", xlim = log(c(0.7, 4)),
  x_scale = "logarithm", plot = TRUE
)
6. 参考文献
- Birnbaum A. Confidence curves: an omnibus technique for estimation and testing statistical hypotheses. Journal of the American Statistical Association. 1961;56(294):246–249. https://www.tandfonline.com/doi/abs/10.1080/01621459.1961.10482107
- Poole C. Beyond the confidence interval. American Journal of Public Health. 1987;77(2):195–199. https://doi.org/10.2105/AJPH.77.2.195
- Poole C. Confidence intervals exclude nothing. American Journal of Public Health. 1987;77(4):492–493. https://doi.org/10.2105/AJPH.77.4.492
- Bender R, Berg G, Zeeb H. Tutorial: Using confidence curves in medical research. Biometrical Journal. 2005;47(2):237–247. https://doi.org/10.1002/bimj.200410104
- Infanger D, Schmidt-Trucksäss A. P value functions: An underused method to present research results and to promote quantitative reasoning. Statistics in Medicine. 2019;38(21):4189–4197. https://doi.org/10.1002/sim.8293
- Fraser DAS. The p-value function and statistical inference. The American Statistician. 2019;73(sup1):135–147. https://doi.org/10.1080/00031305.2018.1556735
- Rafi Z, Greenland S. Semantic and cognitive tools to aid statistical science: replace confidence and significance by compatibility and surprise. BMC Medical Research Methodology. 2020;20:244. https://doi.org/10.1186/s12874-020-01105-9
- Greenland S, Senn SJ, Rothman KJ, Carlin JB, Poole C, Goodman SN, Altman DG. Statistical tests, P values, confidence intervals, and power: a guide to misinterpretations. European Journal of Epidemiology. 2016;31(4):337–350. https://doi.org/10.1007/s10654-016-0149-3
- Brown HK, Ray JG, Wilton AS, Lunsky Y, Gomes T, Vigod SN. Association between serotonergic antidepressant use during pregnancy and autism spectrum disorder in children. JAMA. 2017;317(15):1544–1552. https://doi.org/10.1001/jama.2017.3415
- Rosenthal R, Rubin DB. The counternull value of an effect size: A new statistic. Psychological Science. 1994;5(6):329–334. https://doi.org/10.1111/j.1467-9280.1994.tb00281.x
- Greenland S, Pearl J, Robins JM. Confounding and collapsibility in causal inference. Statistical Science. 1999;14(1):29–46. https://doi.org/10.1214/ss/1009211805
- Infanger D. pvaluefunctions: Creates and Plots P-Value Functions, S-Value Functions, Confidence Distributions and Confidence Densities. R package version 1.7.0. https://CRAN.R-project.org/package=pvaluefunctions
おすすめ書籍
- Lash TL, VanderWeele TJ, Haneuse S, Rothman KJ(編). 現代疫学 原著第4版(佐藤俊太朗・藤井亮輔・芝孝一郎・後藤匡啓・今村文昭 監訳). 学術図書出版社, 2024.
疫学のバイブル『Modern Epidemiology』の日本語訳。本記事の背景にある、推定・検定の考え方を深く学べる。
https://www.amazon.co.jp/dp/4780612454 - Lash TL, VanderWeele TJ, Haneuse S, Rothman KJ. Modern Epidemiology, 4th ed. Wolters Kluwer, 2021.
上記の原著。英語で読みたい方に。
https://www.amazon.co.jp/dp/1451193289 - Schweder T, Hjort NL. Confidence, Likelihood, Probability: Statistical Inference with Confidence Distributions. Cambridge University Press, 2016.
confidence curve や信頼分布を理論面から体系的に学びたい方向けの専門書。
https://www.amazon.co.jp/dp/0521861608


コメント