後輩:「先輩、知り合いの喫茶店のマスターに相談されたんです。アイスコーヒーの売上が10年でじわじわ伸びている気がするから、それを数字で確かめたいって」
先輩:「月ごとの売上データがあるのかい?」
後輩:「はい、10年分で120か月あります。横軸に時間、縦軸に売上を取って回帰直線を引き、傾きのP値を見ればいいですよね?」
先輩:「その前にグラフを見てごらん。夏に跳ね上がって冬に落ち込む波があるだろう。それに、よく売れた月の翌月もよく売れる、というクセもありそうだ。回帰直線のP値が前提にしている『誤差は互いに独立でばらつき方も同じ』という条件は、たぶん満たされていない」
後輩:「じゃあ、どうすれば……」
先輩:「こういうときに頼りになるのが Mann-Kendall検定 だ。以前に紹介したケンドールの順位相関係数を覚えているかい? あれを”時間”に使う検定なんだよ」
時系列データのトレンド(傾向)を調べる方法として、Mann-Kendall検定(以下、MK検定)は気象学・水文学・環境科学で最もよく使われる手法の一つである。正規分布を仮定しないノンパラメトリックな手法で、仕組みも驚くほど単純だ。
本記事では、ケンドールの順位相関係数の考え方をそのまま時系列に当てはめるところから始める。そのうえで、初学者がハマりやすい3つの罠(自己相関・季節性・途中での方向転換)と、その対処法までをRで一気に確認する。
ケンドールの順位相関係数そのものについては、以前の記事で解説している。まだ読んでいない方は、先に目を通しておくと理解がスムーズだ。
1. Mann-Kendall検定とは?「全員と握手して背比べ」
仕組みはたったこれだけ
MK検定の中身は、次のような背比べ大会だとイメージするとよい。
120か月分の売上データを、古い順に一列に並べる。そして各月が、自分より後ろにいるすべての月と一人ずつ握手をして、こう尋ねる。
「あなたは私より大きいですか?」
- 相手の方が大きければ +1
- 相手の方が小さければ −1
- 同じなら 0
これを全ペア(120か月なら 120×119÷2 = 7,140組)で行い、合計した点数が検定統計量 S である。
- 時間とともに売上が増えていれば「後ろの方が大きい」ペアが多くなり、Sは大きなプラスになる
- 減っていればSは大きなマイナスになる
- 傾向がなければ+1と−1が打ち消し合い、Sは0の近くに落ち着く
Sが0からどれだけ離れているかを、「傾向がない」と仮定したときの散らばり(分散)と比べて判定する。これがMK検定である。
「大きさ」ではなく「勝ち負け」だけを見る
握手の場面で聞いているのは「どちらが大きいか」だけで、「どれくらい大きいか」は問わない。そのため、
- ある月だけ団体客が来て売上が異常に跳ねた(外れ値)
- データの分布が左右非対称である
といった状況でも、結果が大きく振り回されない。正規分布を仮定する必要がないのは、この「勝ち負けだけを見る」設計のおかげである。
実は「時間」とのケンドールの順位相関そのもの
ケンドールの順位相関係数(τ)の記事では、2つの変数xとyについて「ペアの大小関係がそろっているか(一致)、逆になっているか(不一致)」を数えた。
MK検定は、このxに 時間(1, 2, 3, …, 120か月目) を入れたものにほかならない。時間は必ず「後ろの方が大きい」ので、yが「後ろの方が大きい」なら一致(+1)、「後ろの方が小さい」なら不一致(−1)になる。握手の背比べとまったく同じである。
したがって、MK検定の結果にはKendallのτが一緒に出てくる。τは −1〜+1 の値を取り、
- +1:毎月必ず前の月をすべて上回る(完全な右肩上がり)
- 0:上下の傾向なし
- −1:完全な右肩下がり
を意味する。τは「傾向の一貫性」を表す効果量として読むことができる。
※コラム:「単調な傾向」ってどういう意味?
MK検定が見つけられるのは「単調な(monotonic)」傾向である。単調とは「途中で向きが変わらない」という意味で、直線である必要はない。ゆるやかな坂でも、途中から急になる坂でも、ずっと上り続けていれば「単調増加」だ。逆に、5年間上がって5年間下がる「山型」のデータでは、前半の+1と後半の−1が打ち消し合い、Sが0に近づいてしまう。MK検定は「山登りの途中で引き返したかどうか」は教えてくれない。
2. 傾きの「大きさ」はSen’s slopeで語る
MK検定が答えてくれないこと
MK検定が答えるのは「一貫して上がっている(下がっている)と言えるか」という 向き の問いだけである。「1か月あたり何杯増えているのか」という 大きさ には答えない。
ここで大事な注意がある。
P値が小さいことは、「急激に増えている」ことを意味しない。
MK検定のP値は、データの数(期間の長さ)が増えるほど小さくなりやすい。100年分の気温データなら、年0.01℃というごくわずかな上昇でも P < 0.001 になり得る。P値はあくまで「偶然とは考えにくいか」の判断材料であり、変化の大きさの物差しではない。
大きさを語るときに使うのが、Sen’s slope(センの傾き) である。
全ペアの傾きの「真ん中」を取る
Sen’s slopeの考え方も、握手の比喩で説明できる。
握手した2つの月のペアごとに、「2か月の売上の差 ÷ 2か月の間隔」を計算すれば、そのペアなりの「傾き」が1つ出る。7,140組あれば、7,140通りの傾きが手に入る。その 中央値 を取ったものがSen’s slopeである(Sen, 1968)。
7,140人に「この10年で1か月あたり何杯増えたと思う?」と聞き、その答えを小さい順に並べて真ん中の人の答えを採用する。そんな「多数決の真ん中」をイメージするとよい。中央値なので、極端な答え(外れ値の影響を受けたペア)が紛れ込んでも、結果はほとんど動かない。
Sen’s slopeは元のデータと同じ単位(ここでは「杯/月」)を持つため、「1か月あたり約0.5杯、1年で約6杯増えている」のように、そのまま現場の言葉に翻訳できる。論文や報告では、MK検定のP値とSen’s slope(とその95%信頼区間)をセットで示すのが基本である。
3. 初学者がハマる3つの罠
MK検定は単純で頑健な手法だが、万能ではない。特に次の3つは、実際のデータ分析で頻繁に問題になる。
罠①:自己相関 ―「仲良しグループの多数決」
MK検定は、各月のデータが 互いに独立である ことを前提にしている。ところが実際の時系列データは、たいてい「先月の状態を引きずる」。よく売れた月の翌月もよく売れやすく、不調の月の翌月も不調になりやすい。これを 自己相関(系列相関)という。
これは、クラスで多数決をとるときに、いつも同じ意見を言い合う仲良しグループが混ざっている状況に似ている。30人のクラスでも、5人組の仲良しグループが6つあるなら、実質的には「6票分の独立した意見」しかない。それを30票として数えると、「圧倒的多数で可決!」と、実態以上に自信満々な結論が出てしまう。
正の自己相関がある時系列にそのままMK検定を使うと、これと同じことが起きる。Sの散らばりが本来より小さく見積もられ、実際には傾向がないのに「有意なトレンドあり」と判定してしまう確率(第一種の過誤)が高くなる ことが知られている(Hamed & Rao, 1998; Yue et al., 2002)。
代表的な対処法は2つある。
- 分散の補正(Hamed & Rao, 1998):自己相関の強さから「実質的なデータ数(有効サンプルサイズ)」を見積もり、Sの分散を広げて補正する。仲良しグループを「1グループ=実質1票」として数え直すイメージである
- プリホワイトニング(Yue et al., 2002 など):データから自己相関の成分を取り除いてから検定する
本記事では、考え方がわかりやすく実装も簡単な前者(Hamed & Raoの補正)を使う。
※コラム:自己相関とコレログラムの読み方
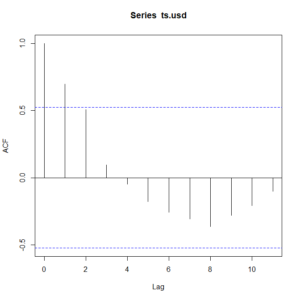
自己相関は、「データを k か月ずらしたもの」と「元のデータ」の相関係数である。kを1, 2, 3, …と変えながら相関係数を棒グラフにしたものを コレログラム と呼び、Rではacf()関数で描ける。青い点線は「自己相関がゼロでも偶然この程度は出る」という目安の範囲だ。棒がこの範囲を大きくはみ出していれば、自己相関がある。ラグ1(1か月ずらし)の棒が高ければ「先月を引きずる」タイプ、ラグ12の棒が高ければ「毎年同じ月に同じような値になる」、つまり季節性があるサインである。ただし、ゆるやかな季節の波やトレンドがあるだけでもラグ1の棒は高くなる(隣の月同士は、波の上で近い位置にいるため)。純粋な「引きずり」を見たいときは、トレンドと季節を取り除いた 残差 のコレログラムを見るのが確実である(Step 5で実演する)。
罠②:季節性 ―「7月と1月で背比べをしない」
アイスコーヒーは夏に売れ、冬には売れない。このような季節の波を持つデータにMK検定をそのまま使うと、握手の背比べは「7月 vs 翌年1月」のような、季節の違いが丸ごと入り込んだ比較だらけになる。これでは、年ごとに売上が伸びているかどうかという本来の問いが、夏冬の波に埋もれてしまう。
そこで使うのが Seasonal Kendall検定(季節型Mann-Kendall検定、Hirsch et al., 1982)である。やり方は単純で、
- 1月は1月同士、2月は2月同士……と 同じ月の中だけで 背比べ(MK検定のS)を行う
- 12か月分のSと分散を合計して、全体として判定する
というものだ。「7月の成績は、去年の7月と比べる」。前年同月比の発想と同じである。
同様に、傾きも同じ月同士のペアだけから計算する 季節型Sen’s slope がある。こちらは「1年あたり何杯増えたか」という単位で得られる。
ただし、季節型にしても罠①(自己相関)が消えるわけではない。月と月が連動しているデータでは、さらに補正が必要になる(Hirsch & Slack, 1984)。この点はRの実装編(Step 8)で確かめる。
罠③:途中で流れが変わる ―「山登りの途中で引き返した」
コラムで述べたとおり、MK検定は「全期間を通して一方向か」しか問わない。「最初の5年は増えていたが、ある時点から減り始めた」ようなデータでは、MK検定は「傾向なし」と答えることがあり、それは「何も起きていない」という意味ではない。
「どこで流れが変わったのか」を知りたい場合は、変化点検出 の手法(Pettitt検定など)を使う。医学分野でも、Chenら(2022)が米国各州のCOVID-19週次症例数に、MK検定を応用した変化点検出法(Mann-Kendall-Sneyers検定)を適用し、流行の増加・減少の転換点を特定している。本記事では詳しく扱わないが、「MK検定で有意でない=変化なし、とは限らない」ことは頭に入れておきたい。
4. Rで実装してみよう(Step by Step)
ここからは、喫茶店のアイスコーヒー売上を模した疑似データで、ここまでの内容を確認していく。
使用するパッケージは次の3つである。
Kendall:前回の記事でも使ったパッケージ。MannKendall()関数で基本のMK検定ができるtrend:Sen’s slope(sens.slope())、Seasonal Kendall検定(smk.test())、相関補正付きSeasonal Kendall検定(csmk.test())、季節型Sen’s slope(sea.sens.slope())などmodifiedmk:自己相関を補正したMK検定(mmkh())
install.packages(c("Kendall", "trend", "modifiedmk"))

library(Kendall)
library(trend)
library(modifiedmk)
Step 1:疑似データを作る
2016年1月〜2025年12月の120か月分の売上(杯/月)を、次の3つの要素を足し合わせて作る。
- トレンド:1か月あたり0.3杯ずつ増える(これが「真の傾き」)
- 季節性:8月をピークに、夏は+40杯、冬は−40杯ほど上下する波
- 自己相関のある誤差:前月の誤差の7割を引き継ぐノイズ(AR(1)モデル、係数0.7)
罠①と罠②がちゃんと再現されるように、あえて「季節の波」と「先月を引きずるクセ」を仕込んでいる。
set.seed(32)

n     <- 120                        # 10年 × 12か月
t     <- 1:n                        # 時間(1〜120か月目)
month <- rep(1:12, times = 10)      # 月(1〜12)

trend  <- 0.3 * t                                  # 真のトレンド:月0.3杯増
season <- 40 * cos(2 * pi * (month - 8) / 12)      # 8月ピークの季節の波
noise  <- as.numeric(arima.sim(model = list(ar = 0.7), n = n, sd = 20))  # 自己相関のある誤差

sales <- round(300 + trend + season + noise)

# 時系列オブジェクト(ts)に変換:2016年1月開始、1年=12期
sales_ts <- ts(sales, start = c(2016, 1), frequency = 12)
Step 2:まずはグラフで目視する
どんな検定をするにしても、最初にやるべきはグラフを描くことである。
plot(sales_ts, type = "o", pch = 16, cex = 0.6,
     xlab = "Year", ylab = "Iced coffee sales (cups/month)",
     main = "Monthly iced coffee sales")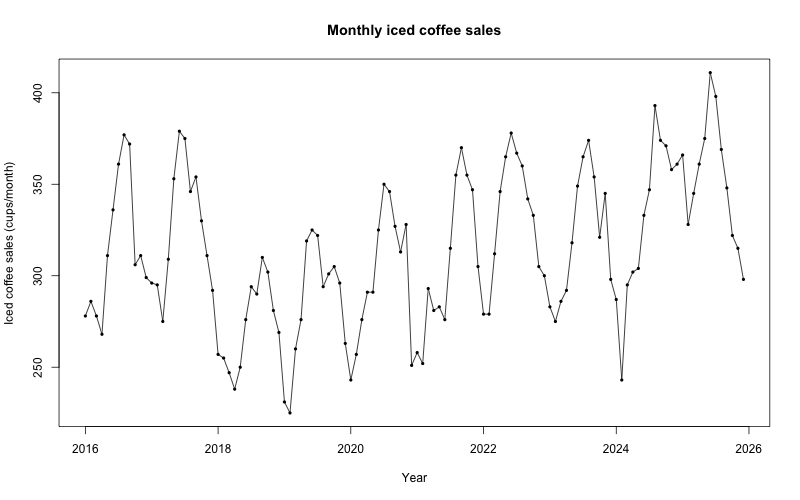
グラフのタイトルや軸ラベルは英語にしている。Macなどでは、フォントを指定せずに日本語を使うと文字が「□」(いわゆる豆腐)に化けることがあるためだ。
毎年夏に山、冬に谷が来る波がはっきり見える。そのうえで、波全体がゆるやかに右上がりになっているようにも見える。ただし2018〜2019年ごろには一度落ち込んでおり、「10年で伸びている」と言い切ってよいかは、目視だけでは判断しにくい。
Step 3:基本のMK検定
まずは罠を気にせず、そのままMK検定をかけてみる。
MannKendall(sales)出力には tau(Kendallのτ)と 2-sided pvalue(両側P値)が表示される。結果は τ = 0.242、P = 9.7×10⁻⁵(P < 0.001)であった。
「時間が進むほど売上が大きい」ペアの方が多く、その偏りは偶然とは考えにくい。つまり、統計学的に有意な増加傾向があるという判定である。τ = 0.24 は、完全な右肩上がり(τ = 1)には程遠い、「波やブレを含みつつも全体としては上向き」程度の一貫性を示している。
参考までに、base Rの
cor.test(t, sales, method = "kendall")でも τ = 0.242、P = 9.6×10⁻⁵ と、ほぼ同じ結果が得られる(P値の最後の桁のわずかな差は、同順位の扱いや連続修正といった計算上の細部の違いによる)。MK検定が「時間とのケンドールの順位相関」であることを、自分の手で確かめてみてほしい。
Step 4:Sen’s slopeで傾きの大きさを見る
sens.slope(sales)出力の Sen's slope が傾きの推定値、95 percent confidence interval がその95%信頼区間である。結果は Sen’s slope = 0.465杯/月(95%信頼区間 0.234〜0.682) であった。
1か月あたり約0.46杯、1年に直すと約5.6杯の増加である。月平均の売上は約314杯なので、1年あたり2%に満たない、ごくゆるやかな伸びということになる。Step 3のP値は0.001を下回っていたが、それは「急増している」ことを意味しない。まさに第2章で述べたとおりである。
なお、疑似データの「真の傾き」は0.3杯/月であった。推定値0.46はノイズの影響でやや上振れしているが、95%信頼区間はちゃんと0.3を含んでいる。点推定だけでなく信頼区間を示す意味が、ここからもわかる。
注意:
sens.slope()の95%信頼区間は、MK検定と同じく「データが互いに独立」という前提で計算されている。後で見るように、このデータには自己相関があるため、実際の不確かさはこの区間より大きい(区間は狭すぎる)と考えるべきである。
Step 5:コレログラムで自己相関をチェックする
まずは生データのコレログラムを描く。
acf(sales, lag.max = 24,
    main = "Correlogram of monthly sales")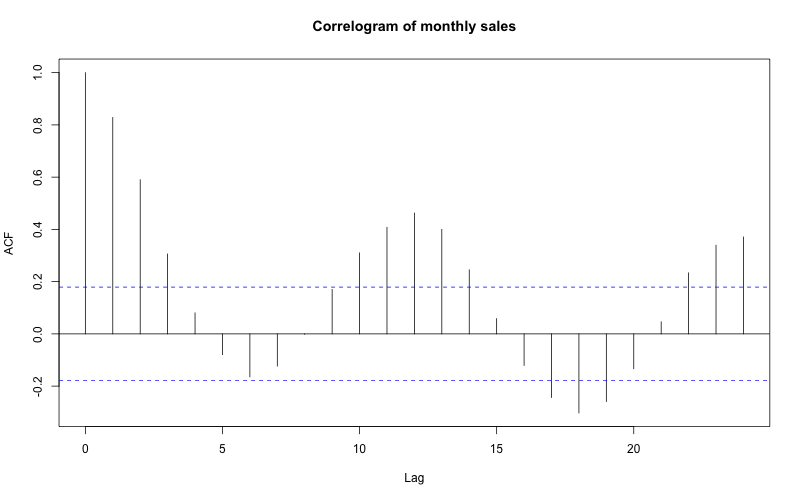
横軸はずらした月数(ラグ)である。ラグ1〜3の棒が高く(ラグ1で約0.8)、ラグ12・24付近で再び高くなり、ラグ6・18付近ではマイナスになっている。1年周期の波、つまり罠②の季節性がはっきり写っている。
ここで注意したいのは、ラグ1〜3の高さは、季節の波だけでも生じる という点である。実際、今回のデータに入れた季節の波(コサイン曲線)だけでコレログラムを計算しても、ラグ1は約0.86になる。生データのコレログラムだけでは、「先月を引きずるクセ」なのか「季節の波の副産物」なのかを区別できない。
そこで、トレンドと季節を取り除いた 残差 のコレログラムを描く。lm() に時間 t と月 factor(month) を入れて回帰し、その残差を取り出すだけである。
# トレンド(t)と季節(月ごとの平均の違い)を取り除いた残差
resid_sales <- residuals(lm(sales ~ t + factor(month)))

acf(resid_sales, lag.max = 24,
    main = "Correlogram of residuals (trend and season removed)")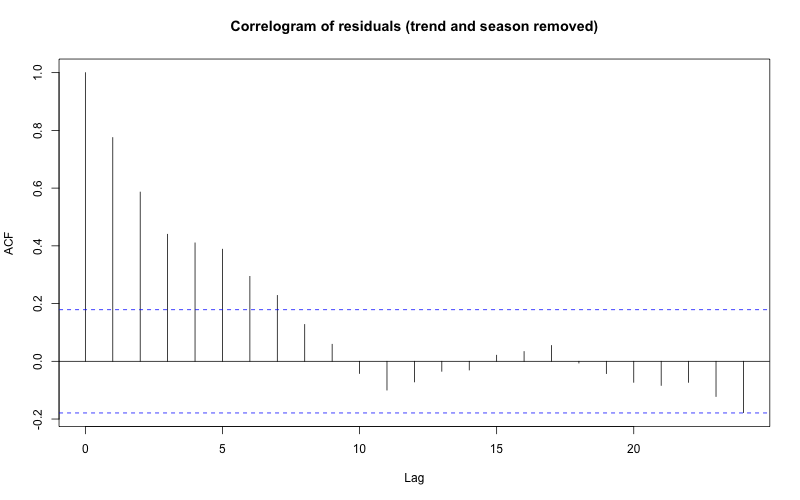
factor(month) は、「月を数値ではなく1月・2月……というカテゴリとして扱う」という指定である。これで各月の平均的な水準の違い(季節性)が取り除かれる。
棒の高さを数値で確認したいときは、plot = FALSE を指定して値を取り出す(先頭の要素はラグ0=常に1なので除く)。
# ラグ1〜3の自己相関係数を数値で表示
round(acf(resid_sales, lag.max = 3, plot = FALSE)$acf[2:4], 2)残差のコレログラムでは、季節の波は消えている。一方で、ラグ1が約0.78、ラグ2が約0.59、ラグ3が約0.44と、なだらかに減っていく 形が残る。これこそが罠①の自己相関、「先月を引きずるクセ」の正体である。
このデータには、罠①と罠②の両方が潜んでいることがはっきりした。
Step 6:自己相関を補正したMK検定(Hamed & Rao法)
mmkh(sales)mmkh() の出力には補正前と補正後の結果が並んで表示される。
Original Z/old P.value:補正前(Step 3に相当)Corrected Zc/new P-value:自己相関を補正した後N/N*:実データ数が有効サンプルサイズの何倍か。「仲良しグループによる水増し率」に相当する
結果は、Zが補正前の3.90から補正後は 2.67 に縮み、P値は9.7×10⁻⁵から 0.0075 に大きくなった。N/N*は 2.12 で、「120か月のデータは、独立なデータに換算すると半分程度の情報量しかない」ことを意味する。
このデータでは補正後も有意ではあったが、自己相関を無視すると「偶然とは考えにくい度合い」、つまり証拠の強さをかなり過大に見積もっていたことがわかる。系列によっては、補正によって有意でなくなることも珍しくない。
注意:Step 5の生データのコレログラムで見たとおり、このデータの自己相関には季節の波も混ざっている。
mmkh()はそれも含めて「引きずり」として補正するため、季節性のはっきりした月次データには、次のStep 7・Step 8の方法の方が適切である。mmkh()が本領を発揮するのは、年次データのように季節性のない系列である。
Step 7:季節性に配慮したSeasonal Kendall検定
# 季節型MK検定(同じ月同士で比較)
smk.test(sales_ts)

# 季節型Sen's slope(1年あたりの傾き)
sea.sens.slope(sales_ts)
smk.test() には、ts 形式(frequency = 12 を指定したもの)のデータを渡す点に注意する。出力には全体のZとP値、そして12か月分を合計したS(S)とその分散(varS)が表示される。
結果は Z = 4.32、P = 1.6×10⁻⁵(P < 0.001)であった。季節型Sen’s slopeは 4.5杯/年(月あたりに直すと約0.38杯)であった。このデータでは、Step 4のSen’s slope(年約5.6杯)よりも真の値(年3.6杯)に近かったが、これは乱数1回分の結果であり、季節型の方が常に正確だという意味ではない。
同じ月同士で比べると、夏冬の波の影響を受けずに「前年同月より増えているか」を問うことができる。
月ごとの結果は summary() で確認できる。
summary(smk.test(sales_ts))今回のデータでは、12か月のうち2月(S = −1)を除く11か月でSがプラスであった。「どの月でも、おおむね前年同月より増えている」という一貫した傾向が読み取れる。ただし、12か月分の検定を個別に解釈すると多重比較の問題が生じるため、月別のP値に一喜一憂せず、月別の結果はあくまで記述的な参考にとどめるのが無難である。
Step 8:季節型でも「仲良しグループ」は残る(相関補正付きSeasonal Kendall検定)
実は、Step 7にも落とし穴がある。smk.test() は、12か月それぞれの系列が互いに独立である と仮定している。ところがStep 5の残差のコレログラムで見たとおり、このデータは「先月を引きずる」。7月によく売れた年は8月もよく売れやすく、7月の背比べの結果(S)と8月の背比べの結果は連動してしまう。
これは罠①の「仲良しグループ」が、月の単位で再登場した状態である。12か月分のSを「12の独立した意見」として合計すると、やはり票が水増しされる。
この連動(月と月の間の相関)まで考慮するのが、相関補正付きSeasonal Kendall検定(Hirsch & Slack, 1984)である。trend パッケージの csmk.test() で実行できる。
csmk.test(sales_ts)結果は Z = 1.75、P = 0.080 となり、有意水準5%では有意にならなかった。
ここで早合点してはいけない。この疑似データには、真のトレンド(年3.6杯の増加)が確かに入っている。それでも有意にならなかったのは、「10年分・自己相関の強いデータ」から年3〜4杯というゆるやかな伸びを確かめるには、情報量が足りなかったからである。有意でないことは、「伸びていない」ことの証明ではない。
一方、季節型Sen’s slope(年4.5杯)は、どの検定を使っても変わらない。P値が「確かめられたかどうか」を教えてくれるのに対し、Sen’s slopeは「どれくらい変化していそうか」を教えてくれる。両者を分けて報告することの大切さが、ここでも確認できる。
※コラム:P = 0.080は「有意傾向」?
論文では、P = 0.05〜0.10を「有意傾向(marginally significant)」と書く例を見かける。しかし、これはP値を「傾向の強さ」のように扱う表現であり、避けた方がよい。報告すべきは、P値そのもの(P = 0.080)と、Sen’s slopeなどの効果の大きさである。
どれを使えばよいか:判断のフローチャート
| データの特徴 | 推奨される方法 | Rの関数 |
|---|---|---|
| 季節性なし・自己相関なし | 通常のMK検定 + Sen’s slope | MannKendall(), sens.slope() |
| 季節性なし・自己相関あり(年次データなど) | 自己相関補正MK検定 + Sen’s slope | mmkh() |
| 季節性あり・自己相関なし(月次・四半期データなど) | Seasonal Kendall検定 + 季節型Sen’s slope | smk.test(), sea.sens.slope() |
| 季節性あり・自己相関あり | 相関補正付きSeasonal Kendall検定 + 季節型Sen’s slope | csmk.test(), sea.sens.slope() |
| 途中で向きが変わりそう | 変化点検出(Pettitt検定など)を検討 | pettitt.test() など |
どの場合も、最初にグラフ(Step 2)とコレログラム(Step 5)で、データの素顔を確認する ことが出発点になる。
もう一つ大切なのは、検定を選ぶのは結果を見る前 だということである。本記事では説明のために同じデータに何種類もの検定をかけたが、実際の研究で「一番P値が小さかった検定を報告する」のは、いわゆるP値ハッキングである。データの特徴(季節性・自己相関)から主解析を事前に決め、それ以外の検定は感度分析として、結果にかかわらずすべて報告する。
5. 論文でそのまま使える英文テンプレート
以下はあくまで 記述例 である。[ ]内の数値は、ご自身のデータで実際に得られた値に必ず置き換えてほしい。
Methods
Temporal trends in [monthly sales] from [January 2016] to [December 2025] were assessed using non-parametric Mann-Kendall-type trend tests (Mann, 1945; Kendall, 1975), which do not assume normality of the data. Serial correlation was examined using the autocorrelation function of the residuals after removing the linear trend and monthly effects. Because the series showed marked seasonality and serial correlation, the seasonal Kendall test with correction for dependence among seasons (Hirsch and Slack, 1984) was used as the primary analysis. The seasonal Kendall test without this correction (Hirsch et al., 1982) was also reported for reference. The magnitude of the trend was estimated with the seasonal Sen’s slope estimator (Sen, 1968; Hirsch et al., 1982). All analyses were performed using R version [4.x.x] with the trend package. A two-sided P value < 0.05 was considered statistically significant.
Results
The autocorrelation function of the residuals from a linear regression on time and calendar month indicated positive serial correlation (lag-1 autocorrelation, [0.78]). The seasonal Kendall test corrected for dependence among seasons did not show a statistically significant trend in [monthly sales] (Z = [1.75], P = [0.080]). The estimated seasonal Sen’s slope was [4.5] [cups] per year, corresponding to approximately [1.4]% of the mean monthly value per year. The seasonal Kendall test without correction for serial dependence yielded Z = [4.32] (P < [0.001]); however, this test assumes independence among seasons, which was not supported by the data.
使う際の注意
- 「強い増加傾向(strong trend)」のように、P値の小ささを根拠に傾向の強さを表現しない。傾向の大きさはSen’s slope(と信頼区間)、一貫性はKendallのτで述べる
sea.sens.slope()は信頼区間を出力しない。信頼区間を報告したい場合は、自己相関を考慮したブートストラップ(ブロック・ブートストラップなど)などで別途求める必要がある。なおsens.slope()が出力する信頼区間はデータの独立性を前提としているため、自己相関がある場合は狭すぎる点に注意する- 有意な結果が得られた場合は、Resultsの1文目を “showed a statistically significant increasing trend” のように書き換える
- 季節性のないデータの場合は、季節型に関する文を削除し、Mann-Kendall検定+Sen’s slopeを基本とし、自己相関がある場合はHamed and Rao (1998) の補正(
modifiedmk::mmkh())を主解析として記述する
まとめ
- MK検定は「全員と握手して背比べ」。時間とのケンドールの順位相関そのもので、正規分布を仮定せず、外れ値にも強い
- 傾向の大きさはSen’s slopeで語る。P値の小ささは「急増」を意味しない。P値とSen’s slope(95%信頼区間)をセットで報告する
- 3つの罠に注意する
- 自己相関(仲良しグループの水増し票)→ Hamed & Raoの補正(
mmkh()) - 季節性(7月と1月で背比べしない)→ Seasonal Kendall検定(
smk.test())。自己相関もあるなら相関補正付き(csmk.test()) - 途中での方向転換 → 変化点検出を検討
- 自己相関(仲良しグループの水増し票)→ Hamed & Raoの補正(
- まずはグラフとコレログラム。コレログラムは、トレンドと季節を除いた残差でも確認する。データの素顔を見てから、結果を見る前に使う検定を選ぶ
- 有意でない=変化なし、ではない。「確かめられたか(P値)」と「どれくらい変化していそうか(Sen’s slope)」は分けて語る
一括コピペ用Rスクリプト
# ============================================================
# Mann-Kendall検定による時系列トレンド解析
# ============================================================

# --- パッケージ ---
# install.packages(c("Kendall", "trend", "modifiedmk"))
library(Kendall)
library(trend)
library(modifiedmk)

# --- Step 1:疑似データの作成 ---
set.seed(32)
n     <- 120
t     <- 1:n
month <- rep(1:12, times = 10)

trend  <- 0.3 * t
season <- 40 * cos(2 * pi * (month - 8) / 12)
noise  <- as.numeric(arima.sim(model = list(ar = 0.7), n = n, sd = 20))

sales    <- round(300 + trend + season + noise)
sales_ts <- ts(sales, start = c(2016, 1), frequency = 12)

# --- Step 2:時系列グラフ ---
plot(sales_ts, type = "o", pch = 16, cex = 0.6,
     xlab = "Year", ylab = "Iced coffee sales (cups/month)",
     main = "Monthly iced coffee sales")

# --- Step 3:基本のMK検定 ---
MannKendall(sales)
cor.test(t, sales, method = "kendall")   # 検算:時間とのケンドールの順位相関

# --- Step 4:Sen's slope ---
sens.slope(sales)

# --- Step 5:コレログラム(生データ/残差)---
acf(sales, lag.max = 24, main = "Correlogram of monthly sales")
resid_sales <- residuals(lm(sales ~ t + factor(month)))
acf(resid_sales, lag.max = 24,
    main = "Correlogram of residuals (trend and season removed)")
round(acf(resid_sales, lag.max = 3, plot = FALSE)$acf[2:4], 2)   # ラグ1〜3の値

# --- Step 6:自己相関を補正したMK検定(Hamed & Rao法)---
mmkh(sales)

# --- Step 7:季節型MK検定と季節型Sen's slope ---
smk.test(sales_ts)
summary(smk.test(sales_ts))   # 月ごとの結果
sea.sens.slope(sales_ts)

# --- Step 8:相関補正付き季節型MK検定 ---
csmk.test(sales_ts)
参考文献
- Mann HB. Nonparametric tests against trend. Econometrica. 1945;13(3):245–259. https://www.jstor.org/stable/1907187
- Kendall MG. Rank Correlation Methods. 4th ed. London: Charles Griffin; 1975.
- Sen PK. Estimates of the regression coefficient based on Kendall’s tau. Journal of the American Statistical Association. 1968;63(324):1379–1389. https://www.tandfonline.com/doi/abs/10.1080/01621459.1968.10480934
- Hirsch RM, Slack JR, Smith RA. Techniques of trend analysis for monthly water quality data. Water Resources Research. 1982;18(1):107–121. https://doi.org/10.1029/WR018i001p00107
- Hirsch RM, Slack JR. A nonparametric trend test for seasonal data with serial dependence. Water Resources Research. 1984;20(6):727–732. https://doi.org/10.1029/WR020i006p00727
- Hamed KH, Rao AR. A modified Mann-Kendall trend test for autocorrelated data. Journal of Hydrology. 1998;204(1–4):182–196. https://doi.org/10.1016/S0022-1694(97)00125-X
- Yue S, Pilon P, Phinney B, Cavadias G. The influence of autocorrelation on the ability to detect trend in hydrological series. Hydrological Processes. 2002;16(9):1807–1829. https://doi.org/10.1002/hyp.1095
- Chen X, Wang H, Lyu W, Xu R. The Mann-Kendall-Sneyers test to identify the change points of COVID-19 time series in the United States. BMC Medical Research Methodology. 2022;22:233. https://doi.org/10.1186/s12874-022-01714-6
おすすめ書籍
MK検定そのものを主題にした和書はほとんどない。そこで、本記事で扱った「自己相関」「季節性」「コレログラム」といった時系列データの基礎体力をつける本と、MK検定の”本家”が書いた無料の教科書を紹介する。
1. 馬場真哉『時系列分析と状態空間モデルの基礎:RとStanで学ぶ理論と実装』(プレアデス出版, 2018)
自己相関やコレログラム、季節性の扱いといった時系列分析の基本を、Rのコードとともに一から学べる。数式に苦手意識がある人の最初の1冊として最適である。
👉 https://www.amazon.co.jp/dp/4903814874
2. 沖本竜義『経済・ファイナンスデータの計量時系列分析』(統計ライブラリー, 朝倉書店, 2010)
自己相関・定常性・ARモデルなど、本記事の「罠①」の背景にある理論を、きちんと数式で理解したい人向けの定番書である。
👉 https://www.amazon.co.jp/dp/4254127928
3. Helsel DR, Hirsch RM, Ryberg KR, Archfield SA, Gilroy EJ. Statistical Methods in Water Resources(U.S. Geological Survey Techniques and Methods 4-A3, 2020)
Seasonal Kendall検定の考案者であるHirschらによる教科書で、米国地質調査所(USGS)のサイトから無料でPDFを入手できる。MK検定、Sen’s slope、Seasonal Kendall検定、自己相関への対処までがトレンド解析の章で詳しく解説されており、英語が苦にならなければ、本記事の内容を最も深く学べる1冊である。
👉 https://doi.org/10.3133/tm4A3

コメント