後輩:「先輩、この前教わったMann-Kendall検定を、ある地点の年平均気温100年分に使ってみたんです。P < 0.05で、しっかり『増えている』と出ました!」
先輩:「グラフは見たかい?」
後輩:「はい、右肩上がりです。温暖化の影響ですよね」
先輩:「そうかもしれない。でも、同じような右肩上がりのグラフは、毎年の揺れがただ積み重なっただけの系列からも簡単に出てくるんだ。コインを投げて表なら+1、裏なら−1を足し続けると、たまたま表の多い時期が続いて、しばらく上がり続けることがあるだろう?」
後輩:「……それだと、『増えている』の意味がまったく違いますね」
先輩:「そうなんだ。一定の坂を上っている(トレンド定常)のか、行き先の決まっていない散歩がたまたま上に向かった(単位根=ランダムウォーク)のかで、分析のやり方も結論も変わる。これを見分けるのが ADF検定 と KPSS検定 だ。ただし片方だけでは危ない。2本を組み合わせて使うのがコツなんだよ」
時系列データを扱う分析の多くは、系列が 定常(stationary) であることを前提にしている。ARIMAモデルもそうだし、2つの系列の関連を回帰で調べる場合も同じである。非定常な系列どうしを回帰すると、まったく無関係な系列でもR²が高く「有意な関連」が出てしまう。これが 見せかけの回帰(spurious regression) である(Granger & Newbold, 1974)。例えば、2つの物価指数を回帰したらR²が0.9だった、という結果は、この罠の典型例である。
この問題は経済・金融で最初に注目されたが、気温や河川流量などの環境データ、感染症の報告数や入院件数などの公衆衛生データでも、まったく同じことが起こる。
本記事では、次の3点をRで確認する。
- 「定常」「非定常」「単位根」とは何かを、比喩で直感的に理解する
- ADF検定とKPSS検定は 帰無仮説が逆 であり、2つを組み合わせた 4通りの判定表 で読む
- トレンドの型の指定ミスや構造変化(介入)といった、判定を誤らせる罠とその対処
時系列分析の基本(diff()・acf()・PP.test()・auto.arima())は以前の記事で解説している。前回は PP.test() で定常性をざっと確かめたが、今回はその部分を掘り下げる続編にあたる。
1. 定常と非定常:「リードにつながれた犬」と「リードの外れた犬」
定常な系列は、平均のまわりに戻ってくる
公園で、飼い主が1か所に立って犬を散歩させている場面を思い浮かべてほしい。
- リードにつながれた犬:あちこち動き回るが、飼い主(平均)から一定以上は離れられず、いずれ戻ってくる。何時に写真を撮っても、「飼い主のまわり、半径数メートル」という同じような位置に写る。これが 定常な系列 である。
- リードの外れた犬:一歩一歩はでたらめだが、戻ってくる力が働かないので、時間がたつほど飼い主から遠くへ行ってしまう可能性が高くなる。10分後と1時間後では、いそうな範囲の広さがまるで違う。これが 非定常な系列(ランダムウォーク)である。
※コラム:定常とは
時系列分析で「定常」と言うとき、多くは 弱定常(weak stationarity) を指す。次の3条件がそろった状態である。
① 平均が時点によらず一定である
② 分散が時点によらず一定である
③ 2時点間の共分散(自己共分散)が、時点そのものではなく 時点の差(ラグ)だけ で決まる
③は「1月と2月の関係」と「7月と8月の関係」が同じ強さである、という意味だ。季節変動のない安定した系列、例えば設備が一定の工場の日々の不良品率などが、定常に近い例である。
※コラム:非定常とは
上の3条件のどれかが崩れた系列を 非定常 と呼ぶ。典型的な崩れ方は2種類ある。
・確率トレンド(単位根):ランダムなショックが消えずに積み重なり、系列が漂流していく。株価や為替レートが代表例である。
・確定トレンド:一定の坂(直線など)の上で、揺らぎ自体は定常である。坂を取り除けば定常に戻る。例えば、気候変動による気温の上昇は、このタイプとしてモデル化されることがある。
どちらも見た目は「右肩上がり」になりうるので、グラフだけでは区別しにくい。
単位根:ショックの「記憶」が消えるかどうか
数式は最小限にして、1本だけ示す。今年の値 $y_t$ が、昨年の値 $y_{t-1}$ と今年のランダムなショック $\varepsilon_t$ で決まるモデル(1次の自己回帰、AR(1))である。
$$
y_t = \rho , y_{t-1} + \varepsilon_t
$$
- $|\rho| < 1$ のとき:ショックの影響は毎年 $\rho$ 倍ずつ小さくなり、やがて消える → 定常
- $\rho = 1$ のとき:ショックの影響が100%翌年に持ち越され、永遠に消えない → ランダムウォーク(単位根)
※コラム:単位根とは
池に石を投げる場面を想像してほしい。普通の池($\rho < 1$)なら、波紋は広がりながら弱まり、やがて水面は元の静けさに戻る。ところが単位根のある池($\rho = 1$)では、石を投げるたびに 水位そのものが上がったまま(あるいは下がったまま) になる。過去に投げたすべての石の影響が、足し算で今の水位に残り続けるのである。
「単位根」という名前は、このモデルの特性方程式 $1 – \rho z = 0$ の根 $z = 1/\rho$ が、$\rho = 1$ のときにちょうど 1(単位) になることに由来する。名前は数学的だが、意味は「ショックの記憶が消えない」と覚えておけばよい。
「差分を取る」か「トレンドを除く」か
2種類の非定常は、対処法が異なる。
| 系列のタイプ | 中身 | 定常にする方法 |
|---|---|---|
| 差分定常(単位根) | ショックが積み重なって漂流する | 差分($y_t – y_{t-1}$)を取る |
| トレンド定常 | 直線の坂+定常な揺らぎ | トレンドを除く(回帰の残差を使う、など) |
対処を取り違えると、分析がゆがむ。トレンド定常の系列に差分を取ると、余分な負の自己相関が生まれる(過剰差分)。ランダムウォークから直線を引き算しても、漂流は残ったままである。
冒頭の気温の話に戻ろう。系列がトレンド定常なら、「年あたり何度上がっているか」を語るのに Mann-Kendall検定とSen’s slope が役に立つ。一方、ランダムウォークでは強い自己相関のせいで、MK検定が「有意なトレンド」を出しやすくなる(MK記事の「罠①:自己相関」と同じ構図である)。だからこそ、トレンドを語る前に、系列のタイプを確かめる必要がある。
2. 正攻法:帰無仮説が逆の2つの検定を組み合わせる
ADF検定:帰無仮説は「単位根あり」
ADF検定(Augmented Dickey-Fuller test) は、Dickey & Fuller(1979)の検定を、Said & Dickey(1984)が自己相関の強い一般的な系列にも使えるよう拡張したものである。上のAR(1)の式を変形した次の回帰で、$\gamma = \rho – 1$ が0かどうかを調べる。
$$
\Delta y_t = \alpha + \beta t + \gamma , y_{t-1} + \sum_{i=1}^{k} \delta_i , \Delta y_{t-i} + \varepsilon_t
$$
- 帰無仮説 H0:$\gamma = 0$(単位根あり=非定常)
- 対立仮説 H1:$\gamma < 0$(定常)
- 最後の和の項($\Delta y$ のラグ $k$ 個)が “Augmented” の部分で、残差の自己相関を吸収する役割がある
回帰式に何を入れるかで、3つの型 がある。
型(urca::ur.df の type) | 回帰式の中身 | 想定する系列 |
|---|---|---|
"none" | 定数項なし・トレンドなし | 平均0のまわりを動く系列 |
"drift" | 定数項のみ | 0でない一定の平均のまわりを動く系列 |
"trend" | 定数項+トレンド項 | 右肩上がり・右肩下がりの系列 |
ラグ次数 $k$ の選び方 にも注意がいる。少なすぎると残差に自己相関が残り、第1種の過誤(本当は単位根があるのに「定常」と判定する誤り)が増える。多すぎると検出力が落ちる。AICやBICで選ぶのが一般的である。
KPSS検定:帰無仮説は「定常」
KPSS検定(Kwiatkowski, Phillips, Schmidt & Shin, 1992)は、発想が逆である。系列を次の3つの部品の和と考える。
$$
y_t = \xi t + r_t + \varepsilon_t, \qquad r_t = r_{t-1} + u_t
$$
- $\xi t$:確定トレンド
- $r_t$:ランダムウォーク(ばらつき $\sigma_u^2$)
- $\varepsilon_t$:定常な揺らぎ
ランダムウォーク部品のばらつきが0($\sigma_u^2 = 0$)なら、$r_t$ は動かない定数になり、系列は定常である。そこで、
- 帰無仮説 H0:$\sigma_u^2 = 0$(定常)
- 対立仮説 H1:$\sigma_u^2 > 0$(単位根あり)
を検定する。帰無仮説の型は2つある。
型(tseries::kpss.test の null / urca::ur.kpss の type) | 帰無仮説 |
|---|---|
"Level" / "mu" | 一定の水準のまわりで定常(水準定常) |
"Trend" / "tau" | 直線トレンドのまわりで定常(トレンド定常) |
KPSS検定では、長期分散を推定するときの 帯域幅(ラグ数) が結果に影響する。大きすぎると検出力が落ち、小さすぎると第1種の過誤が増える。
2つの検定を組み合わせた判定表
ここがこの記事の中心である。2つの検定を、2人の裁判官 に喩えてみよう。
- ADF裁判官は「被告(系列)は非定常である」という前提から出発し、定常である十分な証拠があるときだけ判決を覆す(=「非定常」を推定する裁判官)
- KPSS裁判官は「被告は定常である」という前提から出発し、非定常である十分な証拠があるときだけ判決を覆す(=「定常」を推定する裁判官)
どちらの裁判官も、証拠が足りなければ 前提どおりの判決を出すしかない。ADF裁判官が「非定常」と言ったのは、単に定常の証拠が足りなかっただけかもしれない。だから2人の意見を突き合わせる。
| ADF(H0:単位根) | KPSS(H0:定常) | 結論 |
|---|---|---|
| 棄却 | 棄却せず | 定常(2人の意見が一致) |
| 棄却せず | 棄却 | 非定常(単位根) → 差分を取る(2人の意見が一致) |
| 棄却 | 棄却 | 判断保留:構造変化、トレンドの型の指定ミス、長期記憶などを疑う |
| 棄却せず | 棄却せず | 判断保留:データ不足・検出力不足。どちらとも言えない |
※コラム:「棄却できない」は「帰無仮説が正しい」ではない
ADF検定でP = 0.3だったとき、「単位根がある(非定常だ)と証明された」と書くのは誤りである。言えるのは「定常だと言える十分な証拠がなかった」までだ。特に数十点程度の短い系列では、ADF検定は $\rho = 0.9$ のような「単位根に近いが定常」な系列を見分ける力が弱い。KPSSを併用するのは、この弱点を反対側から補うためである。
実際の研究でも、この組み合わせは使われている。
- 経済:KPSS原著の副題は “How sure are we that economic time series have a unit root?” である。その背景には、Nelson & Plosser(1982)が米国の長期マクロ経済系列の多くで単位根を棄却できなかった、という有名な報告がある。KPSSは、この「単位根を棄却できない」という結果を、帰無仮説を逆にした検定で問い直したのである。
- 公衆衛生:中国・泉州市のインフルエンザ予測研究(Pan et al., 2025)では、ADF検定がP = 0.047と有意水準ぎりぎりだった。そこでKPSS検定を追加したところ非定常と判定されたため、1回の差分を取ってからモデル化している。KPSSを確認のために使った実例である。ただし本来は、ADFのP値が0.05の前後かどうかで追加の検定を決めるのではなく、最初から両方を実行して判定表で読む のが望ましい。
3. Rで実装してみよう(Step by Step)
ここからは、性質のわかっている3つの疑似系列を作り、ADF検定とKPSS検定がそれぞれをどう判定するかを確かめる。
使うパッケージは次の3つである。
tseries:adf.test()・kpss.test()でP値まで手早く出せるurca:ur.df()・ur.kpss()で回帰式の型やラグを細かく指定できる(P値ではなく臨界値で判定する)forecast:ndiffs()で必要な差分の回数を自動で決める
以下の結果は、R 4.6.1、tseries 0.10-63、urca 1.3-4、forecast 9.0.2 で実際に実行して確認したものである。乱数を使うため、set.seed() の値やパッケージのバージョンが違うと数値は変わる。
Step 0:パッケージの準備
# install.packages(c("tseries", "urca", "forecast"))
library(tseries)
library(urca)
library(forecast)
Step 1:疑似データを作る
「ある地点の年平均気温(1926〜2025年、100年分)」を想定し、性質の異なる3系列を作る。
set.seed(2026)
n <- 100

# 系列A:定常なAR(1)(リードにつながれた犬)
e_A <- arima.sim(model = list(ar = 0.5), n = n)
series_A <- ts(10 + e_A, start = 1926)

# 系列B:ランダムウォーク(リードの外れた犬=単位根)
series_B <- ts(10 + cumsum(rnorm(n, mean = 0, sd = 1)), start = 1926)

# 系列C:トレンド定常(年0.05ずつ上昇する直線+AR(1)の揺らぎ)
e_C <- arima.sim(model = list(ar = 0.5), n = n)
series_C <- ts(10 + 0.05 * (1:n) + e_C, start = 1926)- 系列A:前年の影響を半分($\rho = 0.5$)引き継ぐが、平均10のまわりに戻ってくる
- 系列B:前年の値に毎年ランダムなショックを足し続ける($\rho = 1$)
- 系列C:100年で5度上がる直線の坂の上で、系列Aと同じ性質の揺らぎが乗っている
Step 2:まずはグラフとコレログラムで見る
par(mfrow = c(3, 2))
plot(series_A, main = "A: Stationary AR(1)", ylab = "")
acf(series_A, main = "ACF of A")
plot(series_B, main = "B: Random walk", ylab = "")
acf(series_B, main = "ACF of B")
plot(series_C, main = "C: Trend-stationary", ylab = "")
acf(series_C, main = "ACF of C")
par(mfrow = c(1, 1))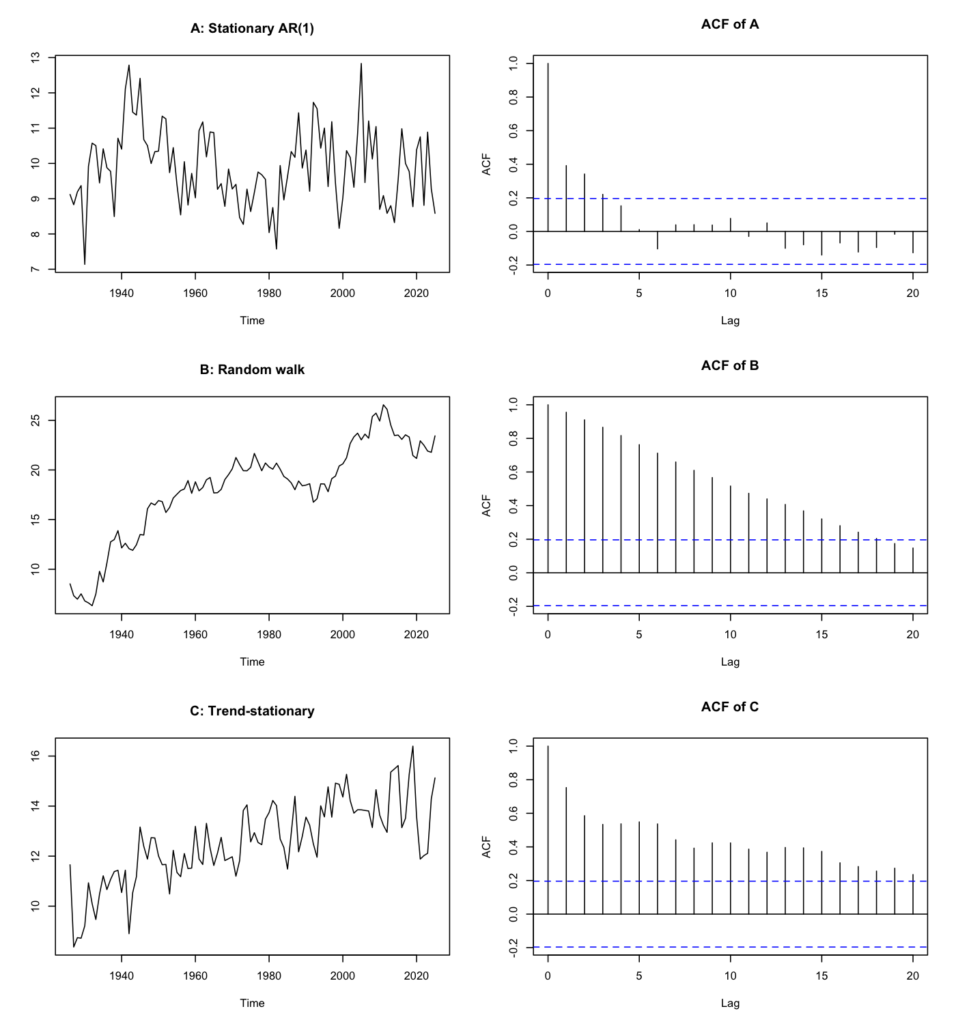
- 系列A:平均10のまわりを上下し、コレログラム(ACF)はラグ3〜4あたりで信頼区間(青い点線)の内側に収まる。「リードにつながれた犬」の典型的な姿である。
- 系列B:スタートは10度なのに、戻ってくる力が働かないため、前半(1930年代)には6度台まで下がり、終盤(2010年ごろ)には26度台まで上がっている。このように平均の位置に戻らず、どこへ向かうか決まっていない動きを「漂流」と呼ぶ。ACFもラグ20付近までゆっくりとしか減衰しない。どちらも単位根の典型的なサインである。
- 系列C:右肩上がりで、ACFもゆっくり減衰している。
ここで大事なのは、BとCはどちらも「右肩上がり」で、ACFもどちらもゆっくり減衰する という点である。目で見るだけでは、ランダムウォークとトレンド定常を区別しにくい。だから検定が必要になる。
Step 3:tseriesで手早く検定する
まず系列Aで、使い方と出力の読み方を確認する。
adf.test(series_A)                    # H0: 単位根あり(定数項+トレンド項入り)
kpss.test(series_A, null = "Level")   # H0: 水準定常
kpss.test(series_A, null = "Trend")   # H0: トレンド定常
Augmented Dickey-Fuller Test
Dickey-Fuller = -4.1429, Lag order = 4, p-value = 0.01
alternative hypothesis: stationary
KPSS Test for Level Stationarity
KPSS Level = 0.12548, Truncation lag parameter = 4, p-value = 0.1
KPSS Test for Trend Stationarity
KPSS Trend = 0.080634, Truncation lag parameter = 4, p-value = 0.1
警告メッセージ:
1: adf.test(series_A) で: p-value smaller than printed p-value
2: kpss.test(series_A, null = "Level") で: p-value greater than printed p-value
...ADF検定は単位根を棄却し、KPSS検定は定常を棄却しない。2人の裁判官の意見が一致し、系列Aは定常 と判定できる。
ここで、初学者がつまずきやすい点が2つある。
① P値が0.01や0.1で頭打ちになるtseries のP値は、数表から補間して求めている。統計量が表の範囲の外に出ると、P値は範囲の端の値で止まり、警告が出る。範囲は、ADFなら0.01〜0.99、KPSSなら0.01〜0.10である。”p-value smaller than printed p-value” は「本当のP値は0.01よりさらに小さい」という意味で、エラーではない。論文には「P < 0.01」「P > 0.10」と不等号で書けばよい。
② adf.test() は、常に「定数項+トレンド項」入りの回帰で検定するtseries::adf.test() には、回帰式の型を選ぶ引数がない。常に最も一般的な "trend" 型で検定する。トレンドのない系列にも使えるが、不要な項を入れた分だけ検出力はやや落ちる。型を選びたいときは、次の urca を使う。
Step 4:urcaで型を明示して検定する
右肩上がりの系列Cを、urca で詳しく見てみよう。
adf_C <- ur.df(series_C, type = "trend", lags = 4, selectlags = "AIC")
summary(adf_C)
Test regression trend
...
Value of test-statistic is: -6.487 14.2675 21.0841
Critical values for test statistics:
1pct 5pct 10pct
tau3 -4.04 -3.45 -3.15
phi2 6.50 4.88 4.16
phi3 8.73 6.49 5.47lags = 4, selectlags = "AIC"は、「最大4までのラグの中からAICで最適なものを選ぶ」という指定である- 見るべきは 最初の値(tau3) である。検定統計量 −6.487 は5%臨界値 −3.45 より小さい(よりマイナス側にある)ので、単位根を棄却 する
- phi2・phi3は、トレンド項や定数項が必要かどうかを調べるための検定で、回帰式の型を段階的に絞り込む手順(Dolado et al., 1990)で使われる。本記事では、単位根の判定に直接かかわるtau3だけを見る
同じ系列でも、adf.test() の統計量は −3.907 だった。これは adf.test() がラグを4に固定しているのに対し、ここではAICでラグ1が選ばれたためである。ラグの選び方で統計量は変わる ので、論文にはラグの決め方を必ず書く。
続いてKPSS検定を、2つの型で実行する。
kpss_C_mu  <- ur.kpss(series_C, type = "mu",  lags = "short")
kpss_C_tau <- ur.kpss(series_C, type = "tau", lags = "short")
summary(kpss_C_mu)
summary(kpss_C_tau)
Test is of type: mu with 4 lags.
Value of test-statistic is: 1.7435
critical values 0.347 0.463 0.574 0.739 (10pct 5pct 2.5pct 1pct)
Test is of type: tau with 4 lags.
Value of test-statistic is: 0.1247
critical values 0.119 0.146 0.176 0.216 (10pct 5pct 2.5pct 1pct)KPSS検定は、統計量が臨界値より 大きい ときに棄却する(ADFとは向きが逆である)。
type = "mu"(水準定常):1.7435 > 0.463 → 5%で 定常を棄却type = "tau"(トレンド定常):0.1247 < 0.146 → 5%で 定常を棄却しない
つまり系列Cは、「一定の水準のまわりで定常」とは言えないが、「直線トレンドのまわりで定常」とは言える。まさに トレンド定常 という、データを作ったときの設定どおりの結論である。
Step 5:3系列をまとめて判定表に当てはめる
2つの検定の結果を判定表に当てはめる関数を作り、3系列を一気に判定する。
judge <- function(adf_p, kpss_p, alpha = 0.05) {
  adf_rej  <- adf_p  < alpha
  kpss_rej <- kpss_p < alpha
  if ( adf_rej && !kpss_rej) return("定常")
  if (!adf_rej &&  kpss_rej) return("非定常(単位根)")
  if ( adf_rej &&  kpss_rej) return("判断保留:両方棄却")
  "判断保留:両方棄却せず"
}

check_stationarity <- function(x, kpss_null = "Level") {
  adf_p  <- suppressWarnings(adf.test(x)$p.value)
  kpss_p <- suppressWarnings(kpss.test(x, null = kpss_null)$p.value)
  data.frame(ADF_p = round(adf_p, 3), KPSS_p = round(kpss_p, 3),
             KPSS_null = kpss_null, 判定 = judge(adf_p, kpss_p))
}

series_list <- list(A = series_A, B = series_B, C = series_C)
res_level <- do.call(rbind, lapply(series_list, check_stationarity, kpss_null = "Level"))
res_trend <- do.call(rbind, lapply(series_list, check_stationarity, kpss_null = "Trend"))
res_level
res_trend
ADF_p KPSS_p KPSS_null 判定
A 0.010 0.10 Level 定常
B 0.313 0.01 Level 非定常(単位根)
C 0.017 0.01 Level 判断保留:両方棄却
ADF_p KPSS_p KPSS_null 判定
A 0.010 0.10 Trend 定常
B 0.313 0.01 Trend 非定常(単位根)
C 0.017 0.09 Trend 定常表の値の意味は次のとおりである。0.010や0.01は「0.01以下」、0.10は「0.10以上」を表す(Step 3の頭打ち)。
- 系列A:どちらの型でも「定常」。設定どおりである。
- 系列B:ADFは単位根を棄却できず(P = 0.313)、KPSSは定常を棄却した。2人の意見が「非定常」で一致する。設定どおりである。
- 系列C:KPSSを Level型 で実行すると「両方棄却」の判断保留になる。Trend型 で実行すると「定常(トレンドのまわりで定常)」になる。
系列Cの結果は、判定表の「両方棄却」が何を意味するかをよく示している。adf.test() はトレンド項入りで検定しているのに、KPSSを「水準定常」の型で検定したため、2人の裁判官が別々の罪状を審理していた のである。右肩上がりの系列では、ADFとKPSSの両方で トレンド項を入れた型にそろえる のが原則である。
Step 6:差分を取って再検定し、ndiffs() で次数を確かめる
非定常と判定された系列Bは、差分を取ってからもう一度検定する。
d_B <- diff(series_B)
check_stationarity(d_B, kpss_null = "Level")
ADF_p KPSS_p KPSS_null 判定
1 0.01 0.1 Level 定常1回の差分で定常になった。系列Bは「1回差分を取れば定常になる系列」、専門用語でいう I(1)(1次の和分過程) である。
forecast::ndiffs() を使うと、「定常になるまで検定と差分を繰り返す」作業を自動でやってくれる。3系列について、検定と型を変えて比べてみよう。
sapply(series_list, function(x) c(
  KPSS_level = ndiffs(x, test = "kpss", type = "level"),
  KPSS_trend = ndiffs(x, test = "kpss", type = "trend"),
  ADF_trend  = ndiffs(x, test = "adf",  type = "trend")
))
A B C
KPSS_level 0 1 1
KPSS_trend 0 1 0
ADF_trend 0 1 0ここにも落とし穴がある。ndiffs() の既定は KPSS検定・type = "level" である。トレンド定常の系列Cに既定のまま使うと、「差分が1回必要」と判定される(1行目)。トレンドを考慮した型にすると、「差分は不要」になる(2・3行目)。
以前の記事で使った auto.arima() も、既定ではKPSS検定で差分の次数を決めている。関数に任せきりにせず、グラフを見て、トレンドの有無に合った型を選ぶ ことが大切である。
※コラム:構造変化があると、判定を誤りやすい
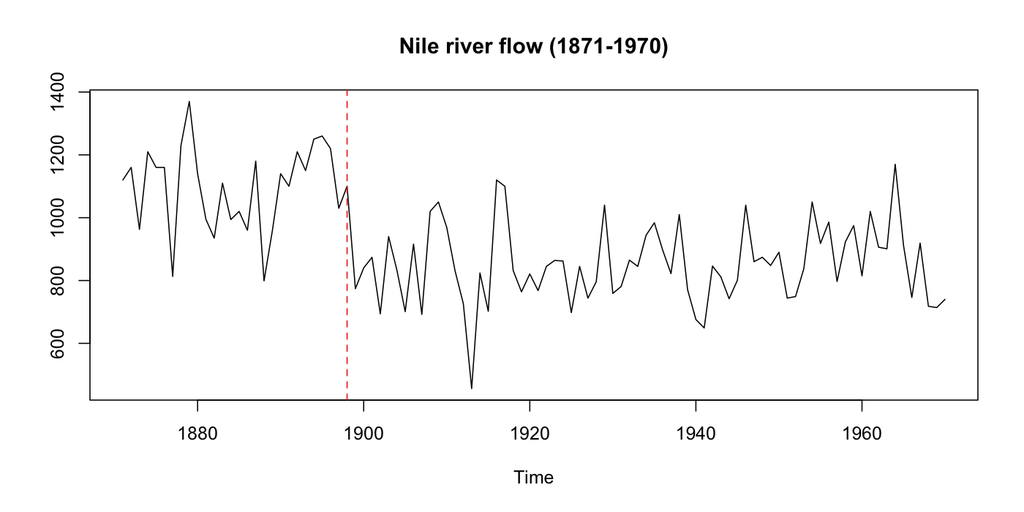
政策の導入、設備の更新、ダムの建設などで、系列の水準が ある時点で段差のように変わる ことがある。Comparative Interrupted Time Series(CITS)の記事で扱った「介入」がまさにそれである。こうした段差は、ADF検定から見ると「ショックが消えずに残った」ように見える。そのため、本当は 段差のある定常系列 でも「単位根あり」と誤判定されやすい(Perron, 1989)。
Rに組み込まれているNile(ナイル川の年間流量、1871〜1970年)で確かめてみよう。この系列は、1898年ごろに水準が下がったことで知られる(Cobb, 1978)。check_stationarity(Nile, kpss_null = "Level") # ADF_p KPSS_p KPSS_null 判定 # 1 0.064 0.01 Level 非定常(単位根)判定表をそのまま当てはめると「非定常」になる。ここで、変化点をデータから推定しながら単位根を検定する Zivot–Andrews検定(Zivot & Andrews, 1992)を使ってみる。
za <- ur.za(Nile, model = "intercept", lag = 2)   # ラグは簡便のため2に固定
summary(za)                 # Teststatistic: -6.1751(5%臨界値 -4.8)
time(Nile)[za@bpoint]       # 1898
check_stationarity(window(Nile, start = 1899), kpss_null = "Level")
#   ADF_p KPSS_p KPSS_null 判定
# 1  0.01    0.1     Level 定常
ラグ次数は、本来ADF検定と同様にAICなどで選ぶのが一般的である。ここでは簡便のため2とした。
Zivot–Andrews検定は1898年に変化点を見つけ、「水準の段差を1回許せば単位根は棄却される」と判定した。実際、1899年以降だけで検定し直すと「定常」になる。
介入の効果を調べる分割時系列(ITS)解析では、この点が特に重要である。介入をまたいだ系列全体に単位根検定を使うと、介入効果そのものを「単位根」と取り違えるおそれがある。介入前の期間だけで検定する、あるいは変化点を考慮した検定を使うのが安全である。
どう使い分けるか:判断の流れ
- グラフとACFを見る:トレンドの有無、段差(構造変化)の有無、季節性の有無を確認する
- 型を決める:トレンドがあればADFは
"trend"型、KPSSは"Trend"/"tau"型。なければ"drift"型と"Level"/"mu"型 - ADFとKPSSを両方実行 し、判定表で読む
- 「非定常」なら差分を取り、再び3へ。
ndiffs()の結果と照らし合わせる - 判断保留なら立ち止まる:型の指定、構造変化(Zivot–Andrews検定・介入前だけでの検定)、データの長さを見直す
- 月次・四半期データなら季節性も確かめる:
forecast::nsdiffs()で季節差分(月次なら12か月前との差)が必要かを確かめる。季節差分を取ると、最初の12点(月次の場合)が失われる。そのため、系列には十分な長さが必要になる(Schaffer et al., 2021)
※コラム:検定を重ねることの注意
ADFとKPSSをそれぞれ有意水準5%で実行し、差分を取ったあとにも検定を繰り返すと、手順全体として「誤った判定をする確率」は、名目の5%とは一致しなくなる。検定を重ねるほど、どこかで誤る機会が増えるからである。単位根検定の結果は「絶対の判決」ではなく、グラフ・ACF・分野の知識と合わせて、モデルを選ぶための 判断材料の一つ として扱うのが健全である。
4. 論文でそのまま使える英文テンプレート
以下の数値は、本記事の疑似データ(系列C)と Nile を実際に解析した結果である。自分のデータに使うときは、必ず自分の解析結果に置き換えてほしい。
Methods
Stationarity of each time series was assessed using two complementary tests with opposite null hypotheses: the augmented Dickey–Fuller (ADF) test, whose null hypothesis is the presence of a unit root, and the Kwiatkowski–Phillips–Schmidt–Shin (KPSS) test, whose null hypothesis is stationarity. For series with a visible trend, both tests included a constant and a linear trend; otherwise, only a constant was included. The lag order of the ADF regression was selected by the Akaike information criterion (maximum of 4 lags), and the KPSS test used the short bandwidth, trunc(4(n/100)^(1/4)). A series was considered stationary when the ADF test rejected and the KPSS test did not reject their respective null hypotheses at the 5% significance level, and non-stationary when the reverse was observed. Series judged to be non-stationary were first-differenced and re-tested. When the results were inconclusive or a structural break was suspected on visual inspection, the possibility of a structural break was examined using the Zivot–Andrews test. All analyses were performed in R version 4.6.1 using the tseries, urca, and forecast packages.
(和訳の要点:ADFとKPSSの2つを使ったこと、トレンドの有無で型を変えたこと、ラグの決め方、定常・非定常の判定ルール、非定常なら差分を取ること、食い違ったときはZivot–Andrews検定で構造変化を調べたこと)
Results
The ADF test rejected the null hypothesis of a unit root (τ = −6.49; 5% critical value, −3.45), whereas the KPSS test did not reject the null hypothesis of trend stationarity (KPSS statistic = 0.125; 5% critical value, 0.146). The series was therefore considered trend-stationary, and no differencing was applied.
構造変化を扱った場合の記述例:
For the annual flow series, the ADF test did not reject the unit root null hypothesis (P = 0.064), and the KPSS test rejected the null hypothesis of level stationarity (P < 0.01). However, the Zivot–Andrews test identified a structural break in the level in 1898 and rejected the unit root null hypothesis (test statistic = −6.18; 5% critical value, −4.80). When restricted to the post-break period (1899–1970), the series was stationary according to both tests (ADF, P < 0.01; KPSS, P > 0.10).
査読者に「なぜ2つの検定を使ったのか」と聞かれたときの一文
Because unit root tests such as the ADF test have limited power to distinguish a unit root from a highly persistent stationary process, particularly in short series, we used the KPSS test as a confirmatory test with the reverse null hypothesis.
まとめ
- 定常 は「リードにつながれた犬」、単位根 は「ショックの記憶が消えない(水位が上がったままの池)」系列である。非定常な系列をそのまま回帰すると、見せかけの関連が出る。
- ADF(H0:単位根) と KPSS(H0:定常) は帰無仮説が逆である。片方の「棄却できない」だけでは何も証明されないので、2つを組み合わせた判定表 で読む。
- トレンドの型をそろえる。右肩上がりの系列で型を取り違えると、「両方棄却」の判断保留や、不要な差分(
ndiffs()の既定)につながる。 - 構造変化(介入) は単位根と見分けにくい。判定が食い違ったら、Zivot–Andrews検定や、介入前の期間だけでの検定を試す。
- トレンド定常と確かめたうえで「どれくらい増えているか」を語るには、Mann-Kendall検定とSen’s slopeが使える。
一括コピペ用Rスクリプト
# ============================================================
# ADF検定とKPSS検定による時系列の定常性判定
# ============================================================

# --- パッケージ ---
# install.packages(c("tseries", "urca", "forecast"))
library(tseries)
library(urca)
library(forecast)

# --- Step 1:疑似データの作成(1926〜2025年の年次データ、100点)---
set.seed(2026)
n <- 100

# 系列A:定常なAR(1)(リードにつながれた犬)
e_A <- arima.sim(model = list(ar = 0.5), n = n)
series_A <- ts(10 + e_A, start = 1926)

# 系列B:ランダムウォーク(リードの外れた犬=単位根)
series_B <- ts(10 + cumsum(rnorm(n, mean = 0, sd = 1)), start = 1926)

# 系列C:トレンド定常(年0.05ずつ上昇する直線+AR(1)の揺らぎ)
e_C <- arima.sim(model = list(ar = 0.5), n = n)
series_C <- ts(10 + 0.05 * (1:n) + e_C, start = 1926)

# --- Step 2:グラフとコレログラム ---
par(mfrow = c(3, 2))
plot(series_A, main = "A: Stationary AR(1)", ylab = "")
acf(series_A, main = "ACF of A")
plot(series_B, main = "B: Random walk", ylab = "")
acf(series_B, main = "ACF of B")
plot(series_C, main = "C: Trend-stationary", ylab = "")
acf(series_C, main = "ACF of C")
par(mfrow = c(1, 1))

# --- Step 3:tseriesで手早く検定 ---
adf.test(series_A)                    # H0: 単位根あり(定数項+トレンド項入り)
kpss.test(series_A, null = "Level")   # H0: 水準定常
kpss.test(series_A, null = "Trend")   # H0: トレンド定常

# --- Step 4:urcaで型を明示して検定 ---
adf_C <- ur.df(series_C, type = "trend", lags = 4, selectlags = "AIC")
summary(adf_C)
kpss_C_mu  <- ur.kpss(series_C, type = "mu",  lags = "short")
kpss_C_tau <- ur.kpss(series_C, type = "tau", lags = "short")
summary(kpss_C_mu)
summary(kpss_C_tau)

# --- Step 5:ADF×KPSSの判定表を一括作成 ---
judge <- function(adf_p, kpss_p, alpha = 0.05) {
  adf_rej  <- adf_p  < alpha
  kpss_rej <- kpss_p < alpha
  if ( adf_rej && !kpss_rej) return("定常")
  if (!adf_rej &&  kpss_rej) return("非定常(単位根)")
  if ( adf_rej &&  kpss_rej) return("判断保留:両方棄却")
  "判断保留:両方棄却せず"
}

check_stationarity <- function(x, kpss_null = "Level") {
  adf_p  <- suppressWarnings(adf.test(x)$p.value)
  kpss_p <- suppressWarnings(kpss.test(x, null = kpss_null)$p.value)
  data.frame(ADF_p = round(adf_p, 3), KPSS_p = round(kpss_p, 3),
             KPSS_null = kpss_null, 判定 = judge(adf_p, kpss_p))
}

series_list <- list(A = series_A, B = series_B, C = series_C)
res_level <- do.call(rbind, lapply(series_list, check_stationarity, kpss_null = "Level"))
res_trend <- do.call(rbind, lapply(series_list, check_stationarity, kpss_null = "Trend"))
res_level
res_trend

# --- Step 6:差分を取って再検定し、ndiffs()で次数を確認 ---
d_B <- diff(series_B)
check_stationarity(d_B, kpss_null = "Level")

sapply(series_list, function(x) c(
  KPSS_level = ndiffs(x, test = "kpss", type = "level"),
  KPSS_trend = ndiffs(x, test = "kpss", type = "trend"),
  ADF_trend  = ndiffs(x, test = "adf",  type = "trend")
))

# --- コラム:構造変化(ナイル川の年間流量 Nile)---
plot(Nile, main = "Nile river flow (1871-1970)", ylab = "")
check_stationarity(Nile, kpss_null = "Level")
za <- ur.za(Nile, model = "intercept", lag = 2)   # ラグは簡便のため2に固定
summary(za)
time(Nile)[za@bpoint]                 # 推定された変化点の年
check_stationarity(window(Nile, start = 1899), kpss_null = "Level")
関連記事
- Rで時系列データ分析を行う方法
- 時系列データの「増えている」をRで判定する方法|Mann-Kendall検定とSen’s slope
- Comparative Interrupted Time Series とは何か どんな時に使うのが良いか わかりやすく解説
参考文献
- Dickey DA, Fuller WA. Distribution of the estimators for autoregressive time series with a unit root. Journal of the American Statistical Association. 1979;74(366a):427–431. https://doi.org/10.1080/01621459.1979.10482531
- Said SE, Dickey DA. Testing for unit roots in autoregressive-moving average models of unknown order. Biometrika. 1984;71(3):599–607. https://academic.oup.com/biomet/article-abstract/71/3/599/258758
- Kwiatkowski D, Phillips PCB, Schmidt P, Shin Y. Testing the null hypothesis of stationarity against the alternative of a unit root: How sure are we that economic time series have a unit root? Journal of Econometrics. 1992;54(1–3):159–178. https://ideas.repec.org/a/eee/econom/v54y1992i1-3p159-178.html
- Granger CWJ, Newbold P. Spurious regressions in econometrics. Journal of Econometrics. 1974;2(2):111–120. https://ideas.repec.org/a/eee/econom/v2y1974i2p111-120.html
- Perron P. The great crash, the oil price shock, and the unit root hypothesis. Econometrica. 1989;57(6):1361–1401. https://www.jstor.org/stable/1913712
- Zivot E, Andrews DWK. Further evidence on the great crash, the oil-price shock, and the unit-root hypothesis. Journal of Business & Economic Statistics. 1992;10(3):251–270. https://doi.org/10.1080/07350015.1992.10509904
- Cobb GW. The problem of the Nile: Conditional solution to a changepoint problem. Biometrika. 1978;65(2):243–251. https://doi.org/10.1093/biomet/65.2.243
- Pan H, Liu J, Li F, et al. Improving influenza prediction in Quanzhou, China: an ARIMAX model integrated with meteorological drivers. Frontiers in Public Health. 2025;13:1662775. https://doi.org/10.3389/fpubh.2025.1662775
- Hyndman RJ, Athanasopoulos G. Forecasting: Principles and Practice, 3rd ed. 9.1 Stationarity and differencing. https://otexts.com/fpp3/stationarity.html
- Nelson CR, Plosser CI. Trends and random walks in macroeconomic time series: Some evidence and implications. Journal of Monetary Economics. 1982;10(2):139–162. https://ideas.repec.org/a/eee/moneco/v10y1982i2p139-162.html
- Dolado JJ, Jenkinson T, Sosvilla-Rivero S. Cointegration and unit roots. Journal of Economic Surveys. 1990;4(3):249–273. https://doi.org/10.1111/j.1467-6419.1990.tb00088.x
- Schaffer AL, Dobbins TA, Pearson SA. Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: a guide for evaluating large-scale health interventions. BMC Medical Research Methodology. 2021;21:58. https://pubmed.ncbi.nlm.nih.gov/33752604/
おすすめ書籍
単位根検定をもう一歩深く学びたい人向けに、理論の定番書、Rで実装する入門書、本記事で使った urca の作者による解説書、無料で読める実践的な教科書を紹介する。
1. 沖本竜義『経済・ファイナンスデータの計量時系列分析』(統計ライブラリー, 朝倉書店)
単位根過程と単位根検定を正面から扱う定番書である。本記事で比喩を使って説明した「定常」「単位根」「見せかけの回帰」を、数式できちんと理解したい人に向いている。
👉 https://www.amazon.co.jp/dp/4254127928
2. 馬場真哉『時系列分析と状態空間モデルの基礎:RとStanで学ぶ理論と実装』(プレアデス出版)
自己相関、差分、ARIMAといった時系列分析の基本を、Rのコードとともに一から学べる。数式に苦手意識がある人の最初の1冊として最適である。
👉 https://www.amazon.co.jp/dp/4903814874
3. Pfaff B. Analysis of Integrated and Cointegrated Time Series with R, 2nd ed.(Springer, Use R! シリーズ, 2008)
本記事で使った urca パッケージの作者自身による解説書である。ur.df()・ur.kpss()・ur.za() の理論と使い方を詳しく学べる。
👉 https://www.amazon.com/dp/0387759662
4. Hyndman RJ, Athanasopoulos G. Forecasting: Principles and Practice, 3rd ed.(無料のWeb版)
差分、KPSS検定、季節差分、ARIMAを、実データで実践的に学べる教科書である。Web上で無料で全文を読める。
👉 https://otexts.com/fpp3/

コメント