研究やビジネスの現場で、複数の要因(説明変数)から結果(目的変数)を予測・分析するために「重回帰分析」や「ロジスティック回帰分析」といった多変量解析が頻繁に用いられます。
これらの解析を行う際、初心者が最も陥りやすい落とし穴の一つが「多重共線性(マルチコ:Multicollinearity)」という問題です。
多重共線性とは、説明変数同士の相関(関係性)が強すぎるために、分析モデルが不安定になり、正しい結果が得られなくなってしまう現象を指します。
せっかく苦労してデータを集めてSPSSで解析を回しても、この多重共線性が存在していると、結果の信頼性が大きく損なわれてしまいます。
この多重共線性をチェックし、安全に解析を進めるための重要な指標となるのが「VIF(分散拡大要因)」です。
本記事では、統計解析ソフト「IBM SPSS Statistics」を用いて、VIFを正しく算出するための具体的な手順を解説します。
また、解析の事前準備として必須となる「ダミー変数の作り方」から、実際の算出ステップまでを画面操作に沿って分かりやすく説明します。データ解析に行き詰まっている方は、ぜひ本記事を参考にして正しいモデル構築を行ってください。
VIF(分散拡大要因)とは?
SPSSの操作手順に入る前に、まずは一般的な知識として「VIF」とは何か、どのような基準で判断すべきかを解説します。
VIF(Variance Inflation Factor:分散拡大要因)とは、重回帰分析などの多変量解析において、「ある説明変数が、他の説明変数からどの程度説明されてしまうか(相関しているか)」を数値化した指標です。
簡単に言うと、「似たような意味を持つ変数が、モデル内に説明変数として重複して投入されていないか」を測るためのセンサーのような役割を果たします。
たとえば、健康診断のデータから「血圧」を予測するモデルを作る際、説明変数として「体重(kg)」と「BMI」の両方を入れてしまうとどうなるでしょうか。体重とBMIは明らかに強い相関関係があるため、両方を同時にモデルに組み込むと、コンピュータがどちらの変数が本当に影響を与えているのか判断できず、係数の計算がおかしくなってしまいます。これを防ぐためにVIFを確認します。
【VIFの判断目安】 VIFの最小値は「1」であり、変数の独立性が高い(他の変数との相関がない)ほど1に近い数値になります。一般的な統計学のテキストや論文では、以下の基準で判断されることが多くなっています。
- VIFが 1 ~ 2 程度: まったく問題なし。説明変数は独立している。
- VIFが 5 以上: 多重共線性の疑いがあり、注意が必要。
- VIFが 10 以上: 深刻な多重共線性が発生している。
もしVIFが10を超えるような変数が存在した場合、そのまま解析を進めるのは危険です。
「相関の強い変数の一方を分析から除外する」、あるいは「主成分分析などで2つの変数を1つに合成する」といった対処が必要になります。
SPSSでVIFを求める前にダミー変数を作る
ここからは、実際のSPSSの操作方法について解説します。 データの中に「男性・女性」や「はい・いいえ」のようなカテゴリカルデータ(文字データや分類データ)が含まれている場合、そのままでは回帰分析に投入してVIFを計算することができません。
そのため、SPSSでVIFを求める前にダミー変数を作る必要があります。
ダミー変数とは?
ダミー変数とは、カテゴリカルデータを「0」と「1」の数値に変換して、数式モデルで扱えるようにした変数のことです。
SPSSでのダミー変数の作り方
SPSSを用いてダミー変数を作成する手順は以下の通りです。
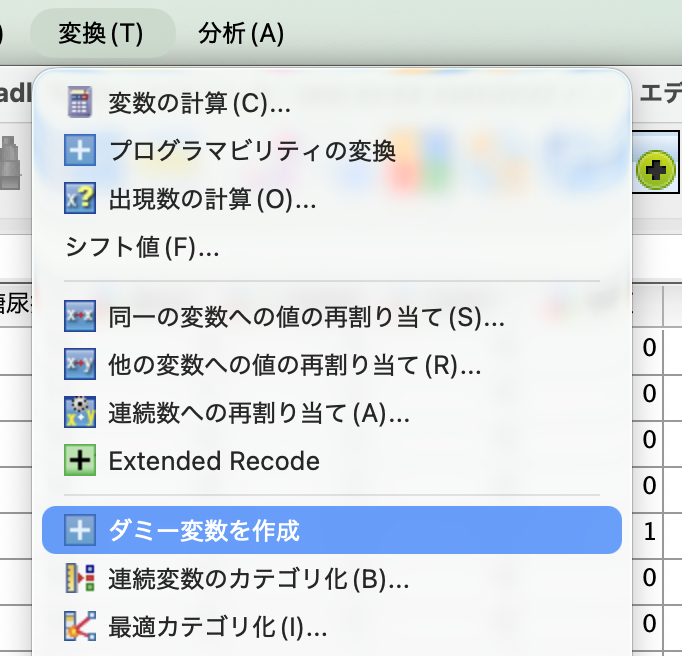
SPSSの上部メニューバーから「変数」を選択し、「ダミー変数を作成」をクリックします。
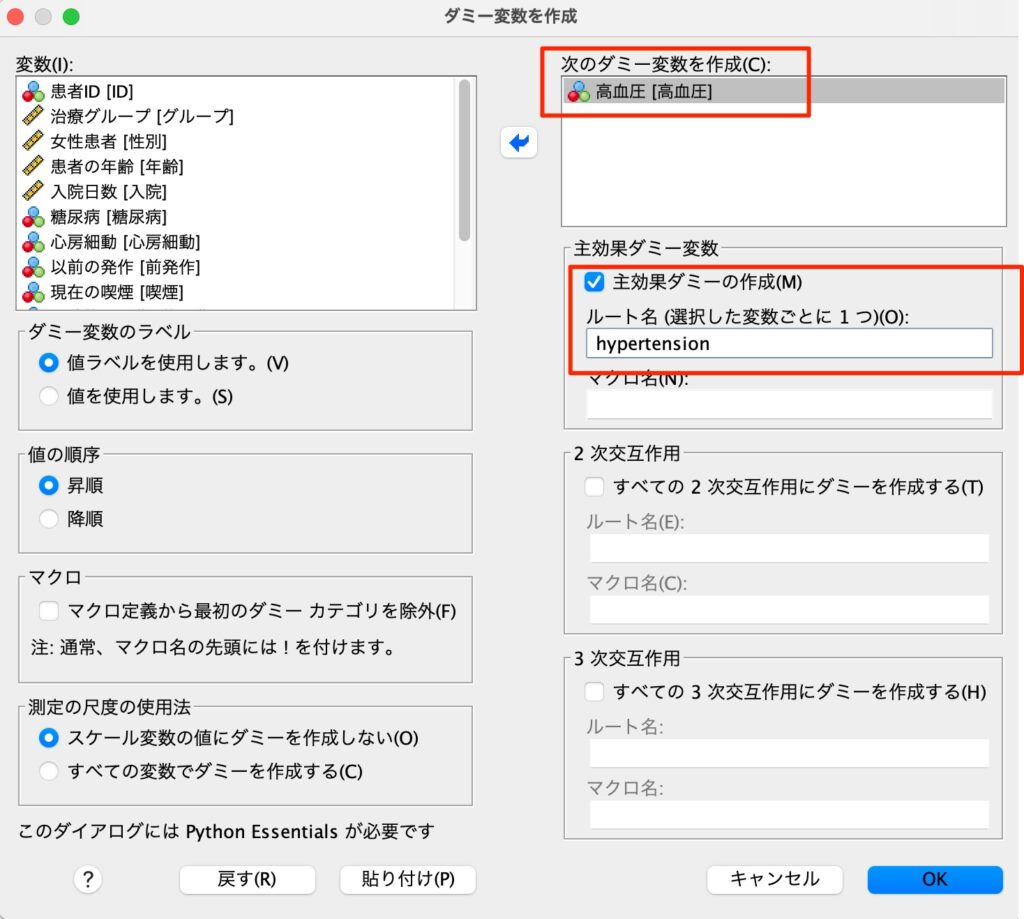
ダイアログボックスが表示されたら、「次のダミー変数を作成」という設定欄に対象となる元の変数を入れます。ここでは例として「高血圧」という変数を入れます。
次に、「主効果ダミー変数のルート名」の欄に「hypertension」と入力します。なお、ここに入力するルート名は任意の名前でOKです。
設定を完了して実行すると、新しいダミー変数が自動的に生成されます。
今回の「高血圧」という変数の場合、以下の2つの変数が作成されます。
- hypertension_1:「いいえ」の場合が「1」になり、それ以外は「0」として処理されます。
- hypertension_2:「はい」の場合が「1」になり、それ以外は「0」として処理されます。
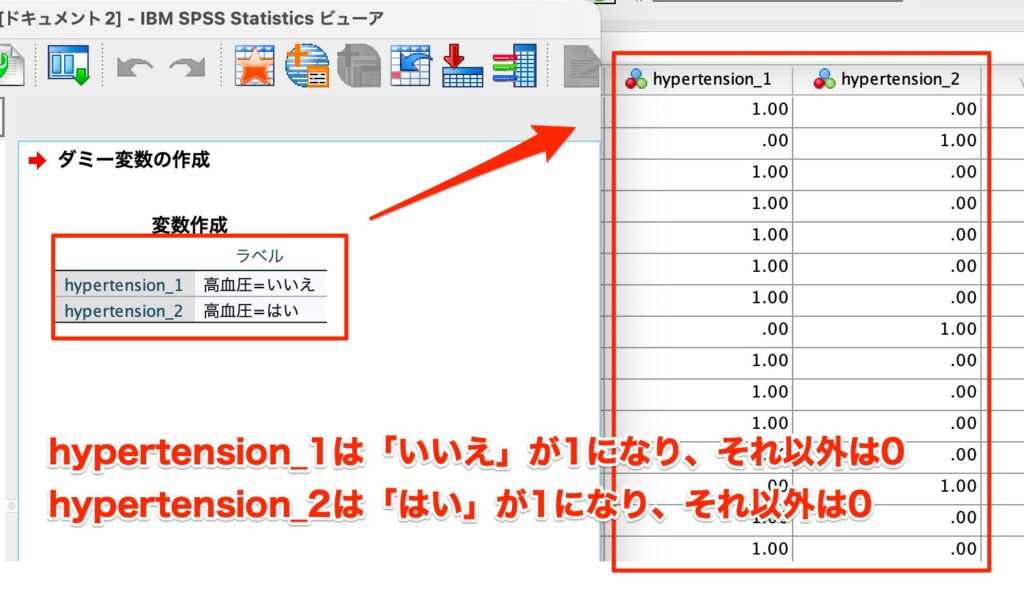
このように「0と1」のデータに変換することで、この後のVIFの計算プロセスへ進むことができるようになります。
VIFは解析手法に依存しないので線形回帰で求める
ダミー変数の準備が整ったら、いよいよVIFを算出します。 ここで非常に重要なポイントがあります。
それは、VIFは解析手法に依存しないという点です。
最終的に実施したい分析がロジスティック回帰分析や生存時間分析などであっても、多重共線性の確認としてのVIFは、一般的な「線形回帰」の機能を用いて求めることができます。
SPSSで線形回帰を用いたVIFの算出ステップ
SPSSでの具体的な操作は以下のステップで行います。
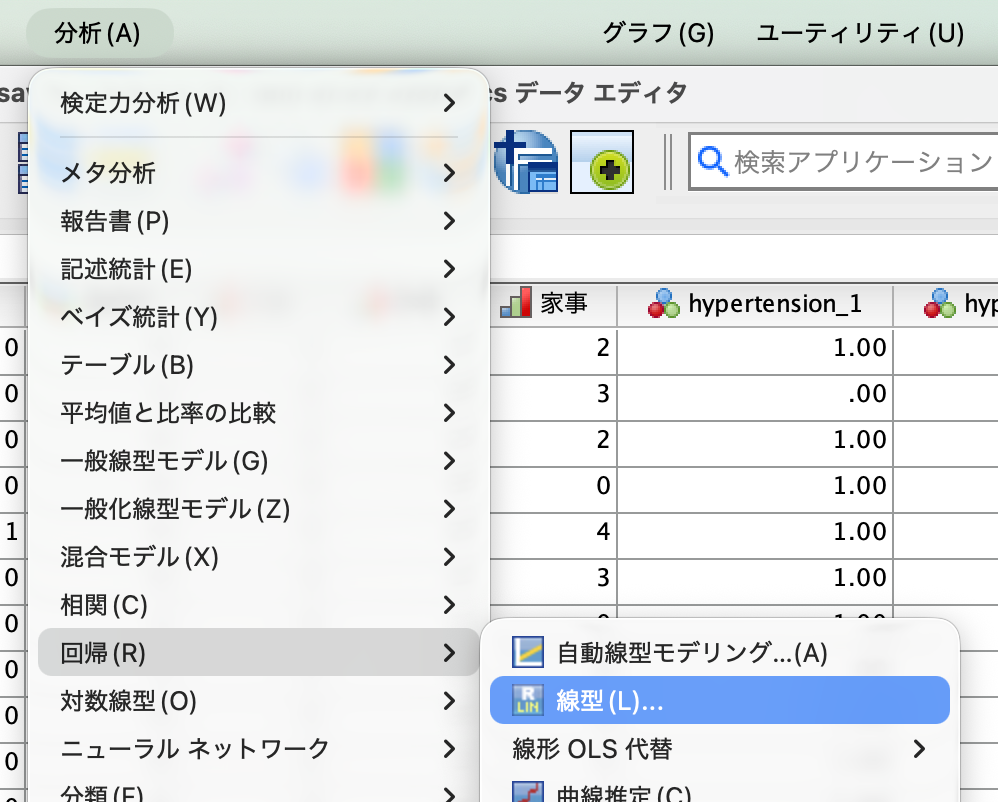
メニューの選択: 上部メニューから「分析」>「回帰」>「線型」の順にクリックして、線型回帰のダイアログを開きます。
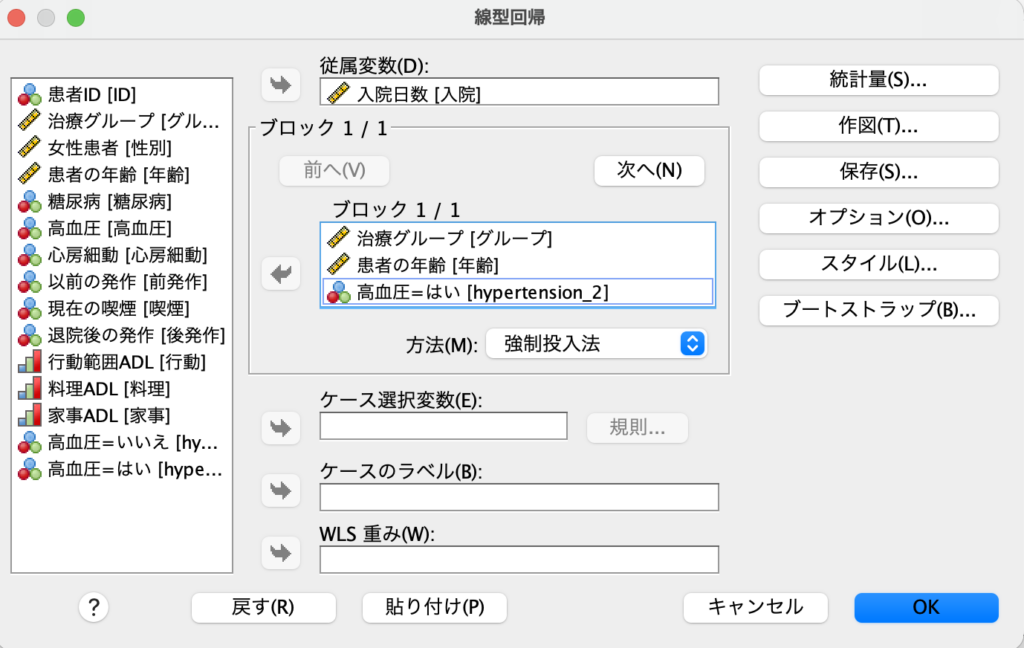
変数の投入:
- 従属変数: 例として「入院日数」を投入します。ただし、VIFを求めることだけが目的の場合、この従属変数には何を入れても構いません。
- 説明変数(独立変数): 多重共線性を確認したい変数をすべて投入します。ここでは例として、「治療グループ」「患者の年齢」、そして先ほど作成したダミー変数である「hypertension_2」を入れます。
統計量の設定: ダイアログ右側の「統計量」ボタンをクリックし、開いた画面で「共線性の診断」にチェックを入れて「続行」を押します。
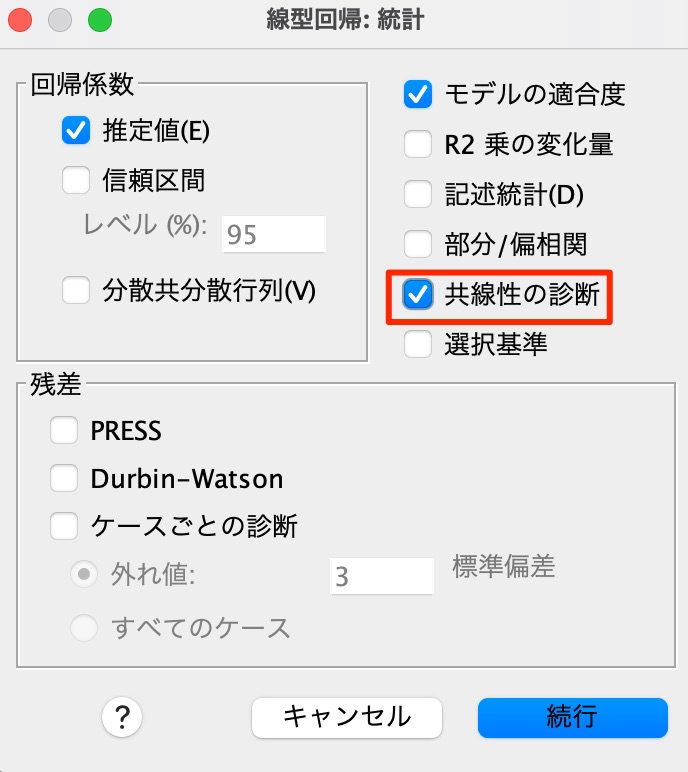
結果の確認: 「OK」をクリックして分析を実行すると、出力ビューアに複数の表が表示されます。このうち、結果の「係数」と書かれた表の部分を確認すると、一番右側にVIFが出力されていることがわかります。
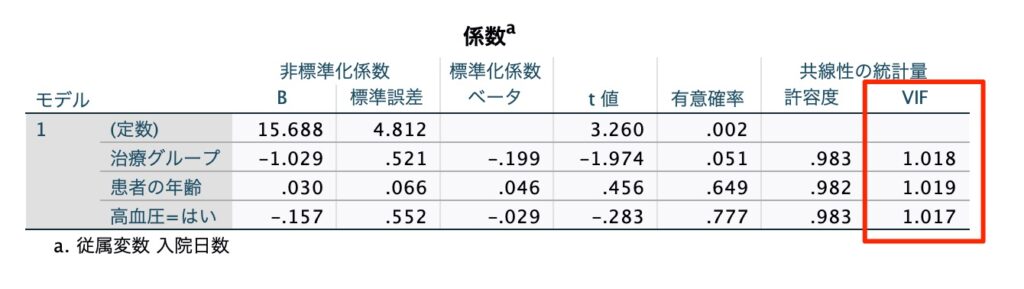
出力されたVIFの値を確認し、すべての変数が目安である「10未満(厳格な場合は5未満)」に収まっていれば、多重共線性の問題はないと判断して、本番の解析(ロジスティック回帰など)に進んで問題ありません。
統計解析やサンプルサイズ計算でお悩みの方へ
ここまで、SPSSを使ったVIFの求め方やダミー変数の作成方法について解説してきました。手順通りに進めれば算出自体は可能ですが、実際の研究や実務の現場では、データが思い通りにならなかったり、判断に迷ったりする場面が多々あります。
- 「VIFが10を超えてしまったが、どの変数を削れば研究の意図が保てるのか?」
- 「自分の研究デザインにおいて、そもそもこのダミー変数の扱い方で正しいのだろうか?」
- 「解析前のサンプルサイズ計算がこれで合っているのか不安だ」
このような「ツール操作以前の設計・統計学的な判断」で行き詰まってしまうと、作業の手が止まり、研究プロジェクト全体の進行が大幅に遅れてしまいます。
特に研究や論文執筆は時間との戦いでもあります。一人で悩んで時間を浪費したり、間違ったまま解析を進めて後からやり直しになったりするリスクを考えると、迷ったときは早期に専門家に相談し、すぐに解決した方が圧倒的に効率的です。
弊社では、こうしたSPSSの操作から統計解析の妥当性、研究デザインの設計までをサポートする「Zoomコンサルティング」を随時受け付けています。 画面を共有しながら、あなたの実際のデータや研究状況に合わせた具体的なアドバイスを直接提供いたします。一人で抱え込まず、ぜひプロの知見をご活用ください。
▶︎ Zoomコンサルティングの詳細・お申し込みは下記のページをご覧ください。
まとめ
本記事では、SPSSを用いたVIFの計算方法について解説しました。
- 多重共線性(変数の被り)を防ぐために、VIF(分散拡大要因)の確認が必須です。VIFが10以上の場合はモデルの見直しが必要です。
- カテゴリカルデータが含まれる場合は、VIF計算の前に「変数」メニューからダミー変数(0と1のデータ)を作成します。
- VIFは解析手法に依存しないため、最終的な手法に関わらず「分析」>「回帰」>「線型」から、「共線性の診断」にチェックを入れて算出します。
多重共線性のチェックは、信頼性の高い研究結果を導き出すための重要な関門です。正しい手順でデータを前処理し、精度の高いモデル構築を目指しましょう。もし途中で迷いや不安が生じた場合は、ぜひZoomコンサルティングなどのサポートもご検討ください。

コメント