医療・公衆衛生、マーケティング、品質管理など、さまざまな研究やビジネスの現場において、「件数」や「回数」を扱うデータに直面することがあります。
たとえば、「ある期間内の病気の発症件数」「ウェブサイトの1日あたりのクリック数」「工場で発生した製品の不良品数」「交通事故の発生件数」などがこれに該当します。
このような「0、1、2、3…」と数えられるデータ(カウントデータ)を目的変数として予測・分析する際、通常の線形回帰分析(重回帰分析など)を用いるのは不適切です。
なぜなら、線形回帰はデータが正規分布(左右対称の釣り鐘型の分布)に従うことを前提としており、マイナスの予測値を計算してしまう可能性があるからです。しかし、回数や件数がマイナスになることは現実にはあり得ません。
カウントデータの分析において標準的に用いられるのが「ポアソン回帰」であり、その発展形として用いられるのが「負の二項回帰」です。
本記事では、統計解析ソフト「IBM SPSS Statistics」を用いて、ポアソン回帰および負の二項回帰を実施する具体的な手順を解説します。
また、カウントデータ分析でつまずきやすい「過分散」の問題や、観測期間の違いを調整する「オフセット項」という重要な概念についても分かりやすく説明します。
解析手法の選択に迷っている方は、ぜひ本記事を参考にして正しいモデル構築を行ってください。
ポアソン回帰・負の二項回帰とは?
ポアソン回帰とは?
まずは、ベースとなる「ポアソン回帰」について解説します。
ポアソン回帰とは、目的変数が「カウントデータ(離散的な非負の整数)」である場合に用いられる一般化線形モデル(GLM)の一つです。このモデルは、データが「ポアソン分布」という確率分布に従うことを前提としています。
ポアソン分布は、「滅多に起こらないが、起こる確率が一定である事象が、特定の期間や範囲で何回発生するか」を表す分布です。
ポアソン分布の最も大きな特徴(そして後述する弱点)は、「平均値と分散(データのばらつき)が等しい」という厳しい仮定を持っていることです。
つまり、「ある事象が平均して月に5回起こるなら、そのばらつき(分散)も5になる」という前提で計算を行うのがポアソン回帰モデルです。
負の二項回帰とは?
一方、「負の二項回帰」とは、上記のポアソン回帰の欠点を補うために用いられる解析手法です。
実際の現実世界のデータでは、ポアソン分布が仮定する「平均=分散」という綺麗な状態になることは稀です。
多くの場合、一部の対象者に極端に回数が集中するなどして、「データのばらつき(分散)が、平均値よりもはるかに大きくなってしまう」という現象が起きます。これを統計用語で「過分散(Overdispersion)」と呼びます。
過分散が起きているデータに対して無理やりポアソン回帰を適用すると、結果の信頼区間が不当に狭く見積もられ、「本当は意味がない(有意ではない)要因なのに、有意であると判定されてしまう(偽陽性が増える)」という致命的なエラーを引き起こします。
負の二項回帰は、この「過分散」の度合いをモデル内に組み込んで調整できるようにした手法です。
ポアソン回帰の結果を確認して過分散が疑われる場合には、より柔軟な負の二項回帰に切り替えて再解析を行うのが、カウントデータ分析の正しい定石となります。
分析に欠かせない「オフセット項(オフセット変数)」とは?
SPSSでの操作手順に入る前に、もう一つ重要な概念である「オフセット項(オフセット変数)」について解説しておきます。
カウントデータ(回数・件数)を比較する際、対象となる「規模」や「観測期間」が違うデータをそのまま比較するのは不公平です。
たとえば、「Aの工場では不良品が10個出た」「Bの工場では不良品が50個出た」というデータがあったとします。
これだけ見るとB工場の方が悪く見えますが、もしA工場の稼働期間が「1ヶ月」で、B工場の稼働期間が「1年(12ヶ月)」だった場合はどうでしょうか。
期間を考慮すれば、明らかにA工場の方が不良品の発生率が高いことになります。
このように、件数を発生させる「母数(期間、人口、面積、稼働時間など)」がデータごとに異なる場合、モデルを公平に比較するために母数の違いを調整する必要があります。
この調整役となる変数を「オフセット項(オフセット変数)」と呼びます。
一般的には、母数となる変数(今回の例なら稼働月数)を「対数変換(Log)」したものをオフセット変数としてモデルに組み込みます。
これにより、「単なる件数」ではなく「単位期間(または単位規模)あたりの発生率」として正しく解析することができるようになります。
SPSSでポアソン回帰を実施する方法
それでは、実際のSPSSの画面操作手順を見ていきましょう。 今回はSPSSに内蔵されているサンプルデータ(船舶の損傷事故データなどを想定)を用いて解説します。
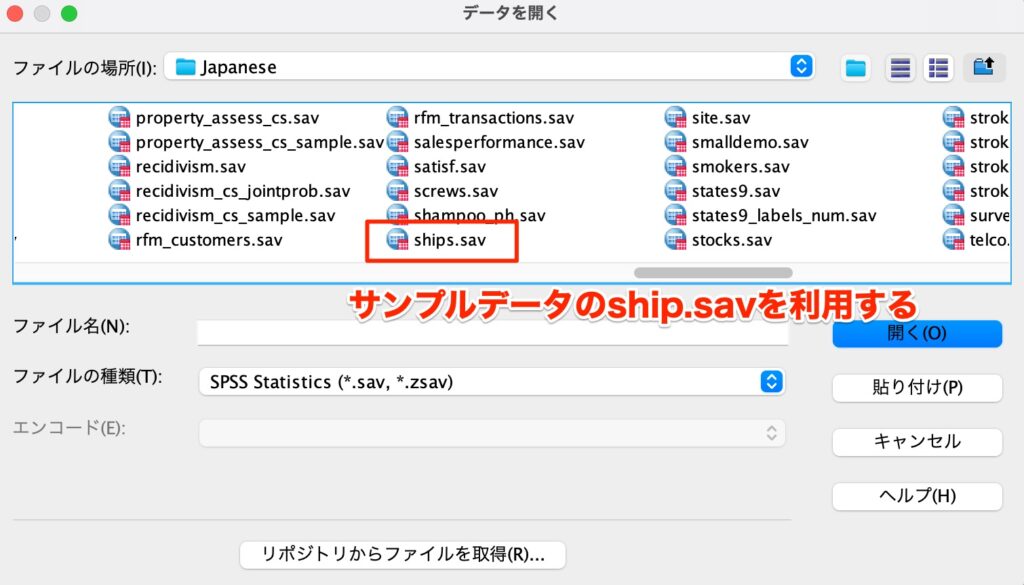
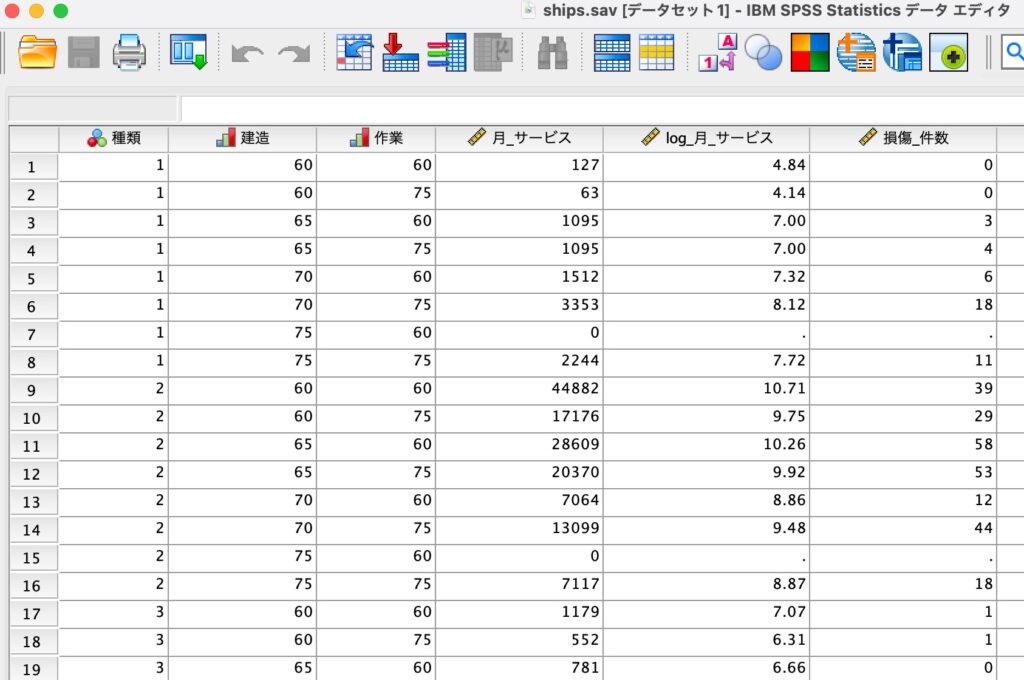
ship.savは以下のようなデータです。
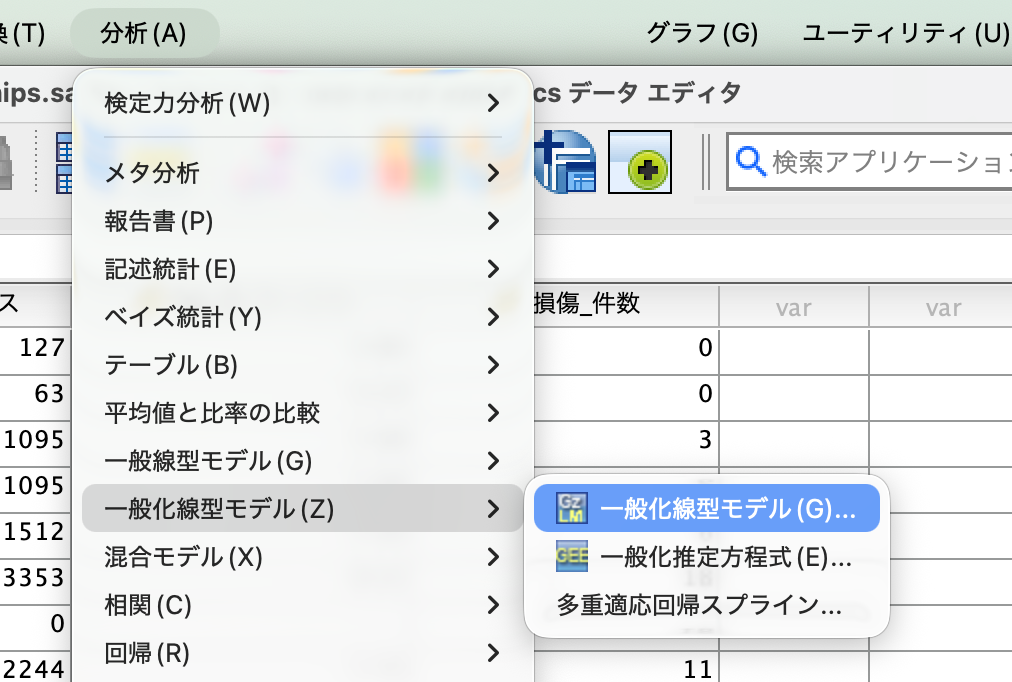
分析メニューの選択
- SPSSの上部メニューから 「分析」>「一般化線型モデル」>「一般化線型モデル」 の順に選択します。
モデルの種類の設定
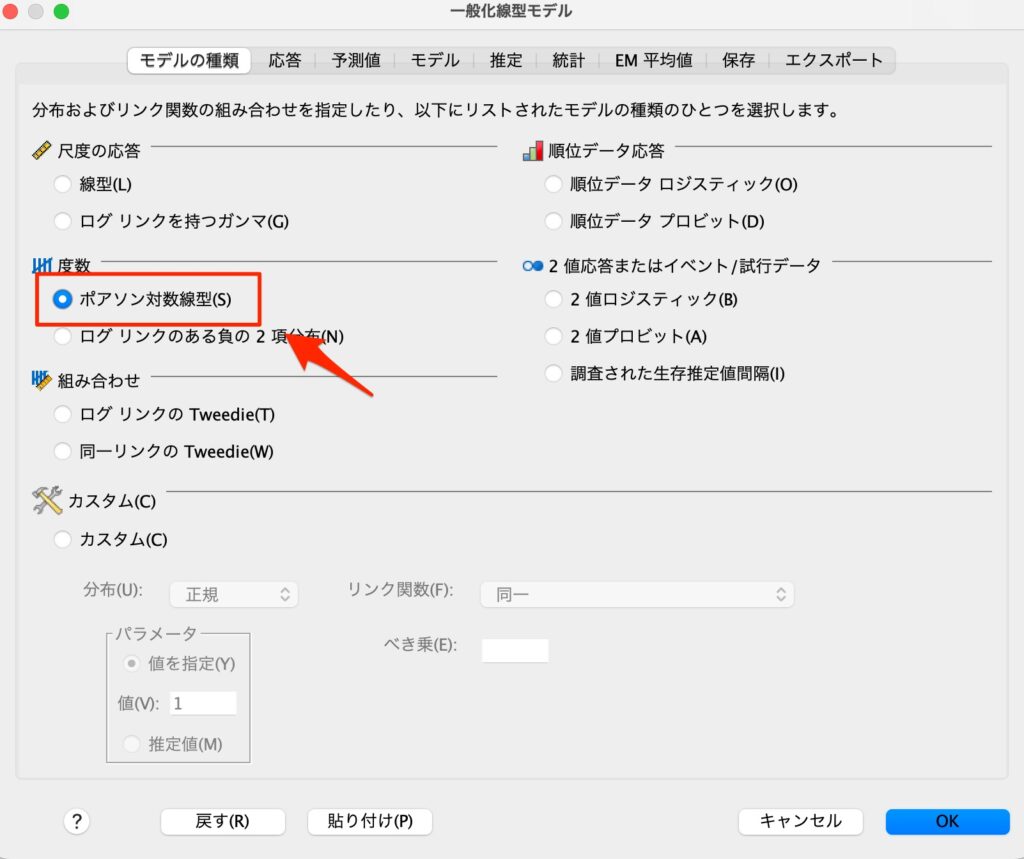
- 「一般化線型モデル」のダイアログが開いたら、最初の「モデルの種類」タブで、「ポアソン対数型」 を選択します。
応答(目的変数)の設定
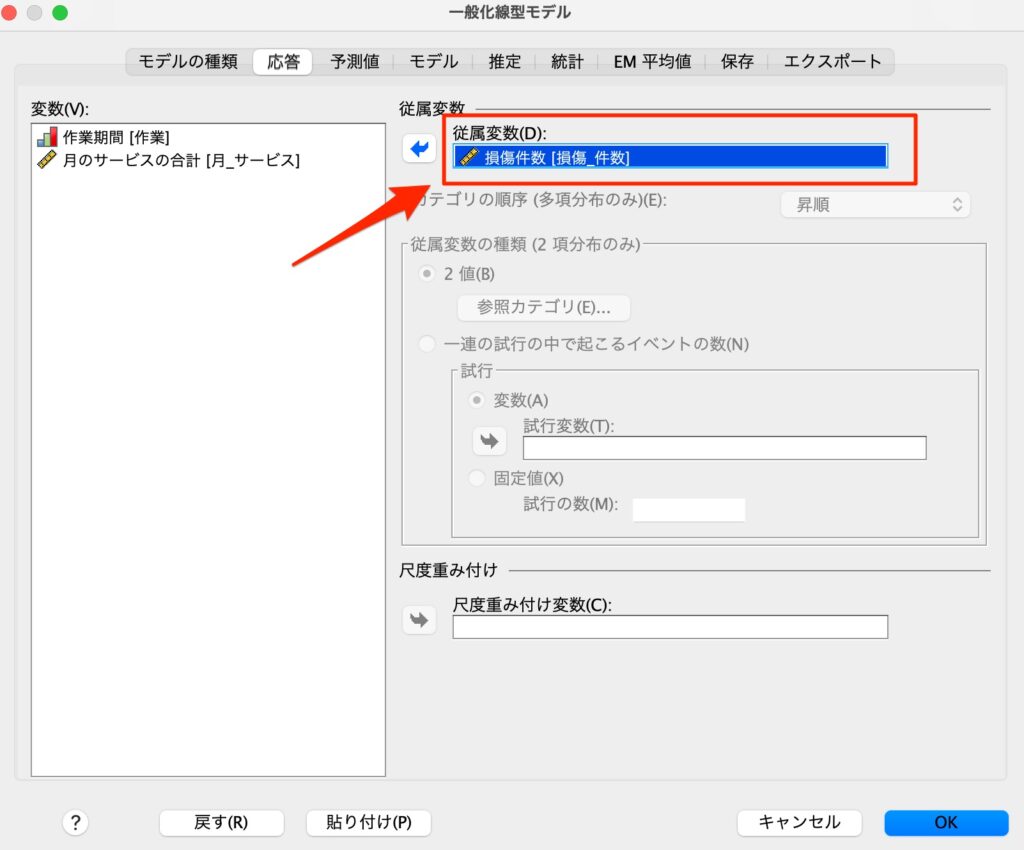
- 上部の「応答」タブをクリックします。ここには予測したい結果の変数を入れます。
- 従属変数(応答)の枠に 「損傷件数」 を投入します。
予測値(説明変数)とオフセット変数の設定
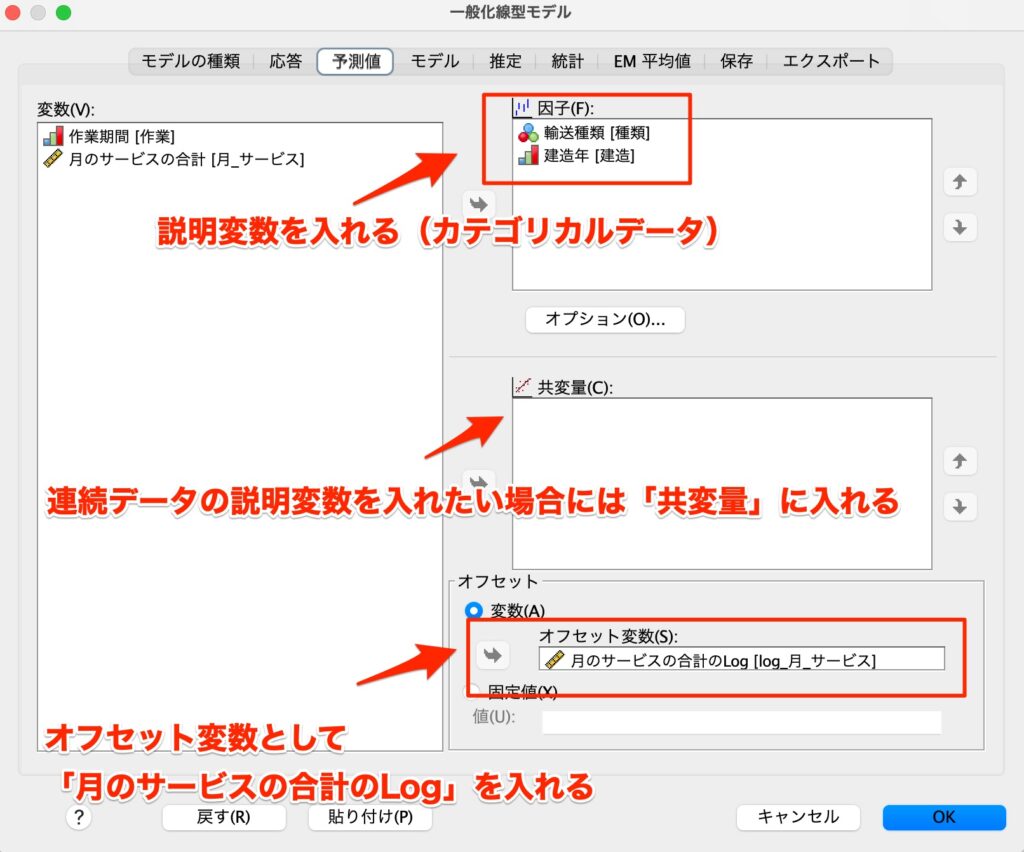
- 上部の「予測値」タブをクリックします。
- ここで、予測の要因となるカテゴリ変数を「因子」の枠に入れます。今回は 「輸送種類(種類)」 と 「製造年(建造)」 を入れます。
- 同じ画面の右側にある「オフセット変数」の枠に、観測期間を調整するための変数である 「月のサービスの合計のLog」 を入れます。これが先述したオフセット項です。
モデルの構築
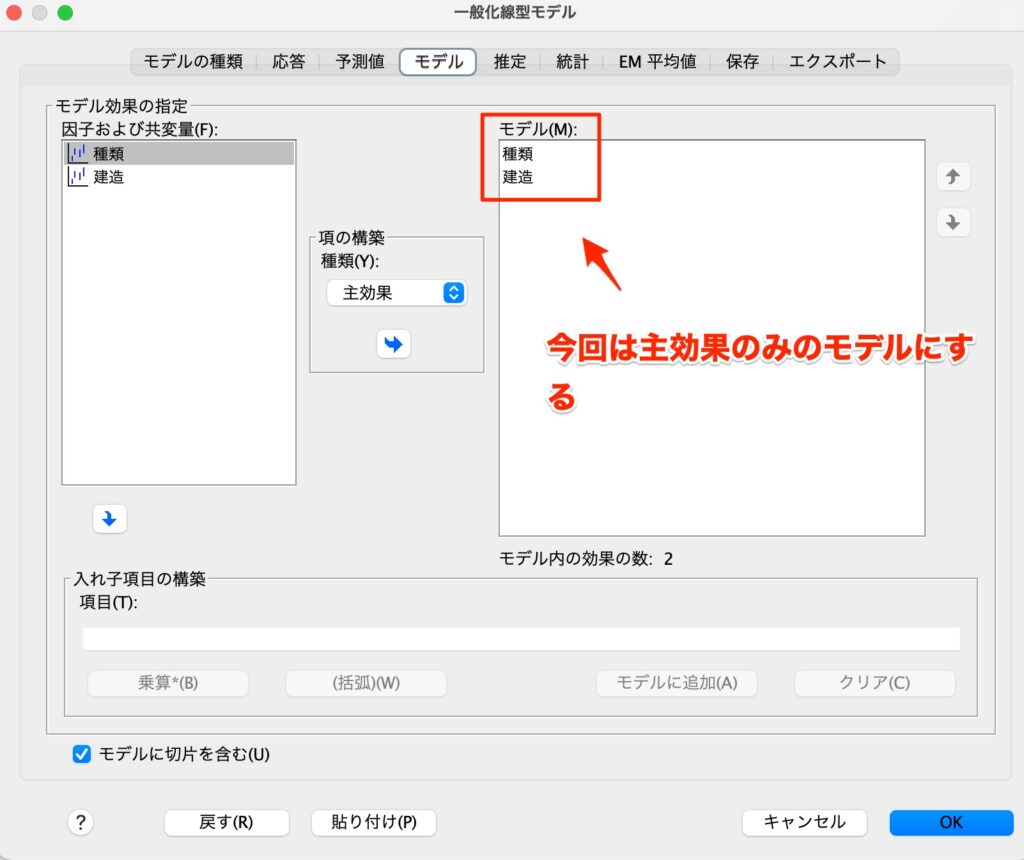
- 上部の「モデル」タブをクリックします。
- 左側のリストから、先ほど設定した 「種類」 と 「建造」 の2つを選択し、右側の「モデル」の枠に主効果として投入します。
統計オプションの設定
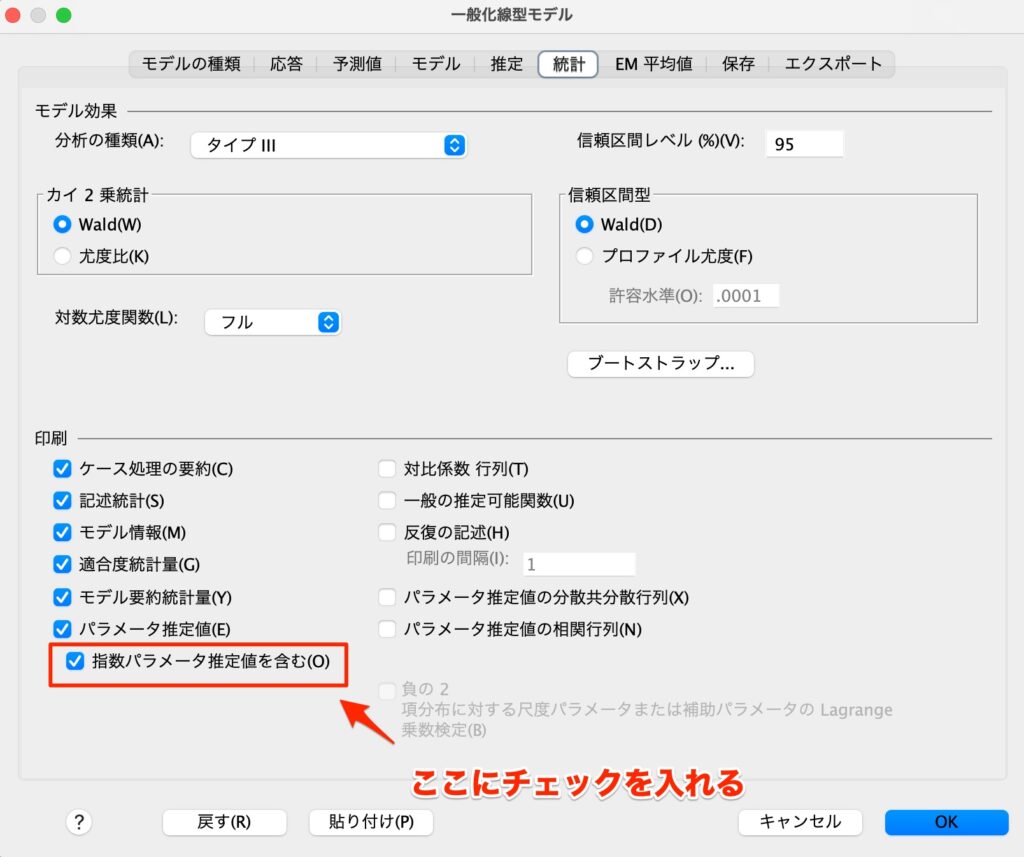
- 上部の「統計」タブをクリックします。
- 出力結果にオッズ比のような解釈がしやすい指標を表示させるため、「指数パラメータ推定値を含む」 にチェックを入れます。
- 最後に「OK」をクリックして、ポアソン回帰を実行します。
ポアソン回帰の結果解釈と「過分散」の確認
分析を実行すると、出力ビューアに結果が表示されます。ここですぐにp値(有意確率)を見るのではなく、モデルが適切だったか(過分散が起きていないか)を確認しなければなりません。
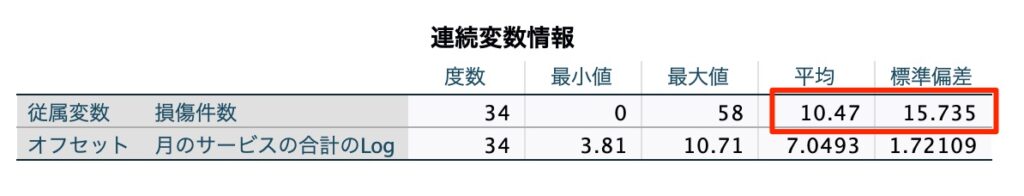
① 連続変数情報の確認 まずデータの基本統計量(連続変数情報)を確認すると、損傷件数の「平均」に対して「分散」がかなり大きいことが分かります。これが「過分散」の第一のサインです。
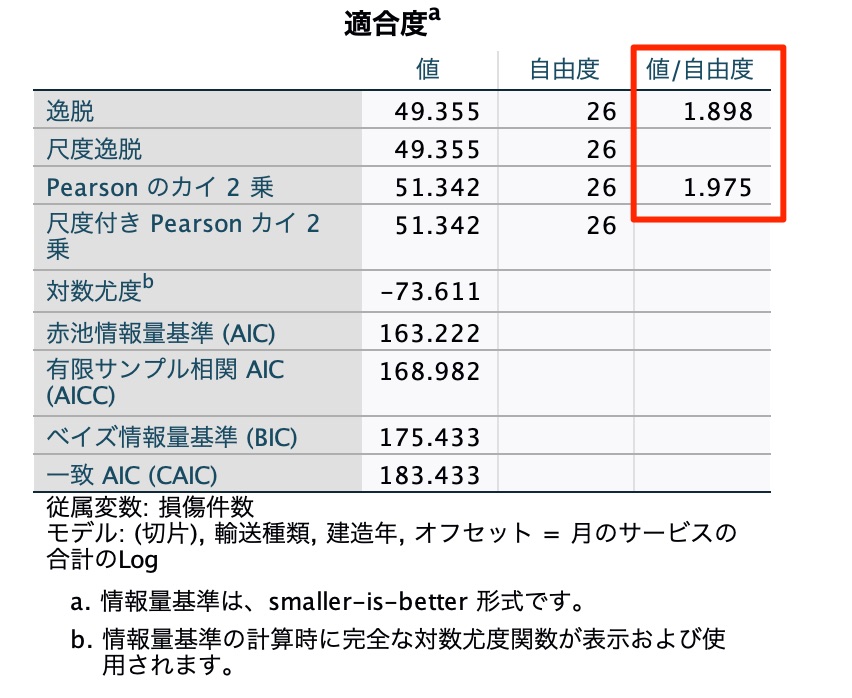
② 適合度の確認 次に「適合度」の表を確認します。ポアソン分布が理想的に適合している場合、ここの「値/自由度」という指標は「1」に近づくはずです。しかし結果を見ると、「値/自由度」が1よりもかなり大きい数値になっています。これも過分散を示唆しています。
③ パラメータ推定値の確認 「パラメータ推定値」の表にある「Exp(B)」という列が、損傷率の増減を表す結果(発生率比:IRR)となります。 一見すると多くの変数で有意差(p < 0.05)が出ているように見えます。しかし、先述の通りこのデータは「過分散」を起こしており、モデルの適合度も悪い状態です。 このような状態でポアソン回帰の結果を信じると、信頼区間が過小評価(狭く見積もられる)され、不当に有意な結果が多くなってしまっている(本当は差がないのに差があると判定されている)可能性が非常に高いと言えます。
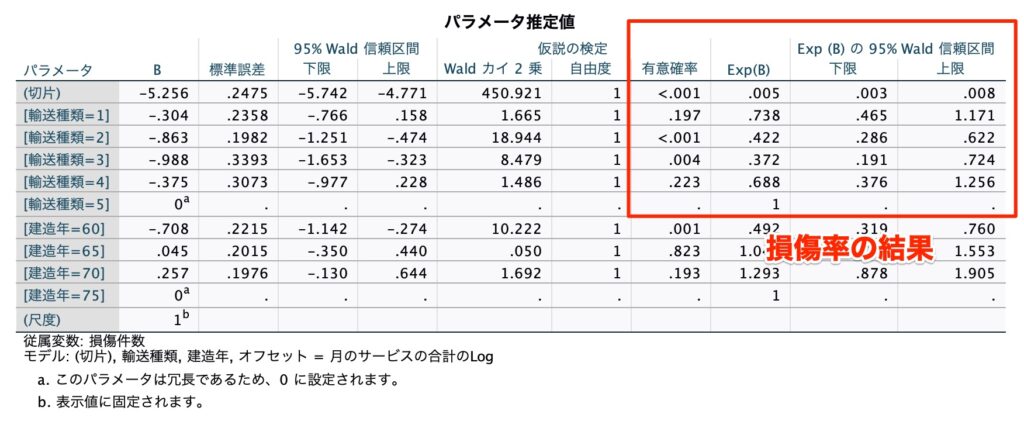
したがって、このデータに対してはポアソン回帰ではなく、「負の二項回帰」を用いる方が適切であると判断できます。
SPSSで負の二項回帰を実施する方法
ポアソン回帰で過分散が確認されたため、より適切な「負の二項回帰」を実施して結果を比較してみましょう。
操作手順は先ほどのポアソン回帰とほぼ同じで、モデルの入り口を変えるだけです。
- 再び 「分析」>「一般化線型モデル」>「一般化線型モデル」 を開きます。
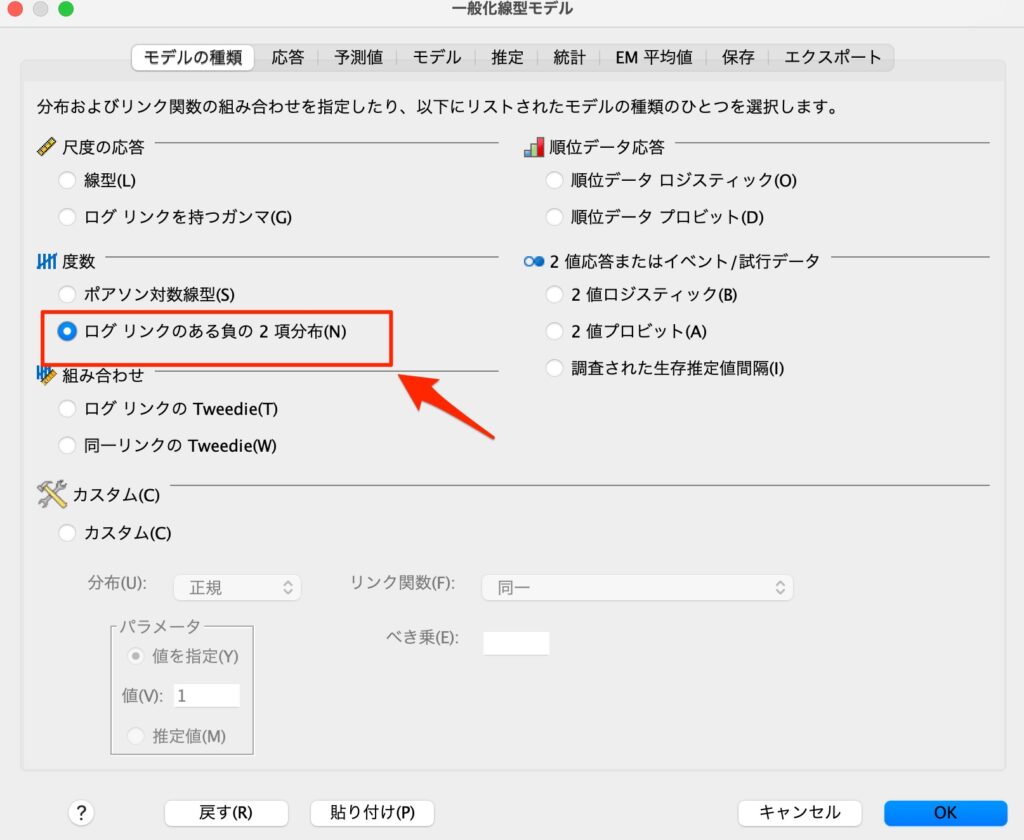
- 「モデルの種類」タブで、今度は 「ログリンクのある負の2項分布」 を選択します。
- 応答、予測値(因子・オフセット)、モデル、統計の設定は、すべて先ほどのポアソン回帰と全く同じで構いません。
- そのまま「OK」を押して実行します。
負の二項回帰の結果の解釈
出力された負の二項回帰の結果を確認します。
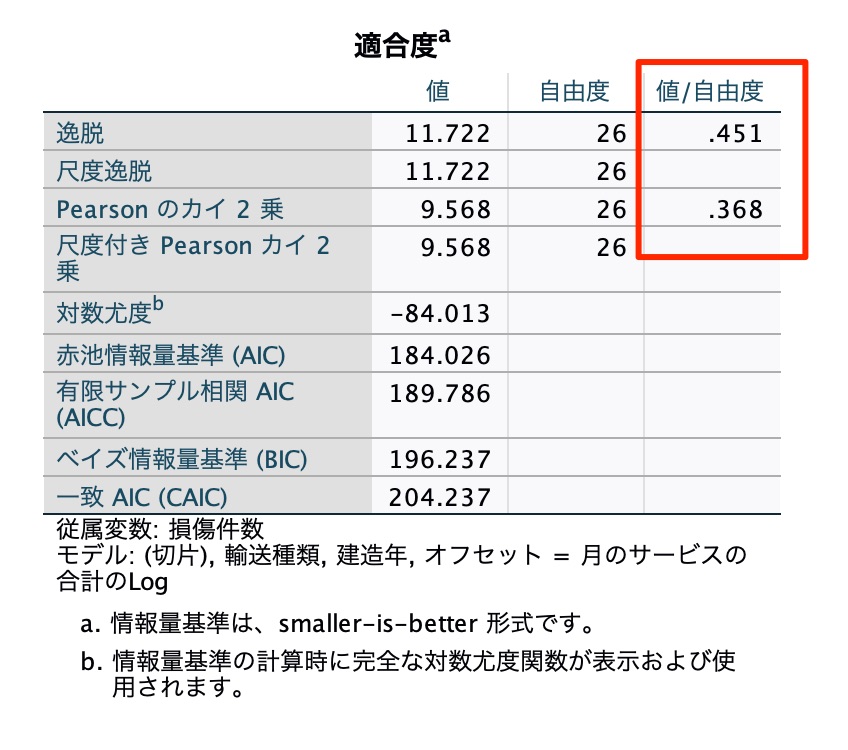
- 適合度の改善: 適合度の表を確認すると、「値/自由度」の数値がポアソン回帰の時よりも大幅に改善し、より「1」に近づいていることが確認できます。モデルの当てはまりが良くなった証拠です。
- パラメータ推定値の変化: 「Exp(B)」の部分を確認します。ポアソン回帰では多くの要因が有意になっていましたが、過分散を適切に補正した負の二項回帰では、全ての結果が有意ではなくなった(有意な要因が減った)ことがわかります。
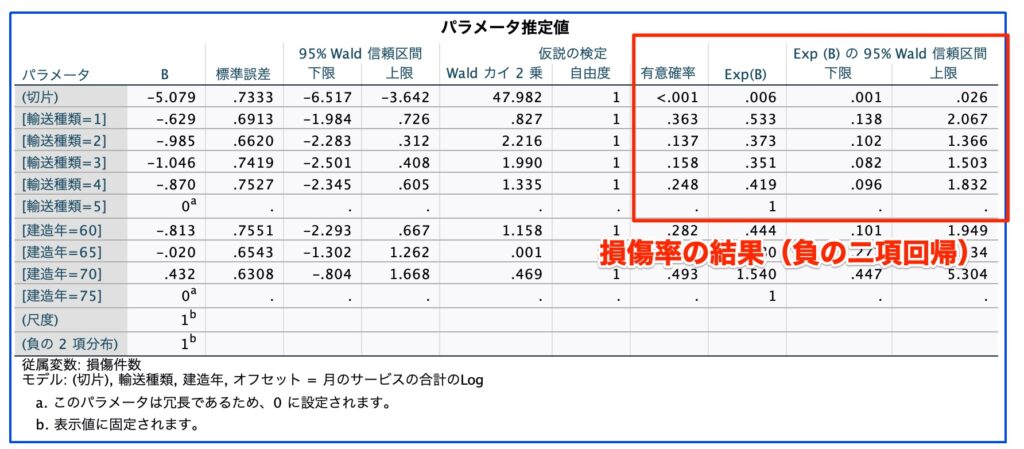
直感的には「有意差が消えてしまった」と残念に思うかもしれませんが、統計学的にはこちらの負の二項回帰の結果の方が、過分散を考慮した適切で誠実な解析結果であると結論づけられます。
統計解析やモデル選択でお悩みの方へ
ここまで、SPSSを使ったポアソン回帰と負の二項回帰の実施手順について解説してきました。
今回の例のように、「とりあえず解析を実行して有意差が出たから論文に書く」というのは非常に危険です。データの分布や過分散の有無を確認し、オフセット項を適切に設定し、モデルの適合度を評価するというプロセスを踏まなければ、誤った結論を世に出してしまうことになります。
しかし、実際の研究現場では「自分の持っているデータに対して、どの分布(モデル)を選択するのが正解か分からない」「オフセット項として何の変数を入れるべきか迷っている」「出力された表のどこを読んで解釈すればいいか自信がない」といった悩みに直面することが多々あります。
統計解析で行き詰まり、間違ったモデルのまま進めてしまうと、査読で厳しい指摘を受けたり、研究のやり直しを余儀なくされたりするリスクがあります。少しでも「これで合っているのだろうか?」と迷ったときは、すぐに専門家に相談し、疑問を解消した状態で研究を進めることが成功の近道です。
弊社では、SPSSを用いたデータ解析や研究デザインに関する疑問を直接解決できる「Zoomコンサルティング」を承っております。 画面を共有しながら、あなたのデータに最適な解析手法の提案や、SPSSの操作、結果の解釈まで丁寧にサポートいたします。一人で悩まずに、ぜひお気軽にご相談ください。
▶︎ Zoomコンサルティングの詳細・お申し込みは下記のページをご覧ください。
まとめ
本記事では、件数や回数などのカウントデータを分析する「ポアソン回帰」と「負の二項回帰」について解説しました。
- カウントデータの分析には、一般化線型モデル(GLM)であるポアソン回帰を用いる。
- 観測期間や規模が異なるデータを比較する場合は、「オフセット変数(対数変換したもの)」をモデルに組み込むことが必須である。
- データに「過分散(分散が平均より大きすぎる状態)」がある場合、ポアソン回帰では不当に有意差が出やすくなるため、過分散を調整できる「負の二項回帰」を使用する方が適切である。
ツールを操作すること自体は簡単ですが、データの性質を見極め、適切なモデルを選択することが研究の質を決定づけます。本記事を参考に、正しいステップで分析を実施してください。統計解析に不安がある方は、ぜひ弊社のZoomコンサルティングの活用もご検討ください。


コメント