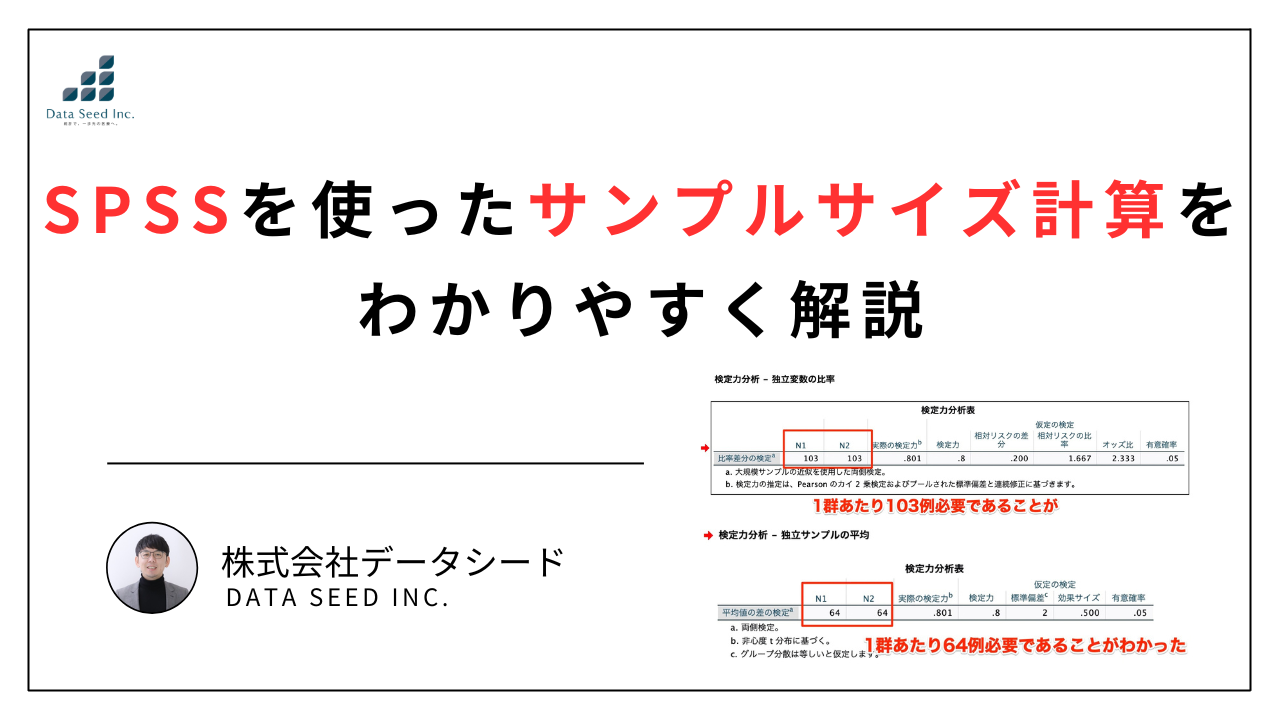
研究や調査、実験を計画する際、多くの研究者が悩むことは「サンプルサイズ計算(必要例数の算出)」です。
「いったい何人のデータを集めれば、意味のある統計結果が得られるのだろうか?」と悩んだ経験がある方も多いのではないでしょうか。
サンプルサイズが小さすぎると、本当はグループ間に差があるのに「差がない」という誤った結論(第二種の過誤)を導いてしまうリスクが高まります。これを統計学的には「検出力(検定力)が不足している」と言います。
一方で、無駄に多すぎるサンプルサイズを設定してしまうと、データ収集にかかる時間、労力、そして金銭的なコストが膨大になり、倫理的にも望ましくありません。
適切なサンプルサイズを事前に算出することは、研究の信頼性を担保し、プロジェクトを成功に導くための最重要ステップの一つです。しかし、手計算でこれらの数値を割り出すのは非常に複雑で手間がかかります。
本記事では、実際のSPSSの画面操作に沿って、研究現場で最も頻繁に用いられる「連続変数の2群比較(t検定)」と「カテゴリカル変数の2群比較(カイ二乗検定)」におけるサンプルサイズ計算の具体的な手順を詳しく解説します。
サンプルサイズ計算とは?
具体的な操作手順に入る前に、そもそも「サンプルサイズ計算」とは何か、その前提となる基本的な考え方について解説します。
サンプルサイズ計算とは、設定した仮説を検証するために「最低限必要なデータ数(対象者数や標本数)」を統計学的な根拠に基づいて割り出す作業のことです。
この計算を行うためには、事前に以下の4つの重要なパラメータ(指標)を決定しておく必要があります。これらの関係性を理解することが、適切な分析を行うための第一歩となります。
- 有意水準(αエラーの確率) 本当は差がないのに、誤って「差がある」と判断してしまう確率です。一般的には「0.05(5%)」が用いられます。これは「100回に5回は偶然によって差があるように見えてしまうリスクを許容する」という意味になります。
- 検出力(検定力 / 1 – βエラーの確率) 本当は差があるときに、正しく「差がある」と見抜くことができる確率です。研究計画においては、一般的に「0.8(80%)」以上が目安とされています。検出力が低いと、せっかく苦労してデータを集めても「有意差なし」という結果に終わる可能性が高くなります。
- 効果量(エフェクトサイズ) 比較するグループ間に、どの程度の「差の大きさ」や「関連の強さ」があるかを示す指標です。過去の先行研究のデータや、予備実験(パイロットスタディ)の結果から推定することが一般的です。
- サンプルサイズ(標本サイズ) 今回求めたい値です。上記3つの値(有意水準、検出力、効果量)が決定すれば、数学的な計算によって必要なサンプルサイズが自動的に導き出されます。
SPSSでは、これらの指標のうち「求めたい指標(今回はサンプルサイズ)」をターゲットに設定し、残りの数値を入力することで、瞬時に結果を算出してくれます。それでは、実際のSPSSの操作手順を見ていきましょう。
連続変数の2群比較に対するサンプルサイズ計算(t検定ベース)
まずは、身長や体重、テストの点数など、連続的な数値データを持つ2つのグループ(例:新薬投与群とプラセボ群)の平均値を比較する場合の計算方法です。このケースでは「t検定(独立したサンプルのt検定)」をベースにしたサンプルサイズ計算を行います。
t検定ベースでのサンプルサイズ計算:SPSSでの具体的な操作手順
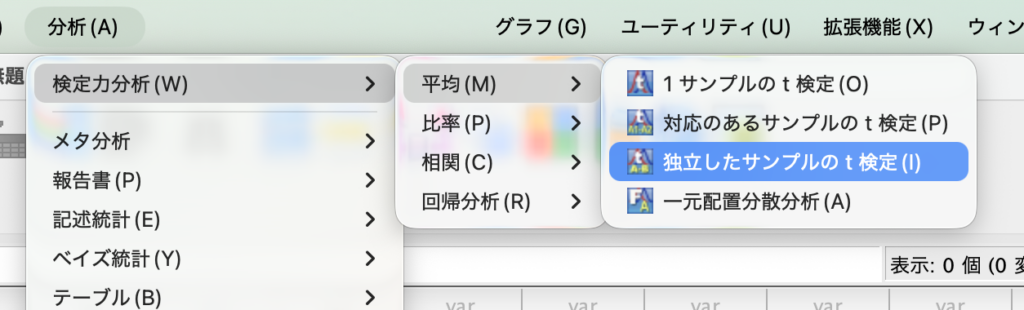
メニューの選択: SPSSの上部メニューから「分析」をクリックし、「検定力分析」>「平均」>「独立したサンプルのt検定」の順に選択してダイアログを開きます。
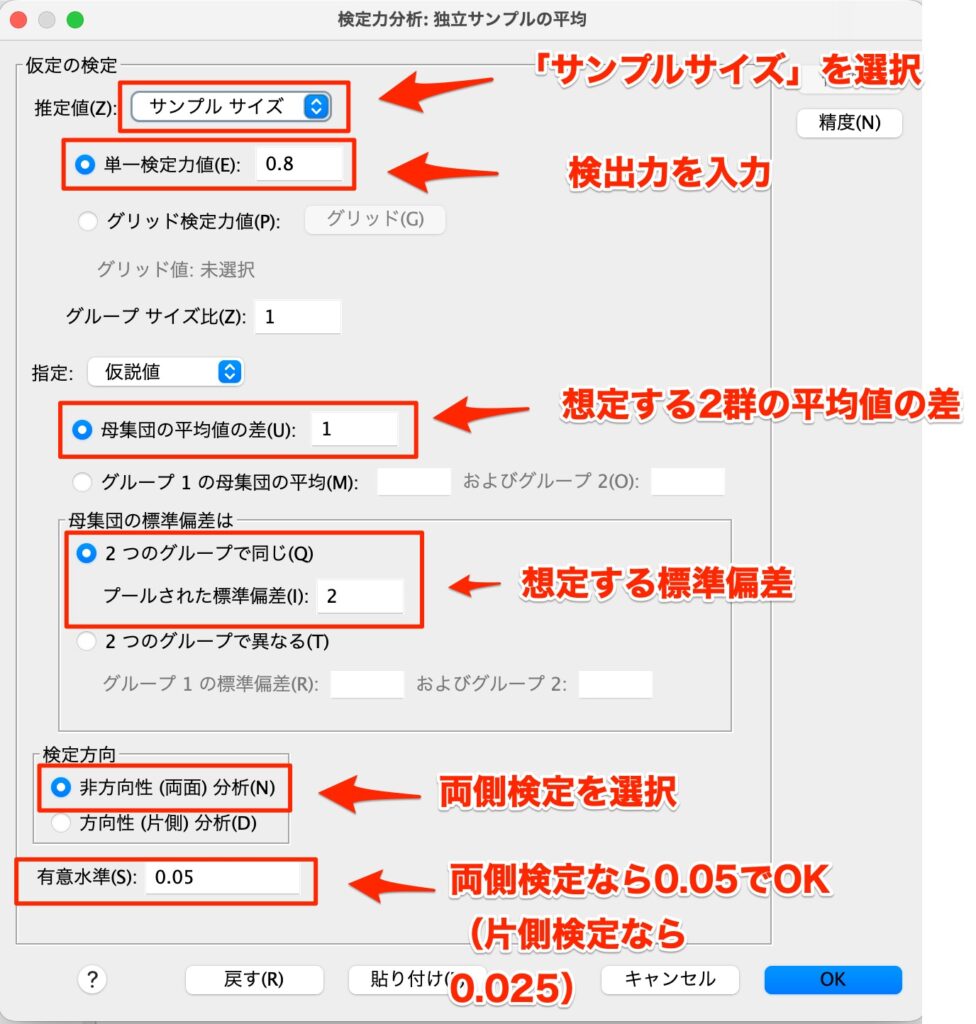
- 推定値の設定: 今回求めるのは必要なデータ数ですので、推定値は「サンプルサイズ」を選択します。
- 検定力の設定: 単一検定力値が「検出力」を意味します。今回は一般的な基準である「0.8(80%)」を入力します。
- 平均値の差の設定: 「母集団の平均値の差」には、想定する2群の平均値の差を入力します。今回の例では「1」を入力しています。
- 標準偏差の設定: 「母集団の標準偏差」は、2つのグループで同じばらつきであることを想定し、標準偏差を「2」として入力します。
- 検定の方向と有意水準: 検定は「両側検定」を選択します。両側検定であれば、有意水準は標準的な「0.05」のままでOKです。
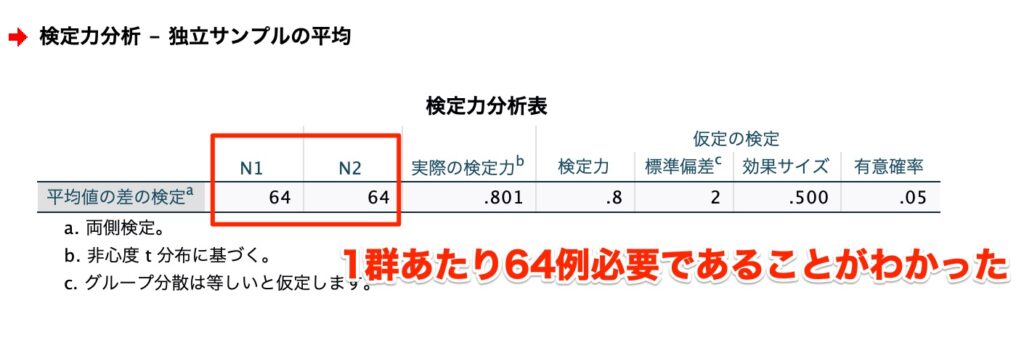
すべての設定を終えて計算を実行すると、結果として「1群あたり64例」が必要であることが示されます。2つのグループを比較するため、合計で「128例」のサンプルサイズが必要であることがわかりました。
カテゴリカル変数の2群比較に対するサンプルサイズ計算(カイ二乗検定ベース)
次に、「はい/いいえ」や「治癒した/治癒しなかった」などのように、カテゴリに分類されるデータ(名義尺度)の割合を2グループ間で比較する場合の計算方法です。
このケースでは「カイ二乗検定」をベースにしたサンプルサイズ計算を行います。
カイ二乗検定ベースのサンプルサイズ計算:SPSSでの具体的な操作手順
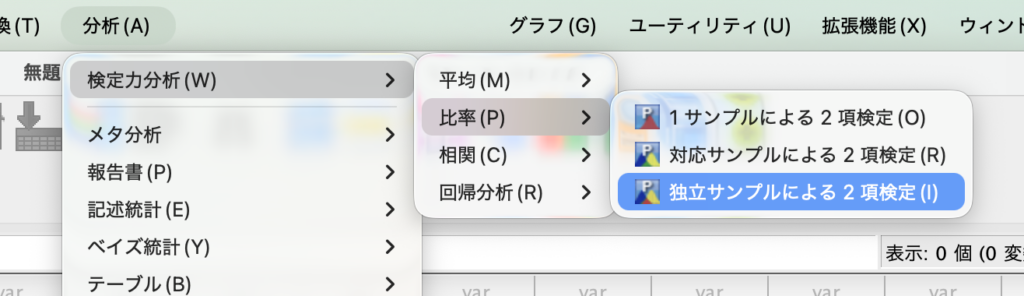
メニューの選択: SPSSの上部メニューから「分析」をクリックし、「検定力分析」>「比率」>「独立サンプルによる二項検定」の順に選択します。
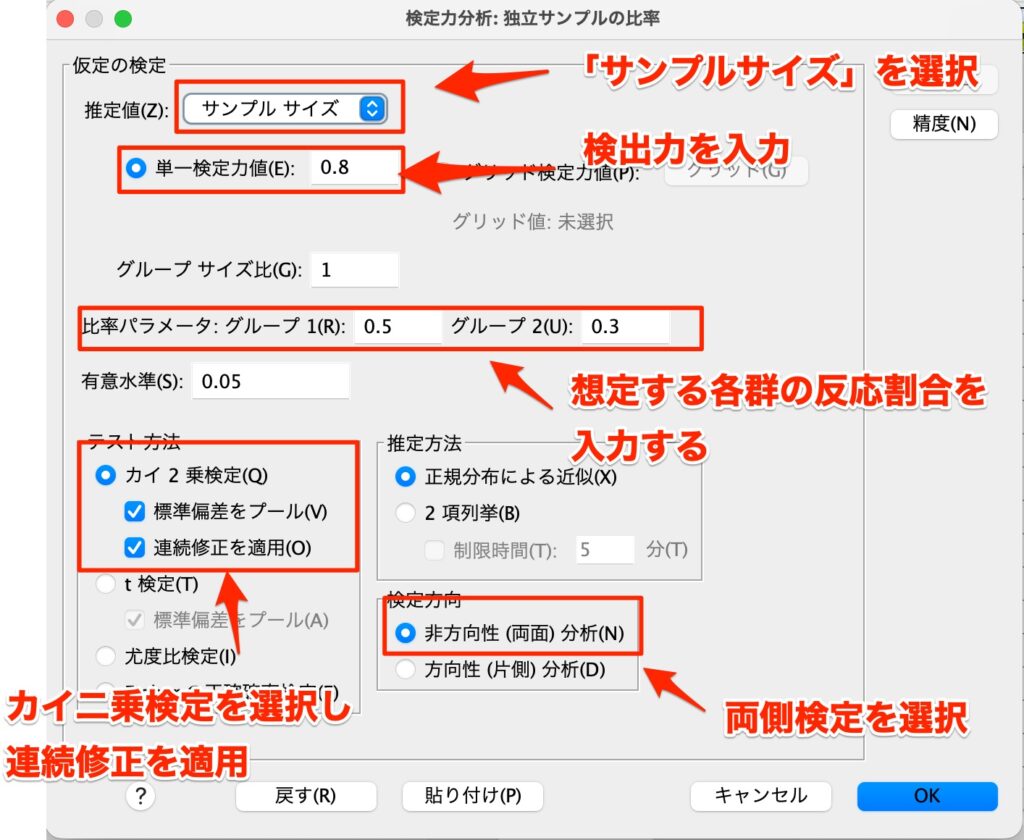
- 推定値の設定: 先ほどと同様に、推定値は「サンプルサイズ」を選択します。
- 検定力の設定: 単一検定力値(検出力)には「0.8(80%)」を入力します。
- 比率パラメータの設定: 比率パラメータの項目には、先行研究などから想定される「各群の反応割合」を入力します。
- 検定手法の詳細設定: 手法として「カイ二乗検定」を選択し、「連続修正を適用する」にチェックを入れて設定します。
- 検定の方向と有意水準: 検定は「両側検定」を選択し、有意水準は「0.05」でOKです。
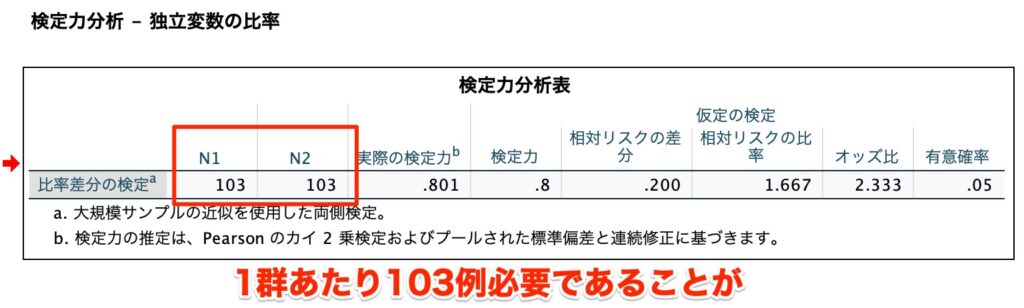
これらの条件で計算を実行すると、結果として「1群あたり103例」が必要であることが算出されます。
したがって、2グループ合計で「206例」のサンプルサイズを集める必要があることがわかりました。
相関係数に対するサンプルサイズ計算
ピアソンの相関係数に対するサンプルサイズ計算
まずは、ピアソンの相関係数に対するサンプルサイズ計算をしていきます。
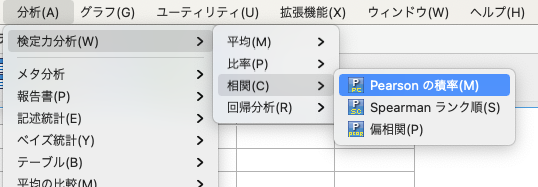
SPSSを立ち上げて、「分析 > 検定力分析 > 相関 > Pearsonの積率」を選択します。
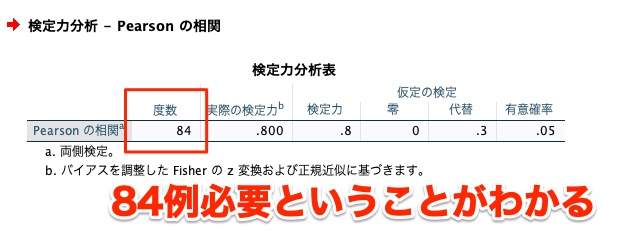
すると以下の画面になりますので、「単一べき乗値」に検出力を、「Pearsonの相関パラメータ」に期待する相関係数を入力します。
(今回は仮に0.3の相関係数を期待するとします。)

OKを押すと、結果として84例必要であるという計算結果が示されました。
スピアマンの相関係数に対するサンプルサイズ計算
次に、スピアマンの相関係数に対するサンプルサイズ計算をしていきます。
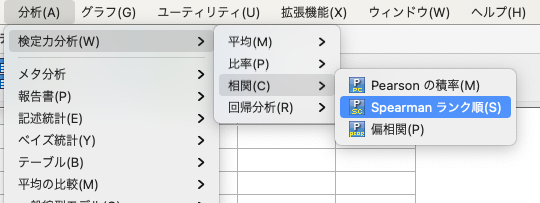
SPSSを立ち上げて、「分析 > 検定力分析 > 相関 > Spearmanランク順」を選択します。
すると以下の画面になりますので、「単一べき乗値」に検出力を、「Spearmanの相関パラメータ」に期待する相関係数を入力します。
(今回は仮に0.3の相関係数を期待するとします。)

OKを押すと、結果として89例必要であるという計算結果が示されました。

サンプルサイズ計算でお悩みの方へ
ここまでSPSSを使った基本的なサンプルサイズ計算の手順を解説してきました。ツールの操作自体は非常にシンプルであることがお分かりいただけたかと思います。
しかし、実際の研究現場では
- 「先行研究が少なく、効果量(平均値の差や反応割合)をいくつに設定していいか分からない」
- 「自分の研究テーマの場合、t検定やカイ二乗検定以外のどのような統計手法や研究デザインを選択すべきか迷っている」
- 「算出したサンプルサイズを集めるのが現実的に難しい場合、どう対処すればいいのか」
といった、ツール操作以前の「設計上の悩み」に直面することが多々あります。
誤った前提条件でサンプルサイズを計算してしまうと、研究そのものの信頼性が揺らいでしまう可能性があります。
弊社では、こうした研究デザインや統計解析に関するお悩みを解決するため、専門家による「Zoomコンサルティング」を実施しております。 「どういう研究設計にすればいいのか?」といった根本的なご相談から、具体的なSPSSのパラメータ設定の妥当性まで、あなたのご研究の状況に合わせた個別のアドバイスが可能です。
研究をスムーズに、そして確実に進めるために、よろしければZoomコンサルをご検討ください。
▶︎ Zoomコンサルティングの詳細・お申し込みは下記のページをご覧ください。
まとめ
本記事では、「SPSS サンプルサイズ計算.pdf」の資料をもとに、SPSSを活用したサンプルサイズ計算の具体的な手順について解説しました。
- 連続変数の比較(t検定)では、平均値の差と標準偏差から計算を行います。
- カテゴリカル変数の比較(カイ二乗検定)では、各グループの想定される反応割合から計算を行います。
サンプルサイズ計算は、研究や調査のスタートラインとなる非常に重要なプロセスです。行き当たりばったりでデータを集めるのではなく、事前にしっかりと検定力分析を行うことで、科学的に信頼性の高い、説得力のある結果を導き出すことができます。
SPSSの機能を最大限に活用し、無駄のない適切な研究計画を立てて、皆様のプロジェクトを成功へと繋げてください。もし途中でつまずいたり、デザイン設計に不安を感じたりした場合は、一人で悩まずにぜひ専門家のサポートもご活用ください。

コメント